VictoriaMetrics
검토 기준: VictoriaMetrics 1.151.0 · stack chart 0.92.1 마지막 업데이트: 2026년 9월 12일
목차
소개
VictoriaMetrics는 시계열을 저장·조회하며 수집용 vmagent, 규칙 평가용 vmalert를 별도로 제공합니다. Prometheus remote write와 Prometheus 호환 query endpoint를 지원하지만 MetricsQL에는 PromQL과 의도적인 차이가 있습니다. 마이그레이션에서는 실제 쿼리와 데이터를 대조하며 모든 Prometheus API·계산 결과가 동일하다고 가정하지 않습니다.
검토 기준은 VictoriaMetrics 1.151.0, victoria-metrics-k8s-stack 0.92.1입니다. 작은 로컬 데이터로 native 쿼리를 확인하고 manifest·chart를 검사·렌더링했습니다. 실제 EKS 배포, 클라우드 백업, 부하·장애 복구 시험을 수행했다는 의미는 아닙니다.
비교와 측정
| 항목 | 비교할 조건 |
|---|---|
| 배포 | Prometheus는 scraping·로컬 TSDB·규칙 평가를 결합합니다. VictoriaMetrics의 단일 노드 저장·조회와 선택적 agent는 분리할 수 있으며 cluster는 insert/storage/select를 나눕니다. |
| 압축·속도 | 같은 데이터·수집률·churn·query 범위·cache 상태·hardware로 측정합니다. 모든 workload에 7배 압축·20배 속도·70% 비용 절감을 보장하지 않습니다. |
| 카디널리티 | 활성 series·churn·label·query fan-out·RAM·disk에 따라 용량이 달라집니다. 두 제품에 보편적인 10M 대 100M series 경계가 있는 것은 아닙니다. |
| 보존 | Prometheus의 기본 보존 기간은 최대값이 아닙니다. VictoriaMetrics도 보존 기간을 설정할 수 있지만 유한한 저장 공간이 필요합니다. |
| 쿼리 언어 | 익숙한 PromQL 표현식을 많이 지원하되 rate/increase·NaN·scalar·metric 이름 처리 차이를 확인합니다. |
| Tenant·접근 제어 | Cluster tenant ID는 데이터 이름 공간을 구분합니다. 호출자를 인증하지 않으므로 접근을 제한하고 vmauth 등의 인증·인가 gateway 구성을 검토합니다. |
| 다운샘플링 | Enterprise 저장소 downsampling, 수집 시 stream aggregation, 추가 파생 series를 만드는 recording rule을 구분합니다. |
인용하는 benchmark에는 실제 software version·dataset·측정일을 보존합니다. 출처 없는 비교 수치를 용량 산정 기준으로 쓰지 않습니다.
아키텍처 옵션
| 요구사항 | 설계 판단 |
|---|---|
| 한 서버에 workload가 들어가며 운영 단순성이 중요 | 측정한 용량과 복구 목표를 기준으로 단일 노드를 먼저 평가합니다. |
| 읽기·쓰기·저장소의 독립 확장 또는 한 서버의 한계 초과 | Cluster의 query fan-out·복제 비용·운영 복잡성을 함께 평가합니다. |
| 장애 지속성 | 독립 failure domain·중복 수집·query routing·영속 저장·복원 시험을 설계합니다. 프로세스 두 개나 복제 disk만으로 서비스 HA가 완성되지는 않습니다. |
| 정해진 수집량 | 초당 sample·활성 series·churn·보존·query 부하로 환산합니다. 100M samples/day는 제품의 모드 선택 임계값이 아닙니다. |
독립된 단일 노드 두 개를 쓰려면 write 복제와 query/failover를 명시적으로 구성해야 합니다. 여러 vmsingle 프로세스가 하나의 data directory를 함께 쓰는 것을 HA 대안으로 삼지 않습니다.
단일 노드 모드
단일 저장·조회 프로세스로 운영을 단순화할 수 있지만 수집·알림·HA 전체를 하나의 binary가 해결하는 것은 아닙니다. 용량은 실제 workload를 측정해 결정합니다.
아래 raw manifest와 뒤의 Helm profile은 서로 다른 배포 대안이며 함께 적용하는 순서가 아닙니다. monitoring namespace, Linux EC2 worker와 권한·volume binding이 준비된 기존 gp3 StorageClass/EBS CSI 구성을 전제로 합니다. EKS Auto Mode storage는 별도 provisioner를 쓰므로 Auto Mode·Fargate·Windows·Hybrid Nodes에 같은 class/driver를 가정하지 않습니다. 자원 수치는 예시입니다. Pod endpoint를 신뢰된 호출자로 제한하며 ClusterIP를 인증으로 간주하지 않습니다.
StatefulSet 배포
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: vmsingle
  namespace: monitoring
spec:
  serviceName: vmsingle
  replicas: 1
  selector:
    matchLabels:
      app: vmsingle
  template:
    metadata:
      labels:
        app: vmsingle
    spec:
      containers:
      - name: vmsingle
        image: victoriametrics/victoria-metrics:v1.151.0
        args:
        - --storageDataPath=/storage
        - --httpListenAddr=:8428
        - --retentionPeriod=1y
        - --search.latencyOffset=30s
        - --search.maxUniqueTimeseries=1000000
        - --search.maxSamplesPerQuery=1000000000
        - --memory.allowedPercent=60
        ports:
        - containerPort: 8428
          name: http
        resources:
          requests:
            cpu: 500m
            memory: 2Gi
          limits:
            cpu: 2000m
            memory: 8Gi
        volumeMounts:
        - name: storage
          mountPath: /storage
        livenessProbe:
          httpGet:
            path: /health
            port: 8428
          initialDelaySeconds: 30
          periodSeconds: 30
        readinessProbe:
          httpGet:
            path: /health
            port: 8428
          initialDelaySeconds: 5
          periodSeconds: 15
      securityContext:
        fsGroup: 65534
        runAsNonRoot: true
        runAsUser: 65534
  volumeClaimTemplates:
  - metadata:
      name: storage
    spec:
      accessModes:
      - ReadWriteOnce
      storageClassName: gp3
      resources:
        requests:
          storage: 100Gi
---
apiVersion: v1
kind: Service
metadata:
  name: vmsingle
  namespace: monitoring
spec:
  selector:
    app: vmsingle
  ports:
  - port: 8428
    targetPort: 8428
    name: http
  type: ClusterIP
주요 엔드포인트
| 엔드포인트 | 설명 |
|---|---|
/api/v1/write | Prometheus Remote Write |
/api/v1/query | 인스턴트 쿼리 |
/api/v1/query_range | 범위 쿼리 |
/api/v1/series | 시리즈 메타데이터 |
/api/v1/labels | 레이블 목록 |
/api/v1/label/{name}/values | 레이블 값 목록 |
/vmui | 내장 UI |
/metrics | 자체 메트릭 |
클러스터 모드
대규모 환경을 위한 확장 가능한 클러스터 구성입니다.
아키텍처
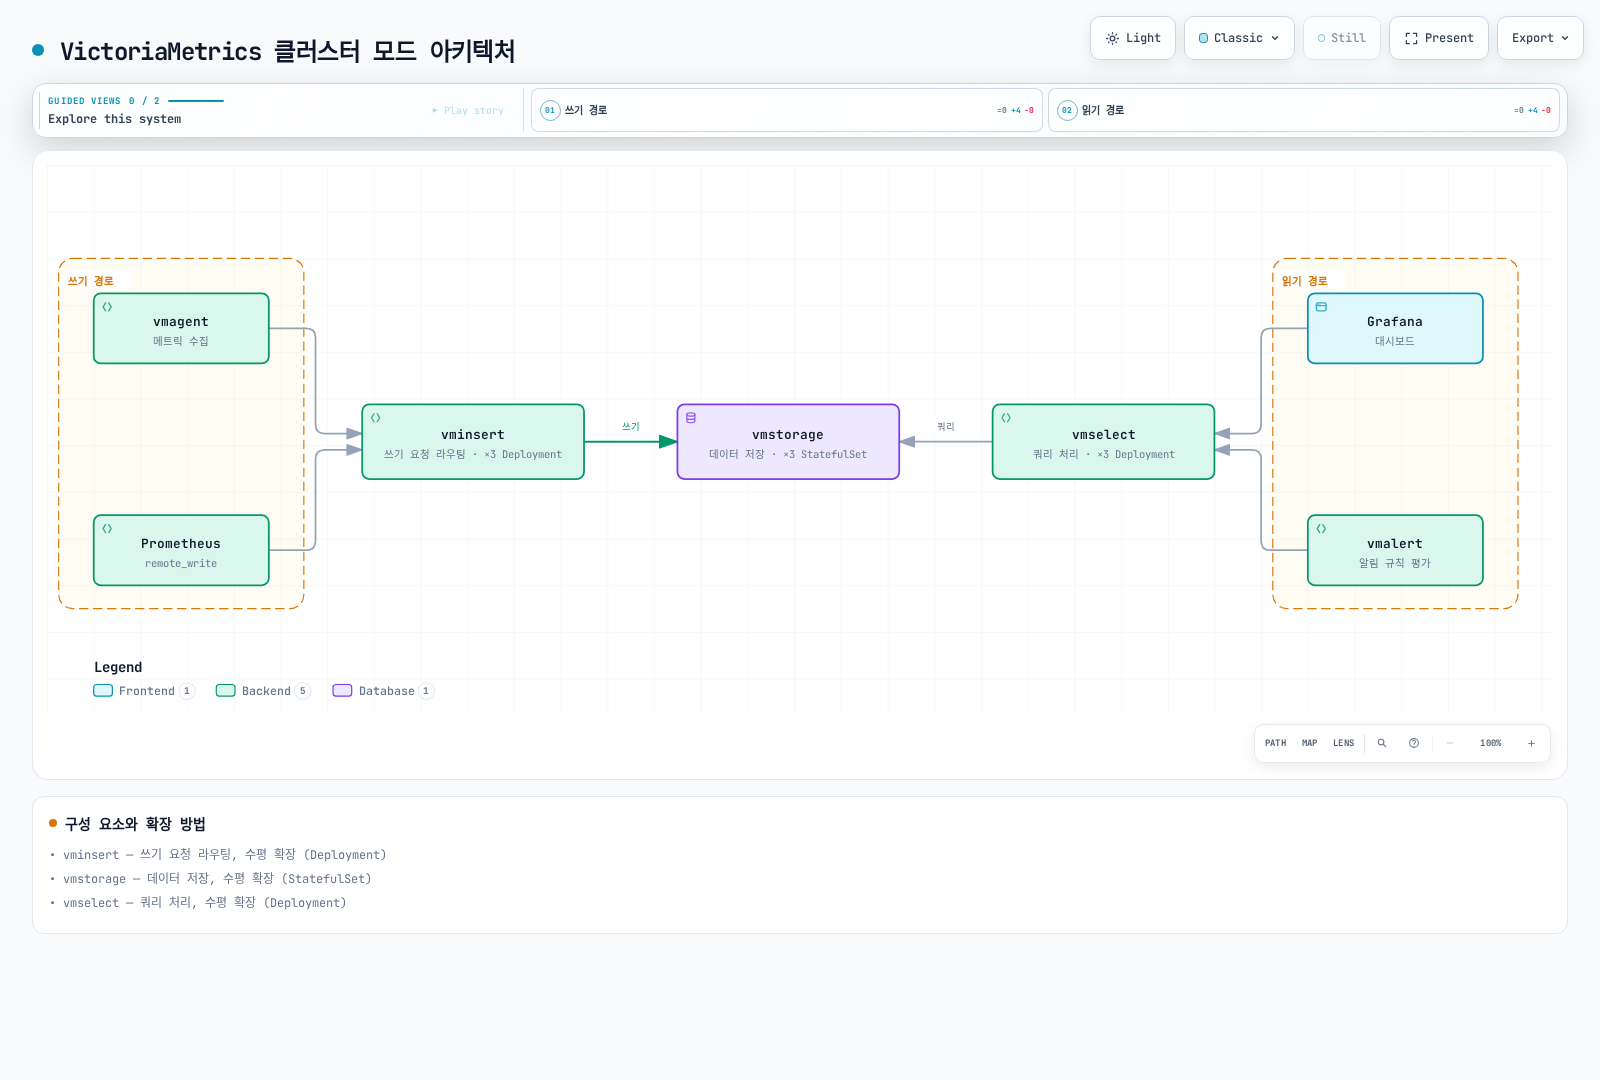
구성 요소
| 구성 요소 | 역할 | 확장 방법 |
|---|---|---|
| vminsert | 쓰기 요청 라우팅 | 수평 확장 (Deployment) |
| vmstorage | 데이터 저장 | 수평 확장 (StatefulSet) |
| vmselect | 쿼리 처리 | 수평 확장 (Deployment) |
화살표는 응답이 아닌 요청 경로입니다. raw 예제의 replica 3개는 구성 선택이며 보편적인 최소값·가용성 보장이 아닙니다. 각 storage member는 별도 PVC를 쓰며 hard node anti-affinity에는 배치 가능한 Kubernetes node가 최소 3개 필요합니다.
vminsert -replicationFactor=2는 복사본 두 개를 요청합니다. 조회할 데이터가 실제 해당 replication factor로 기록됐을 때 vmselect도 일치시킵니다. Flag를 늘려도 과거 데이터가 자동 복제되지는 않습니다. Storage 장애 시 vmselect는 partial response를 반환할 수 있습니다. -search.denyPartialResponse는 partial로 분류된 응답을 거부하지만 replica 수 설정 자체가 이 분류에 영향을 줍니다. 복제본이 부족했던 쓰기·이전 데이터·다중 장애는 따로 검증합니다.
1ms dedup은 같은 timestamp의 복제본 처리를 위한 설정이며 vmstorage와 vmselect에서 일치시킵니다. 서로 다른 시점에 수집하는 HA scraper는 식별 label과 interval을 별도로 설계합니다. 30s이면 구간마다 sample 하나만 남겨 유효한 고해상도 sample도 사라질 수 있습니다. 압축 옵션이 아닙니다. Vmstorage를 늘려도 새 쓰기가 재분배될 뿐 과거 데이터가 모두 자동 이동하지는 않습니다.
vmstorage 배포
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: vmstorage
  namespace: monitoring
spec:
  serviceName: vmstorage
  replicas: 3
  selector:
    matchLabels:
      app: vmstorage
  template:
    metadata:
      labels:
        app: vmstorage
    spec:
      containers:
      - name: vmstorage
        image: victoriametrics/vmstorage:v1.151.0-cluster
        args:
        - --storageDataPath=/storage
        - --httpListenAddr=:8482
        - --vminsertAddr=:8400
        - --vmselectAddr=:8401
        - --retentionPeriod=1y
        - --dedup.minScrapeInterval=1ms
        ports:
        - containerPort: 8482
          name: http
        - containerPort: 8400
          name: vminsert
        - containerPort: 8401
          name: vmselect
        resources:
          requests:
            cpu: 500m
            memory: 2Gi
          limits:
            cpu: 2000m
            memory: 8Gi
        volumeMounts:
        - name: storage
          mountPath: /storage
        livenessProbe:
          httpGet:
            path: /health
            port: 8482
          initialDelaySeconds: 30
          periodSeconds: 30
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchLabels:
                app: vmstorage
            topologyKey: kubernetes.io/hostname
  volumeClaimTemplates:
  - metadata:
      name: storage
    spec:
      accessModes:
      - ReadWriteOnce
      storageClassName: gp3
      resources:
        requests:
          storage: 100Gi
---
apiVersion: v1
kind: Service
metadata:
  name: vmstorage
  namespace: monitoring
spec:
  selector:
    app: vmstorage
  clusterIP: None
  ports:
  - port: 8482
    name: http
  - port: 8400
    name: vminsert
  - port: 8401
    name: vmselect
vminsert 배포
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vminsert
  namespace: monitoring
spec:
  replicas: 3
  selector:
    matchLabels:
      app: vminsert
  template:
    metadata:
      labels:
        app: vminsert
    spec:
      containers:
      - name: vminsert
        image: victoriametrics/vminsert:v1.151.0-cluster
        args:
          - "--httpListenAddr=:8480"
          - "--storageNode=vmstorage-0.vmstorage:8400"
          - "--storageNode=vmstorage-1.vmstorage:8400"
          - "--storageNode=vmstorage-2.vmstorage:8400"
          - "--replicationFactor=2"
        ports:
        - containerPort: 8480
          name: http
        resources:
          requests:
            cpu: 200m
            memory: 256Mi
          limits:
            cpu: 1000m
            memory: 1Gi
        livenessProbe:
          httpGet:
            path: /health
            port: 8480
          initialDelaySeconds: 10
          periodSeconds: 30
---
apiVersion: v1
kind: Service
metadata:
  name: vminsert
  namespace: monitoring
spec:
  selector:
    app: vminsert
  ports:
  - port: 8480
    targetPort: 8480
    name: http
  type: ClusterIP
vmselect 배포
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vmselect
  namespace: monitoring
spec:
  replicas: 3
  selector:
    matchLabels:
      app: vmselect
  template:
    metadata:
      labels:
        app: vmselect
    spec:
      containers:
      - name: vmselect
        image: victoriametrics/vmselect:v1.151.0-cluster
        args:
        - --httpListenAddr=:8481
        - --storageNode=vmstorage-0.vmstorage:8401
        - --storageNode=vmstorage-1.vmstorage:8401
        - --storageNode=vmstorage-2.vmstorage:8401
        - --search.maxUniqueTimeseries=1000000
        - --search.maxSamplesPerQuery=1000000000
        - --replicationFactor=2
        - --dedup.minScrapeInterval=1ms
        - --search.denyPartialResponse
        ports:
        - containerPort: 8481
          name: http
        resources:
          requests:
            cpu: 200m
            memory: 512Mi
          limits:
            cpu: 1000m
            memory: 2Gi
        livenessProbe:
          httpGet:
            path: /health
            port: 8481
          initialDelaySeconds: 10
          periodSeconds: 30
---
apiVersion: v1
kind: Service
metadata:
  name: vmselect
  namespace: monitoring
spec:
  selector:
    app: vmselect
  ports:
  - port: 8481
    targetPort: 8481
    name: http
  type: ClusterIP
vmagent
vmagent는 메트릭 수집 및 전달을 위한 경량 에이전트입니다.
주요 기능
- Prometheus scrape 설정 호환
- 여러 Remote Write 대상 지원
- 데이터 버퍼링 및 재전송
- 낮은 리소스 사용량
- 레이블 재작성 및 필터링
배포
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vmagent
  namespace: monitoring
spec:
  replicas: 1
  selector:
    matchLabels:
      app: vmagent
  template:
    metadata:
      labels:
        app: vmagent
    spec:
      serviceAccountName: vmagent
      containers:
      - name: vmagent
        image: victoriametrics/vmagent:v1.151.0
        args:
        - --promscrape.config=/etc/vmagent/prometheus.yml
        - --remoteWrite.url=http://vminsert:8480/insert/0/prometheus/api/v1/write
        - --remoteWrite.tmpDataPath=/tmp/vmagent-remotewrite-data
        - --remoteWrite.maxDiskUsagePerURL=1GB
        ports:
        - containerPort: 8429
          name: http
        resources:
          requests:
            cpu: 100m
            memory: 256Mi
          limits:
            cpu: 500m
            memory: 1Gi
        volumeMounts:
        - name: config
          mountPath: /etc/vmagent
        - name: tmpdata
          mountPath: /tmp/vmagent-remotewrite-data
      volumes:
      - name: config
        configMap:
          name: vmagent-config
      - name: tmpdata
        emptyDir:
          sizeLimit: 2Gi
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: vmagent-config
  namespace: monitoring
data:
  prometheus.yml: "global:\n  scrape_interval: 30s\n  scrape_timeout: 10s\nscrape_configs:\n- job_name: kubernetes-pods\n  kubernetes_sd_configs:\n  - role: pod\n    namespaces:\n      names:\n      - example-app\n  relabel_configs:\n  - source_labels:\n    - __meta_kubernetes_pod_phase\n    action: keep\n    regex: Running\n  - source_labels:\n    - __meta_kubernetes_pod_container_port_protocol\n    action: keep\n    regex: TCP\n  - source_labels:\n    - __meta_kubernetes_pod_container_port_name\n    action: keep\n    regex: metrics\n  - source_labels:\n    - __meta_kubernetes_pod_annotation_prometheus_io_scrape\n    action: keep\n    regex: 'true'\n  - source_labels:\n    - __meta_kubernetes_pod_annotation_prometheus_io_path\n    action: replace\n    regex: (/.*)\n    target_label: __metrics_path__\n  - source_labels:\n    - __meta_kubernetes_namespace\n    target_label: namespace\n  - source_labels:\n    - __meta_kubernetes_pod_name\n    target_label: pod\n"
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: vmagent
  namespace: monitoring
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: vmagent-pod-discovery
  namespace: example-app
rules:
- apiGroups:
  - ''
  resources:
  - pods
  verbs:
  - get
  - list
  - watch
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: vmagent-pod-discovery
  namespace: example-app
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: vmagent-pod-discovery
subjects:
- kind: ServiceAccount
  name: vmagent
  namespace: monitoring
이 최소 agent는 기존 example-app namespace에서 Running 상태이며 이름이 metrics인 TCP port와 prometheus.io/scrape: "true" annotation을 가진 Pod만 수집합니다. Discovery가 제공하는 IPv4/IPv6 주소를 쓰며 colon을 분리해 다시 만들지 않습니다. Namespace Role도 Pod 조회만 허용합니다. Node/kubelet 수집에는 별도 최소 RBAC와 검증 가능한 serving certificate가 필요하며 예제 동작을 위해 TLS 검증을 끄거나 nodes/proxy를 부여하지 않습니다.
선택적 prometheus.io/path annotation이 /로 시작하면 경로에 반영하며, 없으면 /metrics를 사용합니다.
예제 queue는 emptyDir이므로 같은 Pod의 container 재시작에는 남지만 Pod 삭제·교체에는 남지 않습니다. remoteWrite.maxDiskUsagePerURL에 도달하면 가장 오래된 queue 데이터가 삭제됩니다. 영속 buffer는 검토한 PVC/StatefulSet 또는 operator 구성으로 만들고 URL별 queue 용량·재시도·drop·여유 공간을 감시합니다. Queue는 백업이나 무손실 전달 보장이 아닙니다.
vmagent 샤딩
모든 member는 같은 discovery/relabel 설정과 0부터 membersCount-1까지의 서로 다른 안정적인 ordinal이 필요합니다. vmagent-0처럼 ordinal로 끝나는 StatefulSet Pod 이름도 허용됩니다. Deployment의 임의 Pod 이름은 안정적인 shard 번호가 아닙니다. 위 replica 1개 예제에는 sharding flag를 넣지 않았습니다. 다음은 인자 참고이며 별도 배포 manifest가 아닙니다. Scrape 복제와 storage 복제는 다르며 중복 scrape에는 적절한 dedup이 필요합니다.
args:
  - "--promscrape.cluster.membersCount=3"    # 총 vmagent 수
  - "--promscrape.cluster.memberNum=0"       # 현재 인스턴스 번호 (0, 1, 2)
  - "--promscrape.cluster.replicationFactor=2"  # 각 대상을 몇 개 인스턴스가 스크랩
vmalert
vmalert는 알림 규칙을 평가하고 알림을 생성하는 구성 요소입니다.
배포
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vmalert
  namespace: monitoring
spec:
  replicas: 1
  selector:
    matchLabels:
      app: vmalert
  template:
    metadata:
      labels:
        app: vmalert
    spec:
      containers:
      - name: vmalert
        image: victoriametrics/vmalert:v1.151.0
        args:
        - --datasource.url=http://vmselect:8481/select/0/prometheus
        - --remoteRead.url=http://vmselect:8481/select/0/prometheus
        - --remoteWrite.url=http://vminsert:8480/insert/0/prometheus
        - --notifier.url=http://alertmanager:9093
        - --rule=/etc/vmalert/rules/*.yaml
        - --evaluationInterval=30s
        - --external.url=http://vmalert:8880
        - --external.label=cluster=production
        ports:
        - containerPort: 8880
          name: http
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
          limits:
            cpu: 500m
            memory: 512Mi
        volumeMounts:
        - name: rules
          mountPath: /etc/vmalert/rules
        livenessProbe:
          httpGet:
            path: /health
            port: 8880
          initialDelaySeconds: 10
          periodSeconds: 30
      volumes:
      - name: rules
        configMap:
          name: vmalert-rules
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: vmalert-rules
  namespace: monitoring
data:
  kubernetes.yaml: "groups:\n- name: kubernetes\n  interval: 30s\n  rules:\n  - alert: NodeMemoryHigh\n    expr: '(node_memory_MemTotal_bytes - node_memory_MemAvailable_bytes)\n\n      / node_memory_MemTotal_bytes * 100 > 90\n\n      '\n    for: 5m\n    labels:\n      severity: warning\n    annotations:\n      summary: High memory usage on {{ $labels.instance }}\n      description: Memory usage is {{ printf \"%.2f\" $value }}%\n  - alert: PodRestartsHigh\n    expr: increase(kube_pod_container_status_restarts_total[1h]) > 5\n    for: 10m\n    labels:\n      severity: warning\n    annotations:\n      summary: 'Frequent restarts: {{ $labels.namespace }}/{{ $labels.pod }}'\n      description: Pod has restarted {{ $value }} times in the last hour\n- name: recording-rules\n  interval: 30s\n  rules:\n  - record: instance:node_cpu_utilization:ratio_rate5m\n    expr: 1 - avg by (instance) (rate(node_cpu_seconds_total{mode=\"idle\"}[5m]))\n  - record: instance:node_memory_utilization:ratio\n    expr:\
    \ '1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes\n\n      '\n"
규칙은 node-exporter와 kube-state-metrics가 이미 수집되고 있다고 가정합니다. 앞의 최소 application-Pod discovery가 이를 설치하지는 않습니다. 재시작 횟수만으로 CrashLoopBackOff를 증명할 수 없어 이름을 PodRestartsHigh로 정했습니다. CPU 기록은 누적 counter 평균이 아니라 rate를 계산한 ratio입니다.
datasource.url·remoteRead.url은 query API base를, remoteWrite.url은 recording/alert-state series를 보존할 write base를 사용합니다. remoteRead라는 flag 이름이 모든 Prometheus Remote Read protocol 지원을 뜻하지는 않습니다. Alertmanager가 별도로 존재하고 접근 가능해야 하며 알림 routing도 별도입니다. Evaluator HA에는 external label·알림 중복 제거·alert state 복원 동작을 검토합니다.
MetricsQL
MetricsQL은 익숙한 PromQL 구문을 지원하지만 의도적인 의미 차이가 있습니다. rate·increase는 lookbehind window 직전의 raw sample을 고려할 수 있고 Prometheus와 같은 방식으로 외삽하지 않습니다. NaN point를 제거하며 scalar/instant-vector·metric 이름 처리도 다를 수 있습니다. 마이그레이션 시 알고 있는 입력 데이터로 dashboard·alert·recording rule 결과를 대조합니다. Query 언어의 호환성이 모든 Prometheus API의 동일한 지원을 뜻하지는 않습니다.
PromQL 형태의 쿼리
rate(http_requests_total[5m])
sum by (service) (rate(http_requests_total[5m]))
histogram_quantile(0.95, sum by (service, le) (rate(http_request_duration_seconds_bucket[5m])))
Histogram rate를 원하는 식별 label과 **le**로 집계한 뒤 quantile을 계산합니다. 이미 계산된 quantile끼리 다시 quantile을 내는 것은 전체 요청의 quantile이 아닙니다.
MetricsQL 확장 기능
아래 audit_gauge는 작은 합성 gauge이며 exporter에 자동으로 존재하는 metric이 아닙니다.
rate(http_requests_total)
keep_last_value(up)
missing_metric default 0
label_set(up, "env", "demo")
label_del(up, "instance")
label_copy(up, "instance", "node")
label_move(up, "instance", "node")
label_join(up, "dst", "-", "job", "instance")
label_transform(up, "job", "api", "frontend")
union(up{job="api"}, up{job="web"})
lag(audit_gauge[2m])
lifetime(audit_gauge[2m])
scrape_interval(audit_gauge[2m])
range_avg(audit_gauge)
range_max(audit_gauge)
range_min(audit_gauge)
range_sum(audit_gauge)
range_first(audit_gauge)
range_last(audit_gauge)
rollup(audit_gauge[2m])
rollup_rate(http_requests_total[5m])
rollup_delta(audit_gauge[2m])
zscore_over_time(audit_gauge[2m])| 함수·연산자 | 실제 의미와 범위 |
|---|---|
rate(metric) | Window를 생략하면 query step과 관측한 scrape 간격으로 정합니다. 재현 가능한 rule에는 window를 명시합니다. |
keep_last_value(q) | 평가 point의 gap을 이전 값으로 채웁니다. 수집 누락을 숨길 수 있으므로 가용성 alert를 정상으로 보이게 만드는 용도로 쓰지 않습니다. |
q1 default q2 | 대응하는 우변으로 누락 point를 채웁니다. 누락이 0임을 증명하거나 모든 경우 원하는 service label을 생성하거나 무트래픽 ratio에 의미를 부여하지는 않습니다. |
label_set/copy/move/join/transform | Query 결과 label을 수정하며 저장된 과거 데이터를 바꾸지 않습니다. 예제 regex는 job label을 바꾸며 IPv6 주소를 colon으로 분리하지 않습니다. |
label_del | 식별 label을 없애면 결과 series가 충돌할 수 있습니다. 식별자를 합치려면 명시적으로 집계합니다. |
union | Query 결과를 합치며 수치 덧셈이 아닙니다. |
lag(metric[2m]) | Window 안의 마지막 raw sample부터 평가 시각까지의 초 단위 나이이며 두 sample 사이의 간격이 아닙니다. |
lifetime(metric[2m]) | 해당 window 안 첫·마지막 raw sample 사이의 시간이며 저장된 series 전체 수명이 아닙니다. |
scrape_interval(metric[2m]) | Window의 raw sample 간격을 추정하며 scrape 설정 파일을 읽지 않습니다. |
range_avg/max/min/sum/first/last(q) | 선택한 query 범위에서 각 결과 series의 평가 point를 처리합니다. Step·해상도에 영향을 받으며 저장된 전체 이력을 집계하는 함수가 아닙니다. |
rollup, rollup_rate, rollup_delta | min/max/avg 같은 여러 결과를 반환하므로 추가되는 rollup label과 metric type을 고려합니다. |
zscore_over_time | Gauge window의 통계적 z-score이며 보정된 이상 확률이나 0–1 사이의 점수가 아닙니다. anomaly_score는 1.151.0에서 지원하지 않는 함수입니다. |
오류율·누락 데이터·히스토그램
먼저 양쪽에서 status 차원을 같은 방식으로 제거합니다. 분자는 분모 series가 존재하는 service에만 0을 대입하고 분모는 무트래픽을 제외합니다.
(sum by (service) (rate(http_requests_total{status=~"5.."}[5m])) or 0 * sum by (service) (rate(http_requests_total[5m]))) / (sum by (service) (rate(http_requests_total[5m])) > 0)이 fixture는 service로 집계합니다. Cluster·namespace도 service 식별자라면 모든 분자·분모 집계에서 해당 label을 일관되게 유지합니다.
Native 합성 데이터에서 5xx가 없는 정상 service는 0, 전체가 5xx이면 1, 실패 비율 10%이면 0.1입니다. 무트래픽·존재하지 않는 service는 값이 없으므로 traffic과 telemetry 누락을 별도로 감시합니다. Status label을 남긴 채 나누면 5xx 분자가 동일한 5xx 분모와만 매칭돼 실제 오류율 대신 1이 될 수 있습니다. 뒤에 default 0을 붙이는 것으로 이 경우들을 해결할 수 없습니다.
histogram_share(0.5, sum by (service, le) (rate(http_request_duration_seconds_bucket[5m])))
count(up)
count by (job) (up)
위 histogram_share는 최근 window에서 500ms 이하 요청 비중을 추정합니다. Raw cumulative bucket은 counter reset 이후 누적 분포이므로 의미가 다릅니다. count(up)은 선택한 up series만 세며 전체 DB cardinality가 아닙니다. 전체 규모는 범위를 제한한 TSDB/cardinality 진단으로 확인합니다.
Helm 설치
Operator 기반 victoria-metrics-k8s-stack 0.92.1은 최상위 vmsingle, vmcluster, vmagent, vmalert 값을 사용합니다. 별도 victoria-metrics-single·victoria-metrics-cluster chart의 values 경로를 이 stack에 넣어도 해당 저장소를 구성하지 않습니다. Helm은 사용하지 않는 key를 받아들일 수 있으므로 렌더링한 CR을 확인합니다.
고정 archive에는 operator chart 0.67.3 / operator 0.74.1이 들어 있으며 VictoriaMetrics 1.151.0을 구성합니다. Chart의 Kubernetes >=1.25.0-0 조건은 전체 제품·EKS 지원 matrix가 아닙니다. 아래 --kube-version 1.35.0은 렌더링 입력이며 API server 검증 결과가 아닙니다. 실제 지원 EKS 버전·CSI provisioner·기존 operator/CRD 소유권을 설치 전에 확인합니다.
helm repo add vm https://victoriametrics.github.io/helm-charts/
helm repo update vm
helm pull vm/victoria-metrics-k8s-stack --version 0.92.1 --untar --untardir ./vendor
helm template vm-demo ./vendor/victoria-metrics-k8s-stack \
  --namespace monitoring --kube-version 1.35.0 --include-crds \
  -f values-single.yaml > rendered.yaml
values-single.yaml
이 시작 profile은 저장소와 release label이 있는 VMServiceScrape를 선택하는 replica 1개의 agent를 켭니다. 다른 collector·기본 rule·Grafana·알림 서비스는 target·권한·credential 구성이 끝날 때까지 꺼 둡니다. 완전한 cluster monitoring 또는 운영 HA profile이 아닙니다. gp3와 호환 storage provisioning이 이미 있어야 하며 자원 크기는 예시입니다.
fullnameOverride: vm-demo
victoria-metrics-operator:
  crds:
    cleanup:
      enabled: false
  operator:
    disable_prometheus_converter: true
grafana:
  enabled: false
defaultDashboards:
  enabled: false
defaultRules:
  enabled: false
alertmanager:
  enabled: false
vmalert:
  enabled: false
vmsingle:
  enabled: true
  spec:
    retentionPeriod: 90d
    storage:
      storageClassName: gp3
      accessModes:
      - ReadWriteOnce
      resources:
        requests:
          storage: 100Gi
    resources:
      requests:
        cpu: 500m
        memory: 2Gi
      limits:
        cpu: '2'
        memory: 8Gi
vmcluster:
  enabled: false
vmagent:
  enabled: true
  spec:
    replicaCount: 1
    selectAllByDefault: false
    serviceScrapeSelector:
      matchLabels:
        app.kubernetes.io/instance: vm-demo
    resources:
      requests:
        cpu: 100m
        memory: 256Mi
      limits:
        cpu: 500m
        memory: 1Gi
prometheus-node-exporter:
  enabled: false
kube-state-metrics:
  enabled: false
kubelet:
  enabled: false
kubeApiServer:
  enabled: false
kubeControllerManager:
  enabled: false
kubeDns:
  enabled: false
coreDns:
  enabled: false
kubeEtcd:
  enabled: false
kubeScheduler:
  enabled: false
kubeProxy:
enabled: falseserviceScrapeSelector는 application Pod가 아닌 VMServiceScrape의 metadata를 선택합니다. 그 scrape resource가 다시 Service/endpoint를 선택하므로 namespace 선택과 agent RBAC를 함께 맞춥니다. EKS의 node/kubelet/control-plane 수집은 해당 platform에서 제공하는 endpoint만 켜고 TLS를 검증합니다. 관리형 control plane·Auto Mode·Fargate·Windows에서 같은 target을 기대하지 않습니다.
Operator/CRD 소유자를 하나로 정합니다. 예제는 chart의 CRD cleanup hook과 Prometheus resource 변환을 끄지만, 임의의 CRD 삭제가 안전해지는 것은 아닙니다. 별도 관리 operator를 재사용한다면 중복 controller를 설치하지 않도록 chart 구성을 맞춥니다. CRD upgrade도 Helm release upgrade와 따로 검토합니다.
Context·렌더링 객체·권한·기존 리소스를 검토한 뒤 같은 pin과 values로 설치합니다.
helm upgrade --install vm-demo vm/victoria-metrics-k8s-stack \
  --version 0.92.1 --namespace monitoring --create-namespace \
  -f values-single.yaml
Cluster Overlay
새로운 별도 cluster-mode 배포에는 아래 값을 시작 profile 위에 적용합니다. 기존 단일 노드 release에서 switch를 바꾸는 것은 데이터 마이그레이션이 아닙니다. 기존 CR을 끄면 실행 중인 저장소가 제거될 수 있고 PVC/이력이 cluster에 자동 복사되지 않습니다.
vmsingle:
  enabled: false
vmcluster:
  enabled: true
  spec:
    retentionPeriod: 90d
    replicationFactor: 2
    vmstorage:
      replicaCount: 3
      extraArgs:
        dedup.minScrapeInterval: 1ms
      storage:
        volumeClaimTemplate:
          spec:
            storageClassName: gp3
            accessModes:
            - ReadWriteOnce
            resources:
              requests:
                storage: 100Gi
      resources:
        requests:
          cpu: 500m
          memory: 2Gi
        limits:
          cpu: '2'
          memory: 8Gi
    vmselect:
      replicaCount: 2
      extraArgs:
        dedup.minScrapeInterval: 1ms
        search.denyPartialResponse: 'true'
      resources:
        requests:
          cpu: 200m
          memory: 512Mi
        limits:
          cpu: '1'
          memory: 2Gi
      storage:
        volumeClaimTemplate:
          spec:
            storageClassName: gp3
            accessModes:
            - ReadWriteOnce
            resources:
              requests:
                storage: 2Gi
    vminsert:
      replicaCount: 2
      resources:
        requests:
          cpu: 200m
          memory: 256Mi
        limits:
          cpu: '1'
          memory: 1Gi
-f values-single.yaml -f values-cluster.yaml로 렌더링합니다. Native 검사에서 VMCluster·replication factor 2·storage replica 3개·일치하는 1ms dedup·cluster tenant-0 write URL을 확인했습니다. Operator reconciliation, PVC binding, failure-domain 배치와 가용성은 실제 환경에서 검증해야 합니다. Storage 3개는 나머지 조건이 충족될 때 member 하나의 장애 중에도 N=2 복사본을 유지하기 위한 2*N-1 개수 조건을 만족합니다.
Grafana의 Prometheus datasource에는 단일 노드 base 또는 raw cluster의 http://vmselect:8481/select/0/prometheus를 지정할 수 있습니다. 선택적 Grafana chart를 켜기 전에 인증·영속 저장·datasource 접근을 구성합니다. Vmalert rule·Alertmanager routing/receiver·exporter target도 함께 준비해야 하며 replica를 켠 것만으로 알림 전달이 완성되지 않습니다.
장기 저장소 구성
보존 기간과 디스크 용량
중복 args mapping이나 여러 보존 flag 대신 하나의 보존 인자를 정합니다.
args:
  - "--retentionPeriod=90d"
1.151.0 기본값은 한 달(31일), 최소값은 하루입니다. 단위 없는 숫자는 월 단위이므로 의도를 드러내는 단위를 명시합니다. Retention은 저장 byte 상한이 아니며 기간을 줄여도 즉시 공간이 반환되는 것은 아닙니다. 검토한 binary에는 storage.maxDiskSpace flag가 없습니다. storage.minFreeDiskSpaceBytes는 여유 공간이 임계값 미만이면 새 데이터를 받지 않으며, 크기 기반 보존 목표를 맞추기 위해 데이터를 자동 퇴출하는 옵션이 아닙니다. Merge·snapshot·일시적 부하를 위한 공간도 남겨 둡니다.
Snapshot 백업과 복원
vmbackup은 단일 노드/vmstorage 프로세스와 같은 storage directory에서 일관된 snapshot을 읽습니다. S3·GCS·Azure Blob·S3 호환 저장소·로컬 filesystem 목적지를 지원합니다. 로컬 snapshot만으로 독립된 백업이 생기는 것은 아니며 원격 복사본·credential·복원 절차를 보호해야 합니다.
앞의 raw StatefulSet PVC 이름은 storage-vmsingle-0(claim-template + StatefulSet + ordinal)이며 vmsingle-storage-vmsingle-0이 아닙니다. Operator가 생성한 이름은 다르므로 실제 Pod volume/PVC를 확인합니다. 임의의 CronJob이 다른 node에서 EBS RWO volume을 붙이거나 다른 Pod가 만든 snapshot을 읽을 수 있다고 가정하지 않습니다. 검토한 동일 Pod backup sidecar/workflow를 사용하고 snapshot URL도 정확히 해당 storage 프로세스를 가리키게 합니다.
# Run only in the reviewed backup container with this storage directory mounted.
vmbackup -storageDataPath=/storage \
  -snapshot.createURL=http://127.0.0.1:8428/snapshot/create \
  -dst=s3://example-vm-backup/cluster-a/vmsingle-0/2026-09-12
위 bucket/prefix는 예시이며 명령은 snapshot을 만들고 backup object를 씁니다. 이번 감사에서는 AWS 대상으로 실행하지 않았습니다. 하나의 목적지에 동시 writer를 두지 않습니다. 같은 목적지 재사용은 incremental 동기화이므로 자동으로 불변의 과거 백업이 쌓이지 않습니다. 날짜별 목적지·보존과 복원을 설계합니다. Cluster는 vminsert/vmselect나 load-balanced 임의 member 대신 모든 vmstorage를 서로 다른 prefix에 백업합니다. 호환되는 vmrestore 절차로 대상 DB 프로세스를 멈춘 상태에서 검토한 저장소에 복원합니다.
실제 backup container와 bucket/prefix에 최소 권한 workload identity를 부여하고 AWS Region·TLS·network 경로도 구성합니다. 검토한 소스는 AWS SDK for Go v2의 기본 configuration chain을 사용합니다. EKS Pod Identity에는 Agent·association·지원되는 Linux EC2 platform이 추가로 필요하며 IRSA도 통합 대안입니다. ServiceAccount 이름이나 S3 network 경로만으로 권한이 생기지 않습니다. 백업·보존 방식에 필요한 read/write/list/delete 또는 KMS 작업을 확인하며 정적 AWS access key를 chart·CronJob·image에 주입하지 않습니다.
다운샘플링
Enterprise storage downsampling과 OSS 추가 파생 series를 기록하는 것은 다릅니다. Recording rule은 raw 데이터를 삭제·압축하지 않으며 저장 series를 늘릴 수 있습니다. 수집 시 stream aggregation도 대안이지만 grouping·counter reset·입력 keep/drop 의미를 검토한 뒤 원본 폐기를 결정해야 합니다.
파생 Series 기록
5분 출력 간격을 선택할 때는 앞의 recording group을 이 group으로 교체하며 같은 record 이름을 가진 두 group을 동시에 활성화하지 않습니다.
CPU seconds는 counter이므로 idle rate를 계산한 뒤 사용률을 구합니다. 아래 1시간 표현식은 기록된 5분 ratio 관측값을 평균 냅니다. Histogram quantile은 서로 다른 series에 기록합니다. 같은 label의 p50/p90/p99를 or로 합치면 먼저 매칭된 series만 남고 나머지를 잃습니다.
groups:
- name: derived-series
  interval: 5m
  rules:
  - record: instance:node_cpu_utilization:ratio_rate5m
    expr: 1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))
  - record: instance:node_cpu_utilization:ratio_avg1h
    expr: avg_over_time(instance:node_cpu_utilization:ratio_rate5m[1h])
  - record: service:http_request_duration_seconds:p50_5m
    expr: histogram_quantile(0.5, sum by (service, le) (rate(http_request_duration_seconds_bucket[5m])))
  - record: service:http_request_duration_seconds:p90_5m
    expr: histogram_quantile(0.9, sum by (service, le) (rate(http_request_duration_seconds_bucket[5m])))
  - record: service:http_request_duration_seconds:p99_5m
    expr: histogram_quantile(0.99, sum by (service, le) (rate(http_request_duration_seconds_bucket[5m])))
이 p50/p90/p99는 파생 gauge이며 원래 histogram이나 임의의 더 긴 window quantile을 복원할 수 없습니다. 나중에 집계해야 한다면 rate/count/bucket 정보를 보존합니다. Alert 임계값·record interval·입력 누락·query 의미를 적용 전에 시험합니다.
성능 최적화
| 제어 항목 | 실제 제한 범위 |
|---|---|
memory.allowedPercent / memory.allowedBytes | 내부 cache이며 전체 process RSS 상한이 아닙니다. Query·수집·Go·OS memory 여유가 추가로 필요합니다. |
search.maxMemoryPerQuery | Query 하나의 메모리이며 동시 요청과 다른 할당을 함께 고려합니다. |
search.maxUniqueTimeseries, search.maxSamplesPerQuery | 지나치게 큰 query를 거부하며 수집 cardinality 자체를 줄이지 않습니다. |
search.maxQueryDuration, search.maxPointsPerTimeseries | Query 시간·출력 상한입니다. Range step 변경은 평가 해상도를 바꾸며 원래 저장 sample을 바꾸지 않습니다. |
storage.cacheSizeIndexDBDataBlocks, storage.cacheSizeIndexDBIndexBlocks | 고급 cache override입니다. 자동 크기 산정을 바꾸기 전에 miss·CPU·disk I/O를 측정합니다. |
maxLabelsPerTimeseries, maxLabelValueLen | 검토 버전은 한도를 초과한 series를 거부하고 vm_rows_ignored_total을 늘립니다. 무해하게 label만 자르는 기능이 아닙니다. |
dedup.minScrapeInterval | 같은 label set의 시간 구간마다 point 하나만 남깁니다. 복제·scrape cadence에 맞춰 정하며 일반 압축 설정으로 사용하지 않습니다. |
활성 series와 churn·query fan-out·보존·queue 증가·cache pressure·여유 disk를 측정합니다. 고정 resource 예제나 benchmark 하나로 운영 용량이 보장되지 않습니다. 관리·query endpoint에는 network 및 application 접근 제어를 적용합니다.
모범 사례
Replica 수보다 장애·복구 목표를 먼저 정합니다. Collector HA·storage 복제·query 가용성·backup을 구분하고 tenant routing/인증·TLS·workload identity·PVC 소유권·upgrade/migration 책임을 명시합니다. Insert 실패·거부된 row·queue drop·느린 query·memory·disk를 감시하고 rule을 작성하기 전에 각 구성 요소의 /metrics가 실제 노출하는 label을 확인합니다.
로컬 1.151.0의 /metrics에서 아래 이름을 확인했습니다. 해당 endpoint를 수집한 뒤 실제 job/instance label로 query 범위를 제한합니다.
vm_app_version
rate(vm_rows_inserted_total[5m])
rate(vm_slow_queries_total[5m])
process_resident_memory_bytes
마이그레이션 가이드
- 기존 scraper를 유지한 채 검토한 VictoriaMetrics remote-write 목적지를 추가하고 queue 상태·데이터 도착을 확인합니다.
- Grafana query와 alert rule을 양쪽에서 비교하며 누락·무트래픽·counter reset·histogram 집계를 포함한 알려진 입력을 사용합니다.
- 과거 데이터를 옮기려면 일관된 Prometheus snapshot을 만들고 보존합니다. 별도 제공되는
vmctl을 의도한 목적지에 실행하며 retention·중복/dedup·rate limit·권한을 고려합니다. - 대체 scraper/agent가 모든 target을 수집하고 실제 데이터가 도착한 뒤에만 기존 write 경로를 종료합니다. Grafana datasource 변경은 metric 수집을 대체하지 않습니다. Rollback 기간과 backup 소유권을 유지합니다.
remote_write:
- url: http://vmsingle.monitoring.svc:8428/api/v1/writevmctl prometheus --prom-snapshot=/backup/prometheus-snapshot \
--vm-addr=http://vmsingle.monitoring.svc:8428이는 설정·명령 참고이며 이번 감사에서 실제 마이그레이션을 실행하지 않았습니다. URL은 raw 단일 노드 예제의 이름이므로 Helm profile에서는 실제 생성된 Service를 사용합니다. Cluster의 import/write/query 경로는 단일 노드와 다릅니다. vmctl에는 --vm-addr로 vminsert base를, --vm-account-id로 의도한 tenant를 지정합니다. Importer base 대신 remote-write URL을 넣지 않습니다.
문제 해결
알고 있는 단일 노드 Service를 local port-forward해 읽기 전용 진단을 수행합니다. Operator/Helm 배포에서는 Service 이름을 바꿉니다.
kubectl port-forward -n monitoring svc/vmsingle 8428:8428curl --fail --silent --show-error http://127.0.0.1:8428/api/v1/status/tsdb
curl --fail --silent --show-error http://127.0.0.1:8428/api/v1/status/active_queries
curl --fail --silent --show-error http://127.0.0.1:8428/api/v1/status/top_queries
curl --fail --silent --show-error http://127.0.0.1:8428/metricsTSDB status는 series/cardinality 정보이며 filesystem 여유 byte나 완전한 memory profile이 아닙니다. Process/container memory·PVC/filesystem metric·queue 크기·storage health를 따로 확인합니다. Active/top-query endpoint는 요청 정보를 제공하며 유용한 결과를 얻으려면 관련 profiling flag나 수집 시간이 필요할 수 있습니다. Query filter·범위·step·동시성이 비용에 영향을 줍니다.
Disk 부족은 저장소·보존·수집 계획으로 대응하며 범위 없는 삭제 명령으로 해결하지 않습니다. delete_series, /snapshot/create, /internal/force_merge는 변경을 수행하는 관리 작업입니다. 삭제에는 올바르고 좁은 selector와 backup/보존 검토가 필요합니다. Snapshot은 disk block을 붙잡을 수 있고 force-merge는 I/O와 작업 공간이 필요합니다. 따라서 복사해 쓰는 읽기 전용 진단 명령에 포함하지 않습니다. 저장소 압력으로 수집을 멈추면 유한한 collector queue가 넘칠 수 있으므로 전체 경로를 확인합니다.
참고 자료
- VictoriaMetrics 1.151.0
- Single-node
- Cluster / replication
- MetricsQL
- vmagent
- vmalert
- vmbackup
- Prometheus snapshot migration
- Stream aggregation
- Stack0.92.1 values
- VMServiceScrape
- EKS EBS CSI
- Pod Identity SDK requirements
- Backup S3 implementation