EKS에서의 모델 훈련
마지막 업데이트: 2026년 9월 12일 기준: Slinky 1.2.2, MPI Operator 0.8.2, Volcano 1.15.2, PyTorch 2.14.0, Neuron SDK 2.32.0
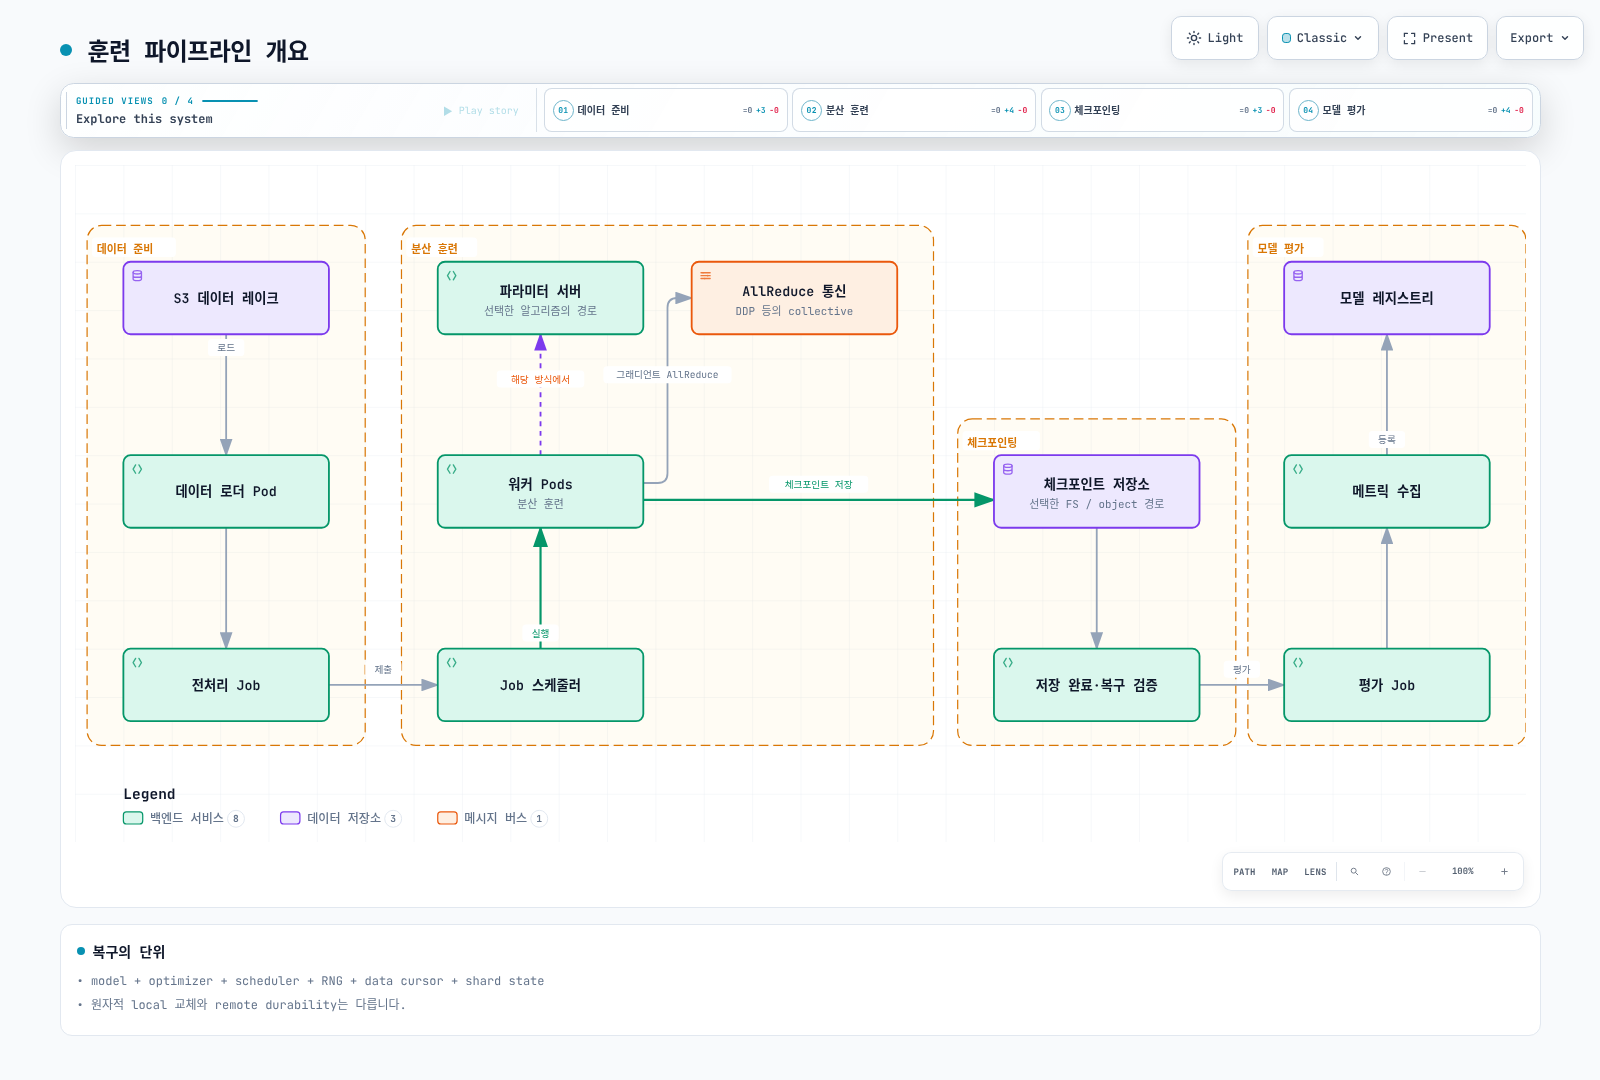
분산 훈련은 모델 코드, 데이터 분할, launcher, 장치 할당, 통신과 체크포인트가 함께 맞아야 합니다. Kubernetes 매니페스트가 생성되거나 Pod가 Running이라고 학습·복구가 검증된 것은 아닙니다.
단일 GPU QLoRA와 SageMaker AI/EKS 비교는 Qwen 가이드를 참고하세요. 해당 가이드의 이미지 지원 수명과 실행 제한도 함께 적용해야 합니다.
훈련 파이프라인
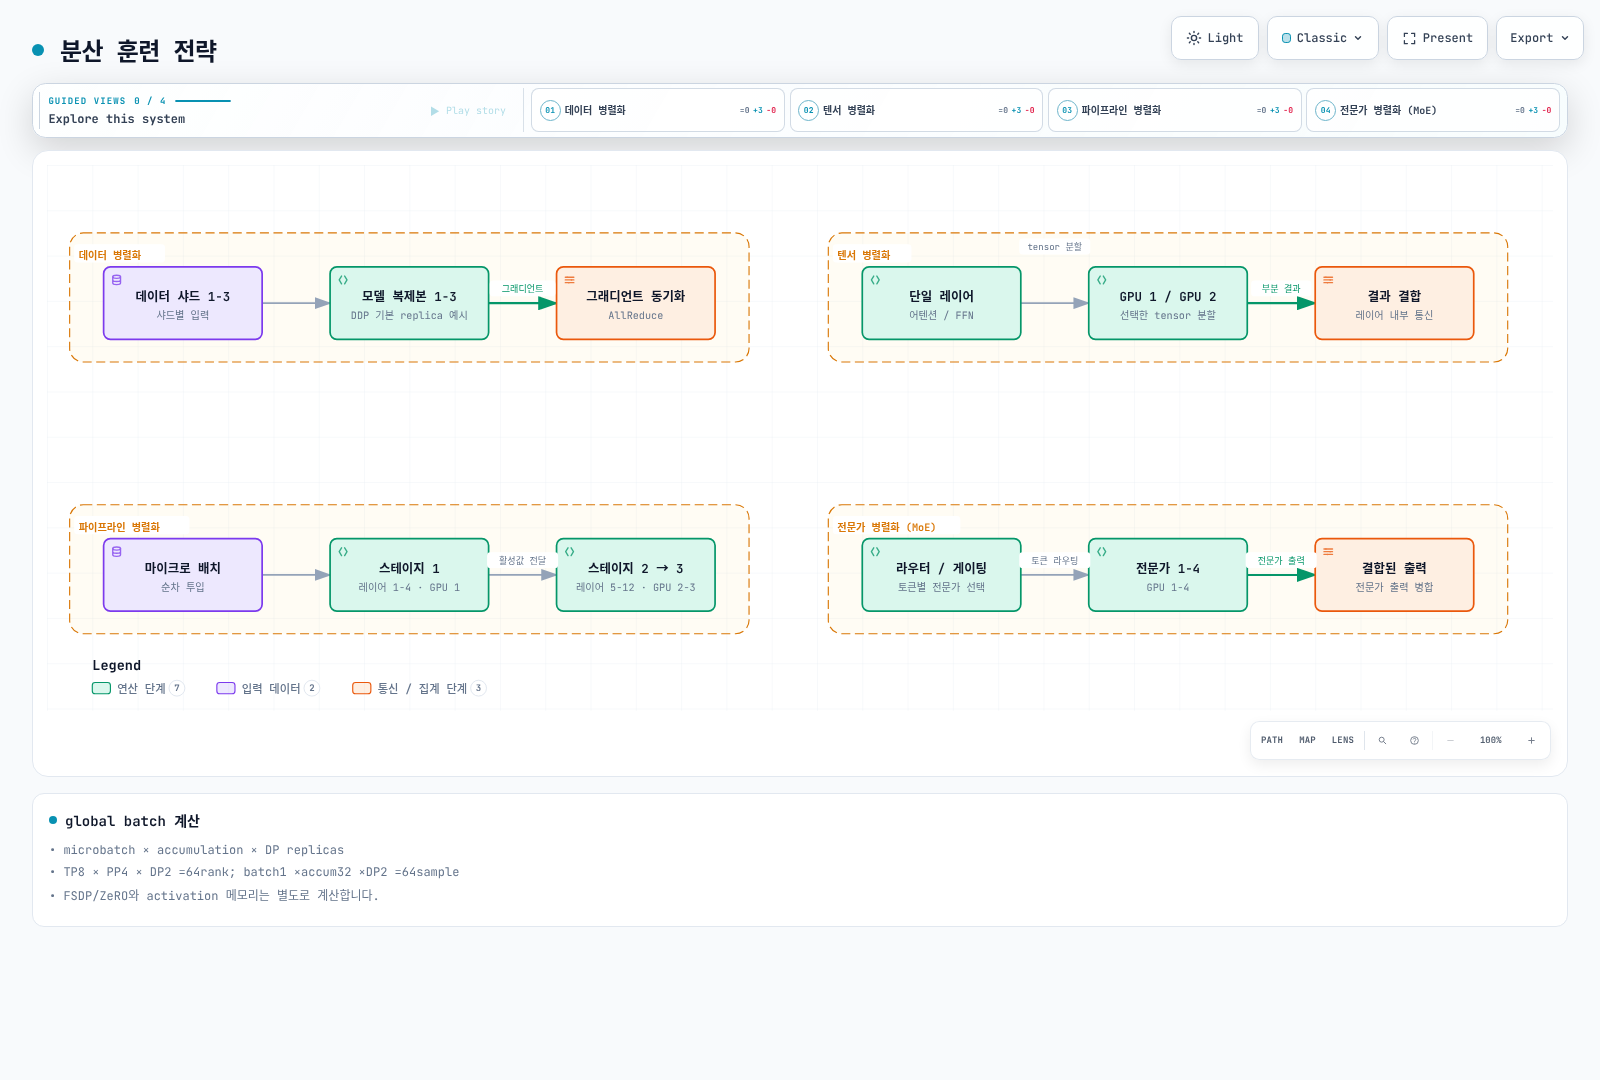
분산 훈련 전략
| 전략 | 분할 단위 | 검증할 제약 |
|---|---|---|
| DDP | 서로 다른 데이터 batch; 모델 replica | 전체 훈련 상태·activation 메모리, gradient 동기화 |
| FSDP / ZeRO | parameter·gradient·optimizer 상태 | 단계별 통신과 checkpoint 형식 |
| TP | 레이어의 tensor 연산 | head/hidden dimension, backend·통신 topology |
| PP | 레이어 stage | microbatch, pipeline bubble·activation 전달 |
| Expert parallel | MoE expert 및 token dispatch | 불균등 부하·all-to-all·routing capacity |
| 조합 | DP/TP/PP/context/expert group | 구현이 지원하는 mesh와 총 rank 수 |
“100B 이상이면 무조건3D가 최고”라는 기준은 사용하지 않습니다. 가중치 외에 optimizer·gradient·activation·통신 buffer를 계산하고 실제 throughput과 복구 비용으로 선택합니다. DDP의 all-reduce에 parameter server가 반드시 필요한 것도 아닙니다.
TP8×PP4×DP2라면 전체 rank는64개입니다. 하지만 global batch는 microbatch × accumulation × DP replica 수입니다. microbatch1·accumulation32·DP2이면64이며, TP/PP rank까지 다시 곱한2048이 아닙니다. 변수 길이 token packing은 sample 수와 token 수를 별도로 계산합니다.
Slurm과 Slinky
공식 저장소는 SlinkyProject/slurm-operator입니다. 확인한1.2.2 tag와 OCI chart는 존재하지만 GitHub releases/latest API는404였으므로 이를 “최신 GitHub release”로 기록하지 않았습니다.1.2 문서는 최소 Kubernetes1.29/Slurm25.11(data parser0.0.44)을 명시합니다. 최소 버전은 운영 지원 수명 보장이 아닙니다.
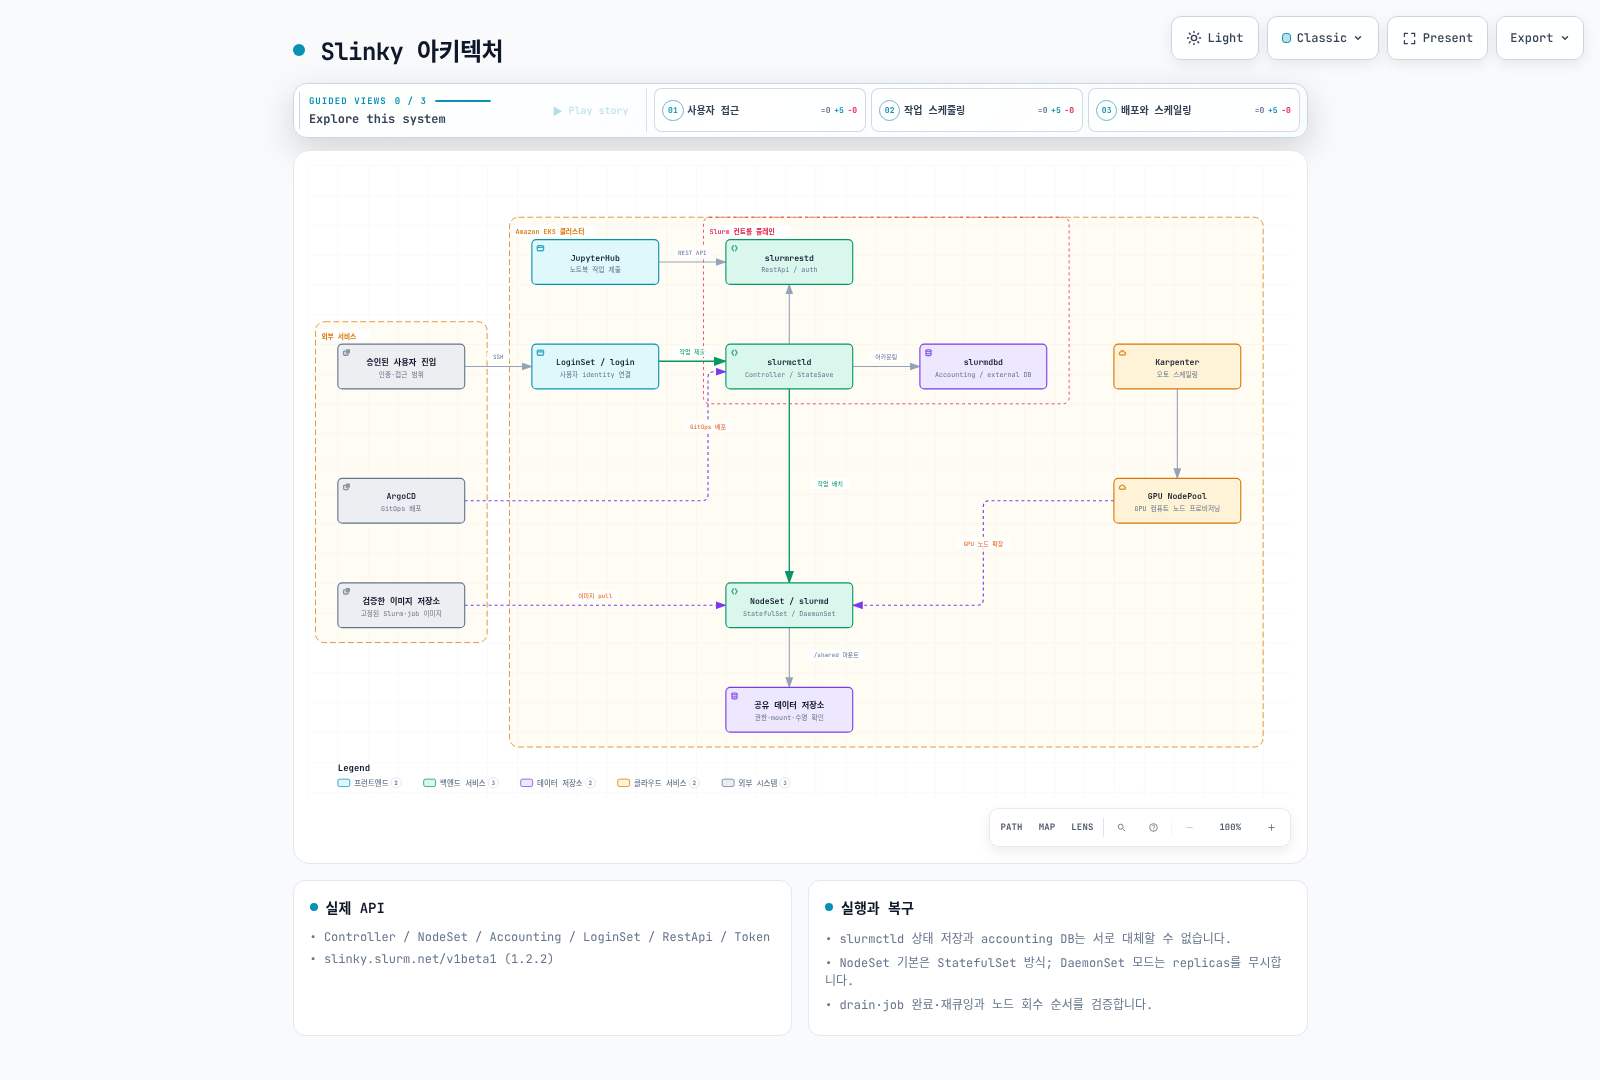
실제 API와 lifecycle
1.2.2의 API는 slinky.slurm.net/v1beta1의 Controller, NodeSet, Accounting, LoginSet, RestApi, Token입니다. 이전 SlurmCluster/SlurmNodeSet은 해당 API가 아닙니다. NodeSet은 controllerRef와 Pod template을 사용합니다. 기본 scalingMode는 StatefulSet 방식이며 DaemonSet 방식은 matching Kubernetes node마다 Pod를 만들고 replicas를 무시합니다. 이는 NodeSet controller의 동작 모드이며 slurmd가 언제나 DaemonSet 리소스라는 뜻은 아닙니다.
slurmctld는 job/node/partition 상태와 스케줄링을 관리하고 controller의 StateSaveLocation을 보존해야 합니다. slurmdbd는 accounting DB의 접근·기록 경로로, controller 상태 저장소의 대체물이 아닙니다. 로그인·REST·job 실행 주체의 인증과 파일 권한, Slurm key/JWT, DB 비밀의 전달·회전을 함께 설계합니다. 공개 NLB로 SSH를 노출하는 것을 기본 설치 조건으로 삼지 않습니다.
실제 chart를 먼저 렌더링합니다. 아래는 로컬 파일만 생성하며 cluster를 설치하지 않습니다. 운영 시 cert-manager/CRD/operator/Slurm 설치 순서, 영속 저장소·DB, 사용자 identity와 지원 Slurm 이미지를 별도로 준비합니다.
helm template slurm-api oci://ghcr.io/slinkyproject/charts/slurm-operator-crds   --version 1.2.2 > slurm-crds.yaml
helm template slurm-control oci://ghcr.io/slinkyproject/charts/slurm-operator   --version 1.2.2 --namespace slinky > slurm-operator.yaml
helm template slurm-example oci://ghcr.io/slinkyproject/charts/slurm   --version 1.2.2 --namespace slurm   --set-json 'nodesets={"cpu-example":{}}'   --set partitions.all.enabled=true > slurm-example.yaml
Argo CD Application은 실제 chart 경로·revision·values를 참조해야 합니다. 존재하지 않는 repo와 임의 compute.partitions/efa.enabled 설정을 붙여서는 구성되지 않습니다. prune과 CRD/PVC 삭제, Slurm drain·재큐잉·job 종료 timeout을 검토하세요. NodeSet 축소와 EC2 종료는 다른 제어 과정입니다.
Slurm에서 torchrun 실행
노드마다 torchrun launcher 하나를 실행하고 launcher가 GPU별 process를 만듭니다. 기존8개 Slurm task마다8process를 다시 만들던 방식은 한 노드64process로 중복 실행됐습니다. 다음은4노드×8process를 의도한 launcher 예시이며, 실제 Slurm/GPU 작업은 이번에 실행하지 않았습니다.
#!/bin/bash
#SBATCH --job-name=distributed-training
#SBATCH --nodes=4
#SBATCH --ntasks-per-node=1
#SBATCH --gpus-per-node=8
#SBATCH --cpus-per-task=16
#SBATCH --time=01:00:00
set -euo pipefail

: "${SLURM_NNODES:?Run within an approved Slurm allocation}"
: "${SLURM_JOB_ID:?}"
: "${SLURM_JOB_NODELIST:?}"
export MASTER_ADDR
MASTER_ADDR=$(scontrol show hostnames "$SLURM_JOB_NODELIST" | head -n 1)
export MASTER_PORT=29500

# One torchrun launcher per Slurm node, eight training processes per launcher.
# train.py, dependencies, data, credentials and checkpoints must be prepared.
srun --ntasks="$SLURM_NNODES" --ntasks-per-node=1 bash -c '
  exec torchrun \
    --nnodes="$SLURM_NNODES" \
    --nproc-per-node=8 \
    --node-rank="$SLURM_PROCID" \
    --rdzv-id="$SLURM_JOB_ID" \
    --rdzv-backend=c10d \
    --rdzv-endpoint="$MASTER_ADDR:$MASTER_PORT" \
    /workspace/train.py
'
Slurm이 task별로 GPU visibility를 제한하는 설정에서는 launcher가 필요한8GPU를 모두 받는지도 확인합니다. train.py는 LOCAL_RANK/RANK/WORLD_SIZE와 device binding, DDP·sampler, 데이터·model revision 및 resume를 구현해야 합니다. shell fixture에서는4launcher·서로 다른 node rank·동일 rendezvous 주소를 확인했습니다.
GPU 통신과 EFA
FI_PROVIDER=efa는 libfabric provider 선택이며 EFA 설치·노드 interface 부착·NCCL 연동을 자동으로 수행하지 않습니다. EFA가 활성화된 지원 instance, driver/libfabric, aws-ofi-nccl plugin, device plugin과 Pod 자원 요청, 보안 그룹과 실제 전송 경로를 함께 검증합니다. RAID0이나 subnet tag 이름만으로 EFA가 켜지지 않습니다.
통신 노드는 같은 AZ에 있어야 하며 cluster placement group은 성능을 위한 권장 조건입니다. NodePool 제한을 실제 training Pod가 사용하는지 확인하세요. 대역폭·EFA device 개수는 instance별로 다르며 모두400Gbps라고 표현하지 않습니다. NCCL Ring/Simple·IB_DISABLE·SOCKET_IFNAME·FI_EFA_USE_DEVICE_RDMA 등을 오래된 예제에서 무조건 강제하면 현재 plugin의 선택을 방해할 수 있습니다. 배포한 NCCL/libfabric 문서와 실제 로그·collective 테스트로 확인합니다.
Karpenter budgets.nodes=0은 자발적 disruption 경로의 제한이며 Spot 회수·노드 장애·강제 종료·모든 expiration을 막는 기능이 아닙니다. do-not-disrupt/PDB와 terminationGracePeriod/expireAfter의 상호작용을 확인하고 체크포인트 복구를 유지하세요. 최신 driver installer를 userData에서 매번 다운로드하거나 GPU clock을 기종 구분 없이 고정하지 않습니다.
BioNeMo
검토한3.0.0은 BioNeMo Recipes로, TransformerEngine 기반 모델·checkpoint와 PyTorch/Accelerate/Lightning 등의 훈련 recipe를 제공합니다. ESM-2, AMPLIFY, Geneformer 등 recipe별 지원을 확인하며, 이전 BioNeMo1.5 이미지의 MegaMolBART module을3.0 API처럼 실행하지 않습니다. 생물학적 모델의 결과 검증과 데이터·모델 사용 권한은 별도로 필요하며 GPU 자원만 지정한다고 recipe가 준비되지는 않습니다.
Trainium과 Neuron
SDK2.32.0의 torch-neuronx, NeuronX Distributed Training와 모델 구현, Optimum Neuron 등 선택 경로를 구분합니다. transformers-neuronx의 추론 지원을 모든 모델의 훈련 지원으로 설명하지 않습니다. TensorFlow/JAX·PyTorch 버전은 선택 hardware와 SDK 지원표를 확인하며 오래된2.18 DLC에 임의 pip 설치를 추가하지 않습니다.
Optimum Neuron0.4.5에는 NeuronTrainer/NeuronTrainingArguments와 별도 Neuron training-model 구현이 있습니다. 일반 BertForPreTraining을 로드하고 정의되지 않은 dataset/tokenizer를 넘기는 예제는 완성된 TP 훈련이 아닙니다. 지원 모델의 training config, 데이터·label·collator, tokenizer·revision, optimizer·checkpoint 형식과 launcher를 준비해야 합니다. CPU 예제의 PyTorch2.14를 Neuron SDK 지원 버전으로 간주하지 마세요.
멀티노드 Job과 사전 컴파일
일반 Job parallelism=4는4개 Pod 실행일 뿐 rank·rendezvous를 구성하지 않습니다. Indexed Job을 사용할 경우 completionMode와 index, 같은 master endpoint를 설정해야 합니다. 각 Pod의 status.podIP를 MASTER_ADDR로 넣으면 서로 다른 master를 바라보게 됩니다. coordinator/controller가 제공하는 topology와 지원 launcher를 사용하고, train_lora.py·데이터·compile cache·장치를 확인합니다.
neuron_parallel_compile은 graph 추출·사전 컴파일 경로이며 전체 학습 결과를 만드는 명령으로 대체할 수 없습니다. 사전 컴파일 성공 후 실제 훈련을 별도 실행하고 cache hit·shape·compiler/SDK revision을 확인하세요. 코어와 전체 장치는 Neuron 구분을 참고합니다.
Ray Train, MPI와 Volcano
Ray2.58/KubeRay1.7의 Train 가이드를 사용합니다. report 호출 횟수를 worker 간 맞추고 실제 Checkpoint 객체를 보고해야 합니다. get_checkpoint()는 복구할 이전 checkpoint를 가져오며 새 저장 context manager가 아닙니다. resources_per_worker에 GPU8을 지정한다고 worker 하나가 자동으로8GPU DDP process가 되는 것도 아닙니다.
MPI Operator0.8.2의 API는 kubeflow.org/v2beta1입니다. slotsPerWorker는 hostfile의 실행 slot을 선언하며 mpirun -np, mapping과 GPU binding을 자동으로 모두 결정하지 않습니다. Launcher/Worker의 코드·MPI/SSH 구현과 지원 image, CRD/RBAC를 준비해야 합니다. 네 개 worker×8slots가32개의 GPU process를 보장하는 것은 아닙니다.
Volcano1.15.2의 minAvailable은 Pod/member 수이며 EC2 node 수가 아닙니다.3개의 node에도 자원이 충분하면4개의 Pod가 배치될 수 있습니다. gang plugin은 설정한 최소 member/자원 조건을 적용하지만 모든 container의 동시 시작이나 학습 성공을 보장하지 않습니다. 추가 worker·elastic runtime 지원과 실패 시 RestartJob/재큐잉 정책을 검토하세요.
JupyterHub GPU profile은 실제 이미지·장치 label과 권한을 일치시켜야 합니다. g5.xlarge는 A10G이며 A100 profile로 표시하지 않습니다. 설정 ConfigMap을 실제 Hub가 읽도록 연결하고 사용자별 저장소·quota·네트워크·idle culling을 구성합니다.
훈련 스토리지와 체크포인트
GPU/storage 가이드의 검토한 CSI 경로를 사용합니다. 기존 FSx 파일시스템을 static PV로 마운트하는 경로와 PVC로 새 파일시스템을 만드는 dynamic provisioning은 다릅니다. 임의 dataRepositoryAssociations 필드를 FileSystem에 넣거나 SCRATCH_2에 PERSISTENT 전용 throughput 설정을 섞지 않습니다. DRA와 auto import/export는 별도 API·정책·완료 상태를 확인해야 합니다.
EFS PVC의 요청 용량은 물리 저장소 quota가 아닙니다. access point UID/GID·directory permission, CSI identity와 network·mount target을 검증합니다. S3 복사 완료 전의 local checkpoint는 remote에 durable하다고 주장할 수 없습니다.
체크포인트에는 모델뿐 아니라 optimizer, scheduler, RNG, scaler(사용 시), sampler/data cursor와 모든 sharded state가 필요합니다. rank마다 동일 파일을 덮어쓰지 않고 framework의 분산 저장 protocol을 사용하세요. 완료 marker/manifest와 checksum을 검증한 뒤 remote 전송·복구를 확인하고 이전 정상본을 정리합니다. 가상의 checkpoint-manager 이미지나 auto_resume=true ConfigMap은 이 기능을 구현하지 않습니다.
실행 가능한 작은 CPU 예제
다음은 합성16sample·단일 CPU thread·4optimizer update 예제입니다. 그래디언트 누적, 경계가 제한된 cosine schedule, 임시 파일 교체와 optimizer/RNG 상태 복구를 보여줍니다. PyTorch2.14.0+cpu에서 중단 없는 실행과2step후 복구한 결과가 동일한 것을 확인했습니다. 실제 GPU·분산·remote durability 테스트는 아닙니다.
from pathlib import Path
import math
import os
import tempfile
import torch


def lr_factor(step, warmup_steps, total_steps, min_ratio=0.1):
    if not 0 <= warmup_steps < total_steps or not 0 <= min_ratio <= 1:
        raise ValueError("Invalid schedule bounds")
    if step < 0:
        raise ValueError("Step must be non-negative")
    if step < warmup_steps:
        return step / max(1, warmup_steps)
    progress = min(1.0, (step - warmup_steps) / (total_steps - warmup_steps))
    return min_ratio + (1 - min_ratio) * (1 + math.cos(math.pi * progress)) / 2


def save_checkpoint(path, state):
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(dir=path.parent, delete=False) as output:
            temporary = output.name
            torch.save(state, output)
            output.flush()
            os.fsync(output.fileno())
        os.replace(temporary, path)
    finally:
        if temporary is not None and os.path.exists(temporary):
            os.unlink(temporary)


def train_toy(checkpoint_path, stop_after=4, resume=False):
    # Tiny deterministic CPU example; no GPU, dataset or model download.
    torch.set_num_threads(1)
    torch.manual_seed(17)
    model = torch.nn.Linear(2, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9)
    scheduler = torch.optim.lr_scheduler.LambdaLR(
        optimizer, lambda step: lr_factor(step, 1, 4)
    )
    inputs = torch.arange(32, dtype=torch.float32).reshape(16, 2) / 32
    targets = inputs.sum(dim=1, keepdim=True)
    start = 0
    if resume:
        saved = torch.load(checkpoint_path, map_location="cpu", weights_only=True)
        model.load_state_dict(saved["model"])
        optimizer.load_state_dict(saved["optimizer"])
        scheduler.load_state_dict(saved["scheduler"])
        torch.set_rng_state(saved["torch_rng"])
        start = saved["optimizer_step"]
    if not start <= stop_after <= 4:
        raise ValueError("Invalid stopping point")
    for step in range(start, stop_after):
        optimizer.zero_grad(set_to_none=True)
        # Two equal-sized microbatches per optimizer update.
        for microbatch in range(2):
            offset = step * 4 + microbatch * 2
            prediction = model(inputs[offset:offset + 2])
            loss = torch.nn.functional.mse_loss(prediction, targets[offset:offset + 2]) / 2
            loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        scheduler.step()
        save_checkpoint(checkpoint_path, {
            "model": model.state_dict(),
            "optimizer": optimizer.state_dict(),
            "scheduler": scheduler.state_dict(),
            "optimizer_step": step + 1,
            "torch_rng": torch.get_rng_state(),
        })
    return {name: value.detach().clone() for name, value in model.state_dict().items()}


if __name__ == "__main__":
    path = Path("toy-training.pt")
    train_toy(path, stop_after=2)
    train_toy(path, stop_after=4, resume=True)
    print("Completed four CPU optimizer updates, including checkpoint resume.")
이 예제는 같은 파일시스템에서의 완성 파일 교체를 보여주며 filesystem crash·directory metadata flush·S3 transaction이나 분산 checkpoint protocol을 구현하지 않습니다. 데이터는 고정 순서이므로 일반 sampler 복구도 별도로 필요합니다. production에서는 저장 완료 지연·장애 빈도·허용 손실·보존 비용을 측정해 주기와 보존 수를 정하세요. 무조건500step/5개가 모든 훈련의 정답은 아닙니다.
수치 정밀도와 메모리 최적화
현재 PyTorch API는 torch.amp.autocast와 torch.amp.GradScaler입니다. BF16은 FP32와 같은 지수 비트 수를 갖지만 가수 정밀도와 표현 가능한 최대값은 같지 않습니다. 대개 FP16용 loss scaling 없이 사용하지만 장치 지원·연산·수렴을 확인해야 합니다. autocast는 모든 weight/optimizer state를 BF16으로 바꾸지 않습니다.
활성화 checkpointing은 backward에서 activation을 재계산하는 메모리·연산 교환입니다. disk checkpoint와 다르며 고정3–4배 절약이나30% slowdown을 보장하지 않습니다. torch.utils.checkpoint.checkpoint의 use_reentrant를 명시하고 dropout/RNG·stateful layer와 gradient를 검증합니다.
Flash Attention/SDPA는 지원 dtype·head size·장치·mask에 따라 backend가 선택됩니다. training 변수를 정의하고 evaluation에서는 dropout_p=0을 전달합니다. causal mask와 명시적 mask의 조합 지원도 해당 API를 확인해야 하며 모델에 use_cache=False만 넣는 것으로 attention backend가 설치되지는 않습니다.
DeepSpeed0.19.6 ZeRO1은 optimizer state,2는 gradient까지,3은 parameter까지 분할합니다. CPU/NVMe offload는 별도 설정입니다. Stage3이라고 자동으로 CPU offload가 켜지지 않으며 auto 값은 Transformers 같은 상위 integration이 치환하는 경로와 순수 DeepSpeed 설정을 구분해야 합니다. 통신 buffer·activation·가장 큰 layer 때문에 메모리가 무제한으로 줄어들지 않습니다.
scheduler는 optimizer update 기준으로 진행하고 accumulation microstep 수와 혼동하지 않습니다. 예제처럼 training 종료 이후 cosine이 다시 상승하지 않도록 progress를 제한하고 warmup/total step 입력을 검사하세요.
검증 범위
전체 본문·퀴즈와 기존76개 고유 code block을 검토했습니다. 공식 Slinky Helm·CRD, MPI/Volcano API와 SDK source를 확인하고, 작은 CPU 훈련·복구 및 shell launcher fixture를 실행했습니다. GPU/Neuron/EFA·Slurm/MPI cluster·실제 모델·클라우드 리소스를 실행하지 않았습니다. 코드·스키마 검증과 실제 배포 가능성을 구분해야 합니다.
참고 자료
- Slinky 1.2.2
- Slurm controller
- Slurm accounting daemon
- MPI Operator 0.8.2
- Volcano 1.15.2 gang plugin
- EKS EFA networking
- BioNeMo 3.0.0 recipes
- Optimum Neuron 0.4.5
- Neuron SDK 2.32.0
- PyTorch 2.14 launcher
- DeepSpeed 0.19.6 ZeRO configuration