ClickHouse
마지막 업데이트: 2026년 9월 13일
ClickHouse는 컬럼 기반 분석 데이터베이스입니다. SQL 필터·집계·JOIN이 필요한 로그 분석에 적합할 수 있지만, 수집 스키마·보존 기간·운영 방식이 실제 workload에 맞는지 확인해야 합니다.
목차
개요
ClickHouse의 특징
| 기능 | 실무 의미 |
|---|---|
| 컬럼 저장 | 모든 레코드의 전체 필드 대신 필요한 컬럼을 읽음 |
| 압축·codec | 반복 값과 적절한 정렬이 저장량을 줄일 수 있음; 실제 데이터로 측정 |
| SQL 분석 | ClickHouse SQL 함수·집계·JOIN 사용; 모든 SQL dialect와 완전히 호환되지는 않음 |
| Sharding | 서버에 데이터를 분산하며 hot shard를 피하도록 key 선정 |
| Replication | ReplicatedMergeTree가 Keeper/ZooKeeper를 통해 replica 조정 |
| Batch 수집 | 고정 rows/sec를 가정하지 않고 insert 빈도와 part 생성을 제어 |
로그 분석에 ClickHouse를 선택하는 이유
구조화된 로그에서 반복적인 분석 쿼리가 많다면 검토할 만합니다. 대표 필터·텍스트 검색·보존 기간·동시 조회·수집 burst를 함께 측정합니다. 10:1 이상의 압축, 수십억 행을 수초에 조회하는 성능, 특정 비용 절감률은 workload에 따른 결과이지 이 설정의 보장이 아닙니다.
이 가이드의 명시적인 검토 기준은 ClickHouse 26.3.33.24 LTS, Altinity Operator 0.27.3, Vector 0.58.0, Grafana ClickHouse datasource 4.21.2입니다. 릴리스가 공개되었다고 임의의 Kubernetes/EKS 버전·StorageClass·조합이 운영 환경에서 호환됨을 뜻하지 않습니다. 실제 클러스터와 업그레이드 경로를 따로 검증합니다.
다른 솔루션과의 비교
| 시스템 | 쿼리·저장 모델 | 비교할 항목 |
|---|---|---|
| ClickHouse | 컬럼 테이블의 SQL 분석 | Sort key, projection/index, 집계, insert/merge 동작 |
| OpenSearch / Elasticsearch | 문서 검색·분석 | 텍스트 분석, mapping, indexing 비용, 검색 요구 |
| Loki | Label로 인덱싱한 stream/chunk의 LogQL | Label cardinality, scan 비용, 보존, 배포 모드 |
압축·속도·운영 복잡도를 고정 순위로 비교하지 않습니다. 각 시스템에 여러 배포 방식과 검색 기능이 있으므로 같은 데이터·쿼리·replica·보존 조건에서 비교합니다.
아키텍처
ClickHouse 클러스터 아키텍처
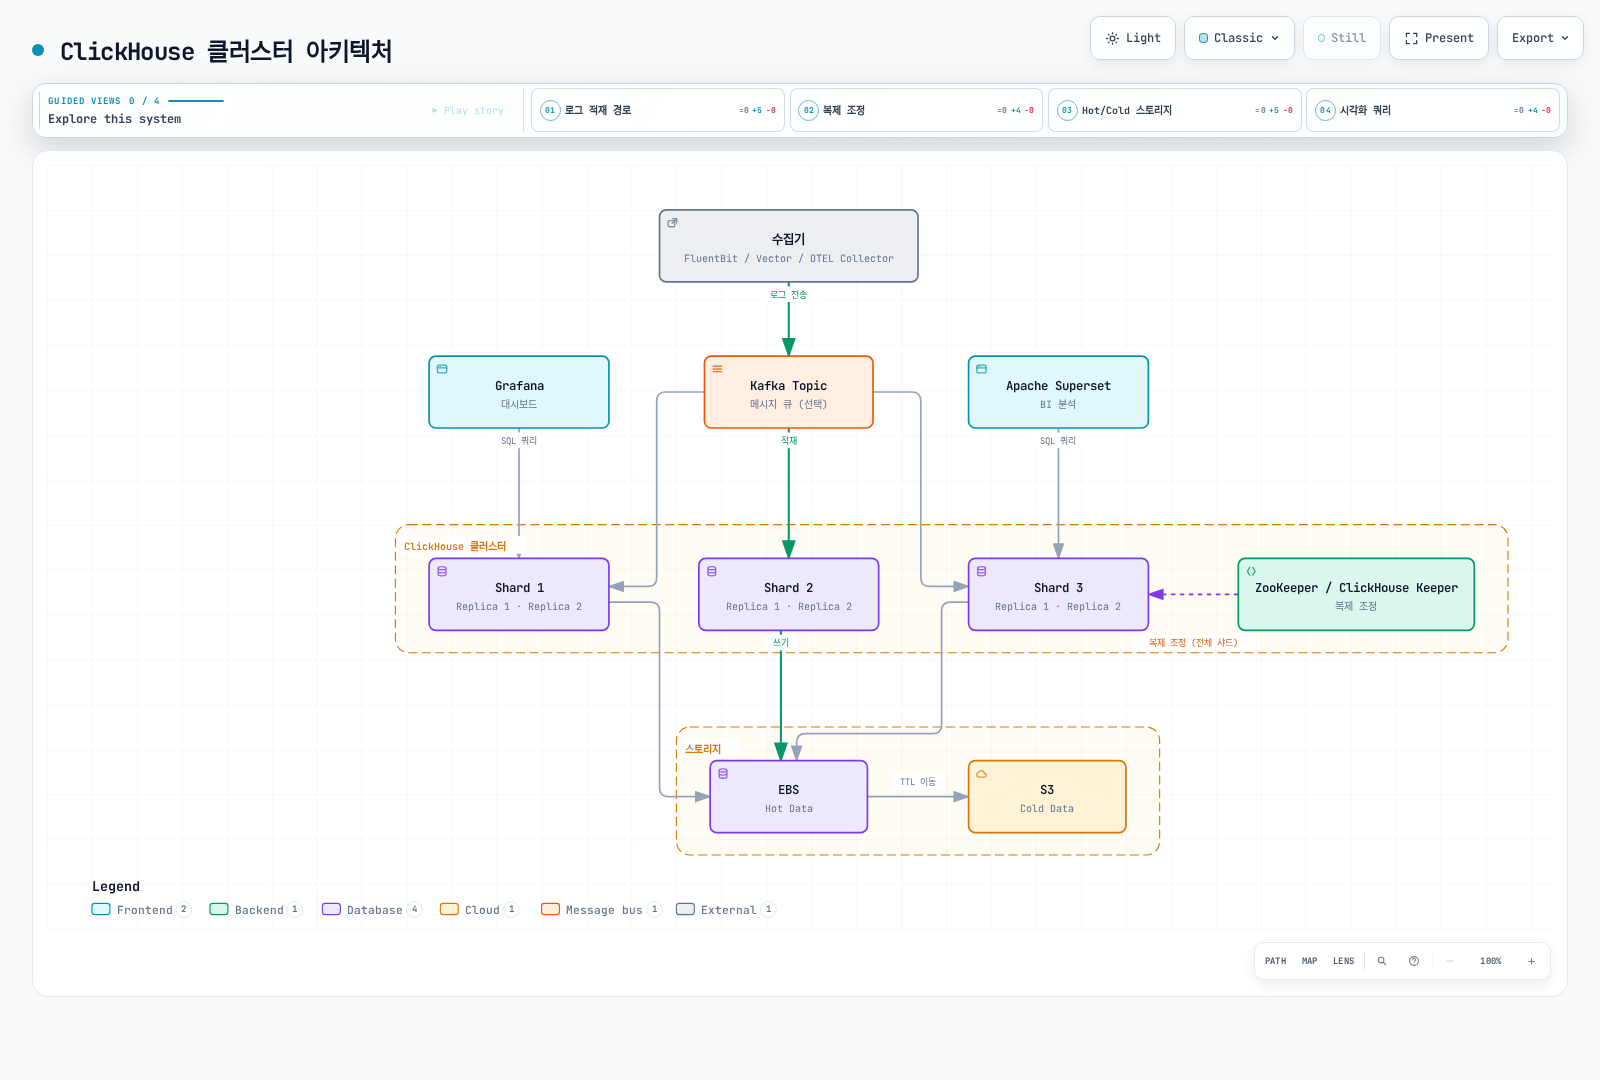
그림은 개념 topology이며 검증된 용량 설계가 아닙니다. 각 ClickHouse replica에는 독립된 데이터 volume이 필요합니다. EBS 아이콘 하나가 replica 6개가 같은 EBS filesystem을 공유한다는 뜻은 아닙니다. Keeper/ZooKeeper는 replication과 분산 DDL을 조정합니다. 분산 쿼리는 ClickHouse query initiator와 Distributed engine이 처리하며 Keeper가 query router는 아닙니다.
데이터 흐름
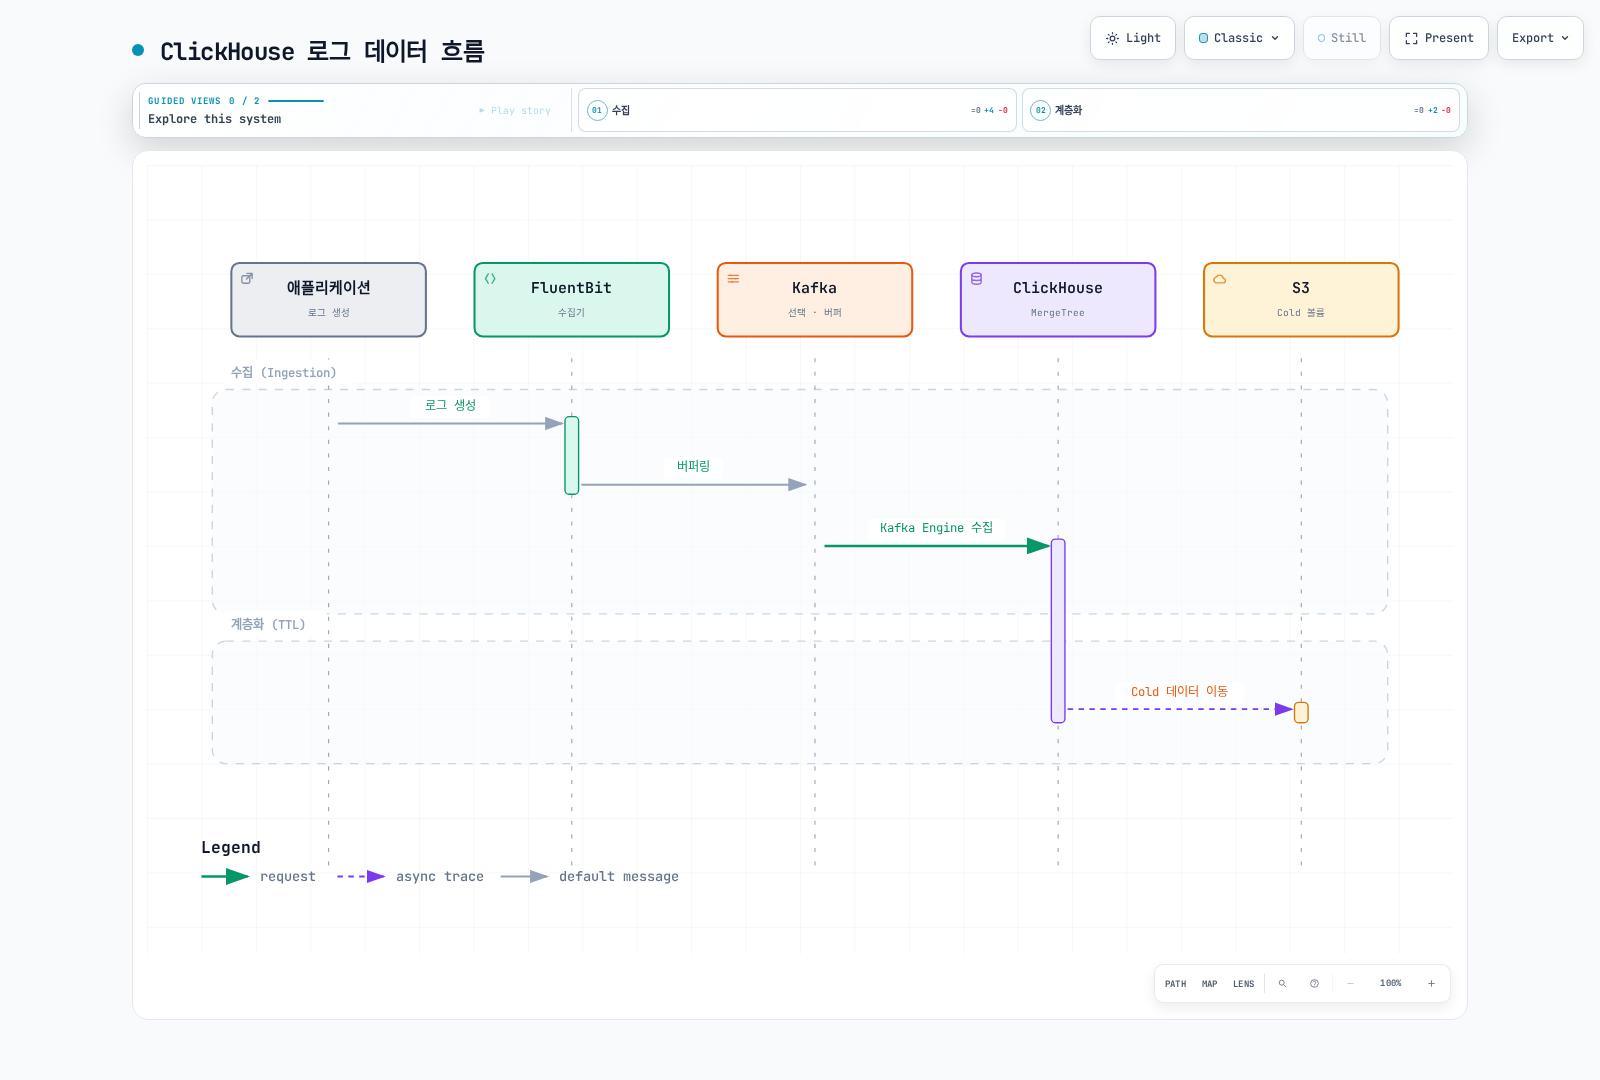
화살표는 데이터 이동을 나타냅니다. Kafka engine 방식에서는 ClickHouse consumer가 Kafka를 poll합니다. Kafka가 insert를 push하거나 exactly-once를 보장한다는 그림이 아닙니다. S3의 cold table part와 독립적인 Parquet archive도 서로 다른 방식입니다.
Kubernetes 배포
ClickHouse Operator 설치
변하는 master bundle 대신 버전을 고정한 공식 chart를 사용합니다.
helm upgrade --install clickhouse-operator \
  https://github.com/Altinity/clickhouse-operator/releases/download/release-0.27.3/altinity-clickhouse-operator-0.27.3.tgz \
  --namespace clickhouse-operator --create-namespace

kubectl -n clickhouse-operator get deployments,pods
kubectl get crd clickhouseinstallations.clickhouse.altinity.com \
  clickhousekeeperinstallations.clickhouse-keeper.altinity.com
적용 전 렌더링한 RBAC, 감시 namespace, CRD 설치·업그레이드 방식을 확인합니다. 이 검토에서는 공식 릴리스 checksum 확인과 로컬 Helm 렌더링을 수행했습니다. 실제 operator 설치나 클러스터 reconciliation은 실행하지 않았습니다.
ClickHouse 클러스터 정의
다음은 필수 선행 리소스가 있는 topology 예제이며 완성된 보안 설치 manifest가 아닙니다.
clickhousenamespace,clickhouse-serverServiceAccount, 적절한 CSI 기반gp3StorageClass가 있어야 합니다. StorageClass 이름은 환경별 선택입니다. EKS Auto Mode와 일반 EBS CSI는 각 provisioner·topology 설정을 사용합니다.- 운영자가 관리하는
log-securityClickHouseInstallationTemplate에서 Secret file mount, 계정, TLS, probe, 내부 통신 인증을 설정해야 합니다. 아래logs-serverpod template에도 해당 설정·mount가 적용되는지 확인합니다. - 정상적인
logs-keeperClickHouseKeeperInstallation이 의도한 TLS endpoint와 quorum을 제공해야 합니다. clickhousenamespace에 HTTPS 8443을 제공하는 내부logs-clickhouseService를 준비합니다. 인증서가 클라이언트 DNS 이름과 일치해야 합니다. 실제 operator selector·endpoint를 확인하며 CHI 이름만으로 이 Service 이름이 생긴다고 가정하지 않습니다.- 장애 도메인·disruption budget·자원은 측정 결과로 정합니다. 아래 3×2 구성과 replica당 100Gi/8Gi 제한은 예시이며 처리량·가용성을 보장하지 않습니다.
apiVersion: clickhouse.altinity.com/v1
kind: ClickHouseInstallation
metadata:
  name: logs-demo
  namespace: clickhouse
spec:
  # Required site-owned template: users, TLS, probes and internal authentication.
  useTemplates:
    - name: log-security
  defaults:
    templates:
      podTemplate: logs-server
      dataVolumeClaimTemplate: logs-data
  configuration:
    zookeeper:
      keeper:
        name: logs-keeper
        serviceType: replicas
    clusters:
      - name: logscluster
        secure: "yes"
        insecure: "no"
        layout:
          shardsCount: 3
          replicasCount: 2
  templates:
    podTemplates:
      - name: logs-server
        spec:
          serviceAccountName: clickhouse-server
          containers:
            - name: clickhouse
              image: clickhouse/clickhouse-server:26.3.33.24
              resources:
                requests:
                  cpu: "2"
                  memory: 4Gi
                limits:
                  memory: 8Gi
    volumeClaimTemplates:
      - name: logs-data
        spec:
          accessModes: [ReadWriteOnce]
          storageClassName: gp3
          resources:
            requests:
storage: 100Gilog_writer, log_reader, 관리 계정을 분리합니다. 자격 증명·설정은 Secret file로 mount하고 비밀번호를 ConfigMap·소스·shell argument·광범위한 환경변수 출력에 넣지 않습니다. 계정 network와 NetworkPolicy를 실제 collector·조회·replica 통신에 제한합니다. ::/0 계정, 만료된 예제 인증서, 인증서 검증 우회를 복사하지 않습니다.
TLS port 노출만으로 충분하지 않습니다. 인증서 로딩·hostname/CA 검증·replica 통신·readiness probe를 확인합니다. 보안 template·volume·선행 리소스를 함께 검토하기 전에 topology를 적용하지 않습니다. 로컬 CRD 검증은 구조 검사이며 admission·스케줄링·TLS·operator 동작 검증이 아닙니다.
ZooKeeper (또는 ClickHouse Keeper) 배포
신규 구성에서는 ClickHouse Keeper와 operator의 ClickHouseKeeperInstallation 지원을 검토할 수 있습니다. 고정한 operator는 zookeeper.keeper.name으로 CHK를 참조하고 reconciliation 중 secure Keeper service port를 감지합니다. 공식 Keeper 참조와 TLS 예제를 설정 근거로 사용하되 예제의 image·설정을 그대로 운영 기준으로 간주하지 않습니다.
Voting member 3개는 과반수 2개가 필요합니다. 영속 상태·peer 연결·인증서·장애 도메인별 배치를 검증해야 합니다. zookeeper-0 같은 Pod 이름을 숫자형 ZOO_MY_ID에 전달하지 않습니다.
kubectl -n clickhouse get chk logs-keeper
kubectl -n clickhouse get chi logs-demo
kubectl -n clickhouse get pods,pvc,services,endpointslices
kubectl -n clickhouse get events --sort-by=.metadata.creationTimestamp
로그 수집 파이프라인
Buffer → Store → Distributed 3계층 설계
세 가지는 engine의 역할이며 각각 독립된 영속 복사본을 뜻하지 않습니다. MergeTree는 part를 저장하고 ReplicatedMergeTree는 replication을 더합니다. Distributed는 shard 간 조회·insert를 전달합니다. 선택적인 Buffer는 대상 테이블로 보내기 전 프로세스 메모리에 데이터를 보관합니다.
모든 경로의 목적지를 shard별 logs.application_logs, 클러스터 접근용 logs.application_logs_distributed로 통일합니다. 같은 Distributed 테이블을 IF NOT EXISTS로 다시 생성해도 기존 대상은 바뀌지 않습니다. SHOW CREATE TABLE을 확인하고 명시적으로 migration합니다.
먼저 collector batch를 사용합니다. ClickHouse asynchronous insert도 선택지입니다. 활성화할 경우 wait_for_async_insert=1은 buffer의 insert 처리를 기다립니다. Flush 전에 응답하는 모드는 전달·오류 확인을 약화시킵니다. 선택한 engine·사용자 설정·retry를 함께 검증합니다. 아래 Vector는 동기 batch insert와 foreground Distributed forwarding을 설정한 writer profile을 사용합니다.
비교용인 다음 Buffer 테이블은 같은 로컬 저장 테이블을 대상으로 합니다.
CREATE TABLE logs.application_logs_buffer ON CLUSTER logscluster
AS logs.application_logs
ENGINE = Buffer(
    logs, application_logs, 4,
    1, 10,
    1000, 10000,
    1000000, 10000000);
Buffer는 모든 minimum 조건을 만족하거나 어느 하나의 maximum 조건을 만족하면 flush합니다. 제한은 buffer layer별로 적용됩니다. 4개 layer × 10,000,000 bytes는 대략적인 threshold 예산이지 프로세스 메모리 상한이 아닙니다. 입력 block·복사본·쿼리·cache가 추가 메모리를 사용합니다. Crash로 미처리 행을 잃을 수 있고 block 순서가 바뀌면 replicated insert deduplication도 영향을 받습니다. 기본 수집 경로를 이 예제로 바꾸거나 영속적인 Kafka replay 보호라고 설명하지 않습니다.
로그 테이블 스키마
logscluster cluster 이름, Keeper, {shard}/{replica} macro를 확인한 뒤 관리 계정으로 cluster DDL을 실행합니다.
CREATE DATABASE IF NOT EXISTS logs ON CLUSTER logscluster;

CREATE TABLE IF NOT EXISTS logs.application_logs ON CLUSTER logscluster
(
    timestamp DateTime64(3, 'UTC') CODEC(Delta, ZSTD(1)),
    date Date MATERIALIZED toDate(timestamp),
    level LowCardinality(String),
    namespace LowCardinality(String),
    service LowCardinality(String),
    pod_name String,
    container_name LowCardinality(String),
    node_name LowCardinality(String),
    message String CODEC(ZSTD(1)),
    trace_id String,
    raw_json String CODEC(ZSTD(1)),
    response_time_ms Nullable(Float64)
        MATERIALIZED if(
            JSONType(raw_json, 'response_time_ms') IN ('Int64', 'UInt64', 'Double'),
            JSONExtract(raw_json, 'response_time_ms', 'Nullable(Float64)'),
            NULL)
)
ENGINE = ReplicatedMergeTree(
    '/clickhouse/logs-demo/tables/{shard}/application_logs', '{replica}')
PARTITION BY date
ORDER BY (namespace, service, timestamp)
TTL toDateTime(timestamp) + INTERVAL 90 DAY DELETE;

CREATE TABLE IF NOT EXISTS logs.application_logs_distributed ON CLUSTER logscluster
AS logs.application_logs
ENGINE = Distributed(
    'logscluster', 'logs', 'application_logs',
    cityHash64(namespace, service, pod_name));
Collector는 일반 컬럼 10개를 전송하고 ClickHouse가 date와 nullable response_time_ms를 계산합니다. 응답 시간이 없거나 숫자가 아니면 NULL로 남아 일반 로그가 0ms 요청에 섞이지 않습니다. raw_json은 유효한 애플리케이션 JSON이며 신뢰하는 Kubernetes metadata와 분리됩니다. 비밀·개인정보가 포함될 수 있다면 수집 전에 redaction합니다.
일별 partition은 이 예제의 보존 관리 선택이며 모든 workload의 최적값은 아닙니다. Keeper path는 이 installation 전용입니다. 관계없는 installation에서 재사용하면 replication identity가 섞일 수 있습니다. IF NOT EXISTS는 schema migration이 아닙니다.
Secret 관리 절차로 이미 생성한 SQL 관리 계정에는 참여 서버마다 다음 grant/profile을 구성합니다. 파일로 관리하는 계정은 동일한 파일 설정을 사용해야 하며 ALTER USER로 수정할 수 있다고 가정하지 않습니다.
-- Users and credentials already exist through the site-owned secret configuration.
GRANT INSERT ON logs.application_logs TO log_writer;
GRANT INSERT ON logs.application_logs_distributed TO log_writer;
GRANT SELECT ON logs.application_logs TO log_reader;
GRANT SELECT ON logs.application_logs_distributed TO log_reader;

CREATE SETTINGS PROFILE logs_readonly
SETTINGS readonly = 1, max_execution_time = 60 CHANGEABLE_IN_READONLY;
ALTER USER log_reader SETTINGS PROFILE logs_readonly;

CREATE SETTINGS PROFILE logs_writer
SETTINGS distributed_foreground_insert = 1, async_insert = 0;
ALTER USER log_writer SETTINGS PROFILE logs_writer;
Writer의 foreground Distributed insert는 shard 전달을 기다리지만 특정 replica quorum·모든 retry의 중복 제거·모든 저장소 장애 보호를 뜻하지 않습니다. Quorum·실패·retry·권한은 따로 검증합니다. Grafana reader는 read-only를 유지하면서 플러그인이 필요한 query timeout 설정 변경을 허용합니다.
Vector를 통한 수집
아래는 Vector 0.58.0 설정 파일입니다. DaemonSet, ServiceAccount/RBAC, 읽기 전용 /var/log/pods, 쓰기 가능한 /var/lib/vector를 별도로 구성합니다. 비밀이 아닌 VECTOR_SELF_NODE_NAME은 Downward API로 Pod의 spec.nodeName에서 설정합니다. Kubernetes source가 이 변수를 직접 읽으므로 전역 환경변수 보간은 필요하지 않습니다.
Secret의 password key를 /etc/vector/clickhouse-auth에, 신뢰할 CA를 /etc/vector/clickhouse-tls/ca.crt에 mount합니다. Vector 0.58은 아래처럼 명시적인 SECRET[backend.key] backend를 사용합니다. 예전 ${CLICKHOUSE_PASSWORD} 보간이 기본 활성화되어 있다고 가정하지 않습니다.
data_dir: /var/lib/vector

secret:
  clickhouse_auth:
    type: directory
    path: /etc/vector/clickhouse-auth
    remove_trailing_whitespace: true

sources:
  kubernetes:
    type: kubernetes_logs
    auto_partial_merge: true

transforms:
  project:
    type: remap
    inputs: [kubernetes]
    source: |
      raw = string(.message) ?? ""
      parsed, err = parse_json(raw)
      app = if err == null && is_object(parsed) { object!(parsed) } else { {} }
      namespace = string(.kubernetes.pod_namespace) ?? "unknown"
      service = string(.kubernetes.pod_labels."app.kubernetes.io/name") ??
        string(.kubernetes.pod_labels.app) ?? "unknown"
      pod = string(.kubernetes.pod_name) ?? "unknown"
      container = string(.kubernetes.container_name) ?? "unknown"
      node = string(.kubernetes.pod_node_name) ?? "unknown"
      event_time = if is_timestamp(.timestamp) { timestamp!(.timestamp) } else {
        parse_timestamp(string(.timestamp) ?? "", format: "%+") ?? now()
      }
      . = {
        "timestamp": event_time,
        "level": downcase(string(app.level) ?? "unknown"),
        "namespace": namespace,
        "service": service,
        "pod_name": pod,
        "container_name": container,
        "node_name": node,
        "message": string(app.message) ?? raw,
        "trace_id": string(app.trace_id) ?? "",
        "raw_json": encode_json(app)
      }

sinks:
  clickhouse:
    type: clickhouse
    inputs: [project]
    endpoint: https://logs-clickhouse.clickhouse.svc.cluster.local:8443
    database: logs
    table: application_logs_distributed
    format: json_each_row
    date_time_best_effort: true
    skip_unknown_fields: false
    auth:
      strategy: basic
      user: log_writer
      password: "SECRET[clickhouse_auth.password]"
    tls:
      ca_file: /etc/vector/clickhouse-tls/ca.crt
      verify_certificate: true
      verify_hostname: true
    batch:
      max_events: 10000
      timeout_secs: 2
    buffer:
      type: disk
      max_size: 536870912
      when_full: block
    query_settings:
      async_insert_settings:
        enabled: false
변환은 임의의 애플리케이션 JSON을 event root에 merge하지 않고 고정된 스키마를 만듭니다. 앱의 kubernetes/namespace 필드가 Kubernetes metadata를 덮어쓸 수 없습니다. 잘못된 JSON은 message로 읽을 수 있고 파싱된 앱 object는 {}가 됩니다. Timestamp는 collector event 시각이며 앱이 임의로 주장하는 시각을 사용하지 않습니다.
512MiB disk buffer에는 실제 쓰기 가능한 영속 저장소와 용량 정책이 필요합니다. Backpressure가 kubelet log rotation을 무한히 막아주지는 않습니다. kubernetes_logs는 end-to-end acknowledgement를 지원하지 않는 best-effort file source입니다. Sink에 disk buffer가 있어도 exactly-once·무손실을 보장하지 않습니다. 이 host-log 수집 방식이 EKS Fargate 노드까지 포함하지도 않습니다.
검토에서는 환경·health check 없이 설정을 컴파일하고 합성 VRL 입력 10개를 실행했습니다. 실제 Kubernetes 접근·Secret mount·TLS handshake·ClickHouse 전달은 배포 환경에서 검증해야 합니다.
FluentBit을 통한 수집
Fluent Bit HTTP output은 newline-delimited JSON을 ClickHouse HTTP insert interface로 전송할 수 있습니다. CRI/Docker framing, Kubernetes metadata, RBAC, 쓰기 가능한 tail database/buffer를 갖춘 collector를 사용합니다. 바깥 CRI record와 앱 JSON은 다릅니다.
HTTP output 전에 각 record를 위와 같은 일반 컬럼 10개로 변환하고 timestamp 입력 형식을 일치시킵니다. 중첩된 kubernetes, 임의의 앱 key, 다른 이름의 timestamp가 있는 원본 record는 테이블 스키마와 다릅니다. Unknown column을 무조건 무시하여 불일치를 숨기지 않습니다.
인증서 검증을 켠 HTTPS와 별도 writer credential을 사용합니다. 선택한 Fluent Bit 버전이 HTTP output 설정에 password 문자열을 요구하면 보호된 Secret 기반 설정 파일을 렌더링합니다. 고정 Base64 admin:password header를 게시하지 않습니다. 이 문서의 완성된 정규화 예제는 Vector 경로이며, 제공하지 않은 Fluent Bit 변환·DaemonSet이 검증되었다고 주장하지 않습니다.
Kafka를 통한 버퍼링 (대규모 환경)
Kafka는 burst를 흡수하고 설정한 retention 안에서 replay를 제공할 수 있습니다. 필요한 장애 기간에 맞춰 인증/TLS·replication·acknowledgement·disk 용량을 구성합니다. Kafka 자체가 모든 손실·중복을 막는 것은 아닙니다.
ClickHouse Kafka engine은 consumer group으로 topic을 읽고 materialized view가 파싱한 행을 같은 저장 테이블로 전달합니다. Consumer 사이에 의도한 group/partition 할당을 유지하고 각 message를 모든 shard에 중복 저장하지 않도록 합니다. Lag·parser 오류·거부된 message를 관찰하며 credential은 SQL 예제가 아닌 관리되는 서버 설정에 둡니다.
Kafka engine 테이블은 위의 일반 default 컬럼을 지원하지 않습니다. 입력 필드만 정의하고 default/materialized 값은 대상·view에서 계산합니다. Offset commit, downstream insert acknowledgement, retry를 함께 검증합니다. 영속 처리 확인이 필요하면 메모리 Buffer를 대상으로 삼지 않습니다. 실험적인 Keeper 기반 offset 저장을 조건 없는 운영 기본값으로 활성화하지 않습니다.
SQL 쿼리
기본 쿼리
최근 오류는 자정을 넘어도 동작하는 상대 timestamp 범위로 검색합니다.
SELECT timestamp, namespace, service, pod_name, message
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
  AND namespace = 'production' AND level = 'error'
ORDER BY timestamp DESC LIMIT 100;
로그 수와 정확한 고유 Pod 이름 수를 계산합니다.
SELECT toStartOfMinute(timestamp) AS minute, service,
       count() AS log_events, countIf(level = 'error') AS error_events,
       round(100.0 * error_events / nullIf(log_events, 0), 2) AS error_log_percent
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
  AND namespace = 'production'
GROUP BY minute, service ORDER BY minute, service;

SELECT namespace, service, uniqExact(pod_name) AS distinct_pods_with_logs
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
GROUP BY namespace, service ORDER BY distinct_pods_with_logs DESC;error_log_percent는 오류로 표시된 로그 이벤트 비율입니다. 요청마다 관련 레코드가 정확히 하나라는 계약이 없으면 HTTP 실패율이 아닙니다. uniqExact는 정확한 집계, uniq는 근사 집계입니다. 두 쿼리는 관측된 로그를 설명하며 현재 Running Pod 수가 아닙니다.
고급 분석 쿼리
SELECT service, count(response_time_ms) AS measured_events,
       quantileExact(0.95)(response_time_ms) AS p95_ms
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
  AND namespace = 'production' AND isNotNull(response_time_ms)
GROUP BY service;

SELECT extract(message, '(TimeoutException|ConnectionError|OutOfMemoryError)') AS error_type,
       count() AS log_events
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY AND level = 'error'
GROUP BY error_type ORDER BY log_events DESC;

SELECT timestamp, service, pod_name, message
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY
  AND trace_id = '0123456789abcdef0123456789abcdef'
ORDER BY timestamp;
Latency에는 숫자 응답 시간이 있는 이벤트만 포함됩니다. quantileExact는 제한된 예제를 설명하기 좋지만 큰 데이터에서 많은 메모리를 사용할 수 있으므로 근사 집계도 검토합니다. extract는 일치하는 패턴이 없으면 빈 문자열을 반환하므로 미분류 그룹을 확인할 수 있습니다.
Trace ID는 32자리 hex 예시이지 실제 trace가 아닙니다. 서비스 간 전파·필드 일치가 선행 조건입니다. 민감한 query text·credential·고객 식별자를 제한 없이 로그에 저장하지 않습니다.
실시간 대시보드용 쿼리
SELECT toStartOfHour(timestamp) AS hour, namespace,
       count() AS log_events, sum(length(message)) AS message_bytes
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY
GROUP BY hour, namespace ORDER BY hour;

SELECT namespace, pod_name, count() AS backoff_log_events
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY
  AND positionCaseInsensitive(message, 'Back-off restarting failed container') > 0
GROUP BY namespace, pod_name;message_bytes는 message 문자열 byte 수이며 압축 저장량이나 network 청구량이 아닙니다. “Back-off” 문자열 일치도 로그 이벤트 수이지 실제 container restart 수가 아닙니다. Restart는 Kubernetes 상태 메트릭을 사용합니다. SQL SELECT는 한 시점의 조회이며 dashboard refresh interval이 반복 조회를 수행합니다.
Grafana 연동
ClickHouse 데이터소스 설정
Grafana 배포 방식으로 grafana-clickhouse-datasource 4.21.2를 설치·고정하고 해당 플러그인의 Grafana 요구 버전을 확인합니다. 아래 provisioning template은 scheme 없는 host, 숫자 port, HTTP protocol과 TLS, secureJsonData credential을 사용합니다.
apiVersion: 1
datasources:
  - name: ClickHouse
    uid: clickhouse-logs
    type: grafana-clickhouse-datasource
    access: proxy
    jsonData:
      host: logs-clickhouse.clickhouse.svc.cluster.local
      port: 8443
      protocol: http
      secure: true
      tlsSkipVerify: false
      tlsAuthWithCACert: true
      username: log_reader
      defaultDatabase: logs
      logs:
        defaultDatabase: logs
        defaultTable: application_logs_distributed
        timeColumn: timestamp
        levelColumn: level
        messageColumn: message
    # Filled by the file-to-file renderer before provisioning.
    secureJsonData: {}
Provisioning 전에 빈 credential map을 채웁니다. 아래 file-to-file renderer는 mount한 password·CA를 읽으며 Python과 PyYAML이 필요합니다. Secret을 stdout에 쓰지 않고 Grafana provisioning을 위해 literal $를 escape합니다. 완성된 파일 전체를 ConfigMap이나 Git artifact가 아닌 Secret으로 취급합니다.
"""Render a complete Secret-backed provisioning file; requires PyYAML."""
import os
from pathlib import Path
import sys
import tempfile
import yaml

template, password_path, ca_path, output = map(Path, sys.argv[1:])
config = yaml.safe_load(template.read_text())
password = password_path.read_text().rstrip("\r\n")
ca = ca_path.read_text()
if not password or "-----BEGIN CERTIFICATE-----" not in ca:
    raise ValueError("A nonempty password and PEM CA file are required")
# Grafana provisioning expands $ variables even in quoted YAML scalars.
# Escape literal dollars; do not interpolate secrets through process environment.
config["datasources"][0]["secureJsonData"] = {
    "password": password.replace("$", "$$"),
    "tlsCACert": ca.replace("$", "$$"),
}
fd, temporary = tempfile.mkstemp(prefix=".clickhouse-", dir=output.parent)
try:
    with os.fdopen(fd, "w") as stream:
        yaml.safe_dump(config, stream, sort_keys=False)
    os.replace(temporary, output)
finally:
    if os.path.exists(temporary):
os.unlink(temporary)python3 render-grafana.py grafana-template.yaml \
/run/secrets/clickhouse/password /run/secrets/clickhouse/ca.crt \
/run/grafana-provisioning/clickhouse.yaml대상 디렉터리는 보호된 writable volume에 미리 있어야 합니다. Grafana 프로세스가 읽을 수 있도록 소유권·권한을 설정하고 완성된 파일을 datasource provisioning 경로에 mount합니다. Secret 변경만으로 datasource reload가 완료되었다고 가정하지 않습니다. Reader 계정·CA 검증·실제 query를 확인합니다. “Save & test” 성공만으로 모든 query setting 권한이 입증되지는 않습니다.
Grafana 대시보드 패널
Time과 숫자를 반환하는 query에는 Time series를 선택합니다.
SELECT $__timeInterval(timestamp) AS time, count() AS log_events
FROM logs.application_logs_distributed
WHERE $__timeFilter(timestamp) AND namespace = 'production'
GROUP BY time ORDER BY time;
개별 레코드는 설정한 timestamp·level·message 컬럼으로 Logs/Explore에서 확인합니다. Grafana가 macro를 SQL 전송 전에 확장하므로 $__timeFilter 자체는 실행 가능한 ClickHouse SQL이 아닙니다.
알림 규칙
clickhouse_custom_query{query="..."}라는 가상의 Prometheus metric 대신 해당 datasource의 Grafana Alerting을 사용합니다.
SELECT countIf(level = 'error') AS value
FROM logs.application_logs_distributed
WHERE $__timeFilter(timestamp) AND namespace = 'production';
숫자 행 하나에는 Table format, Reduce/Last, “10 초과” 같은 threshold를 선택합니다. 평가 간격·시간 범위·pending period·contact policy를 명시합니다. 10은 학습 예제 기준이며 운영 권장값이 아닙니다. Prometheus groups/rules/expr와 Grafana alerting schema를 섞지 말고 실제 Grafana 버전에서 설정한 provisioning을 export합니다.
countIf는 수집된 행이 전혀 없어도 0을 반환할 수 있습니다. 예약된 합성 heartbeat처럼 수집 상태를 별도로 관찰합니다.
SELECT $__timeInterval(timestamp) AS time, count() AS value
FROM logs.application_logs_distributed
WHERE $__timeFilter(timestamp) AND service = 'log-heartbeat'
GROUP BY time ORDER BY time;
Heartbeat가 없으면 이 쿼리의 time series 행도 없습니다. No Data와 실행 오류 정책을 정하고 수집 지연·실제 알림 전달을 검증합니다.
HyperDX (ClickHouse 네이티브 뷰어)
핵심 장점
HyperDX는 ClickStack의 observability UI입니다. 기존 ClickHouse 테이블을 source로 구성할 수 있으므로 custom schema 자체가 지원되지 않는 것은 아닙니다. Timestamp·message/body·severity·service·trace 필드를 실제 스키마에 매핑하고 connection·제한된 계정·대표 레코드 검색을 확인합니다.
Buffer/Store/Distributed 명명 규칙이 자동 source 발견을 보장하거나 언제나 20배 빠르다고 설명하지 않습니다. HyperDX application/API 2.38.0과 별도 버전의 CLI는 다른 artifact입니다. 이 문서가 custom cluster 위에 새 ClickStack 배포를 지시하거나 실제 통합 실행을 주장하지는 않습니다.
로그 뷰어 비교
| 뷰어 | 검토할 적합성 |
|---|---|
| Grafana + ClickHouse plugin | SQL, 기존 dashboard, alerting, 여러 datasource의 연계 |
| HyperDX / ClickStack | 명시적으로 구성한 source/schema의 observability 검색·상관관계 |
| SigNoz | 자체 ingestion/model과 UI; SigNoz도 ClickHouse 사용 |
각 component의 실제 수집 스키마·인증·조회 과정·지원 릴리스·license를 비교합니다. ClickHouse 데이터베이스가 있다고 모든 observability UI가 그대로 호환되는 frontend가 되지는 않습니다.
성능 최적화
테이블 설계 최적화
선택도가 높은 주요 필터와 locality에 맞게 ORDER BY를 정합니다. 자주 조회하는 모든 컬럼을 무조건 앞에 두는 규칙은 아닙니다. 반복되는 namespace/service/level에는 LowCardinality(String)이 유용할 수 있지만 고정된 distinct-value 상한 대신 실제 dictionary 크기·쿼리 동작을 평가합니다.
Partition은 보존 관리와 merge 효율에 맞춰 정합니다. 90일 동안 시간별 partition을 보존하면 대략 2,160개가 남을 수 있으며 전체가 24~48개뿐인 것은 아닙니다. 지연 이벤트는 오래된 partition에도 기록될 수 있습니다.
Parts 최적화
SELECT partition, count() AS active_parts,
       sum(rows) AS rows, sum(bytes_on_disk) AS bytes_on_disk
FROM system.parts
WHERE active AND database = 'logs' AND table = 'application_logs'
GROUP BY partition ORDER BY partition;

SELECT database, table, is_readonly, is_session_expired,
       queue_size, absolute_delay
FROM system.replicas
WHERE database = 'logs';

SELECT database, table, is_blocked, error_count, last_exception
FROM system.distribution_queue WHERE database = 'logs';
System table 쿼리는 연결한 서버의 상태를 보여줍니다. 클러스터 운영에서는 관련 replica/shard를 모두 확인합니다. Part 생성·merge·replication lag·Distributed queue를 관찰하고 작은 insert를 batch로 묶습니다. 특정 part 개수·크기가 모든 workload의 기준은 아닙니다. 작은 insert 문제를 해결하는 대신 OPTIMIZE FINAL을 일상적으로 실행하지 않습니다.
쿼리 최적화
가능하면 timestamp와 선행 sort-key 컬럼을 필터링하고 필요한 컬럼만 읽습니다. EXPLAIN과 query log의 read rows/bytes를 확인합니다. 낮은 cardinality 컬럼이 항상 최선의 선행 key는 아니므로 실제 query mix로 검증합니다.
기본 로그 테이블에는 sampling expression이 없으므로 SAMPLE 0.1을 덧붙이면 잘못된 쿼리입니다. 별도 예제는 primary/sort key에 포함된 결정적 unsigned sampling key를 정의할 수 있습니다.
CREATE TABLE logs.sample_demo
(
    event_id UInt64,
    message String
)
ENGINE = MergeTree
ORDER BY cityHash64(event_id)
SAMPLE BY cityHash64(event_id);

SELECT count() * 10 AS estimated_events
FROM logs.sample_demo SAMPLE 0.1;
비율은 sampling-key 구간이며 유한한 행 집합의 정확히 10%를 보장하지 않습니다. 가산 count는 적절히 보정하되 평균·percentile에 10을 곱하지 않습니다. 표본이 분석 질문에 적합한 대표성도 가져야 합니다.
시스템 설정 최적화
max_threads, max_memory_usage는 query/user profile 설정입니다. 임의의 최상위 server XML 대신 profile이나 query setting에 둡니다. Server cache·background pool은 개별 query 제한 밖에서도 자원을 사용합니다. Pod memory limit에는 동시 query·merge·수집 buffer를 함께 고려합니다.
제한된 workload로 CPU throttling·메모리·I/O·merge backlog·복구를 관찰한 뒤 설정을 조정합니다. 낮은 query limit이 전체 프로세스 상한이 되지는 않습니다.
리소스 가이드라인
일일 수집량·실측 압축률·보존일·replication·동시 query·peak merge/insert 오버헤드로 계산합니다. 예를 들어 1TB/day에 측정한 5:1 감소율을 적용하면 약 200GB/day이며 90일은 replication·운영 여유 전 약 18TB입니다. Replica 2개면 저장 복사본도 대략 두 배입니다. 이는 산술 예시이지 실측 용량이나 AWS 청구서가 아닙니다.
EKS에서는 EBS 용량·성능, AZ 간 전송, node architecture, 장애 도메인, 교체 capacity도 고려합니다. Fargate는 node 기반 collector/ClickHouse와 같은 host-log·volume topology를 제공하지 않습니다.
S3 아카이빙 및 장기 보관
아카이빙 파이프라인
두 설계를 구분합니다.
- Cold table storage: ClickHouse가 설정한 S3 disk/volume의 part와 metadata를 관리합니다. Local metadata를 보존하고 선택한 disk 설계에 맞게 replica별 object namespace를 분리합니다. 살아 있는 ClickHouse 테이블이 소유한 object를 외부 lifecycle로 임의 삭제하지 않습니다.
- 독립 archive: 선택한 행을 버전·inventory가 있는 Parquet object로 export합니다. 완전성·지연 데이터·접근 통제·복구/조회 검증을 따로 정의합니다.
Cold storage는 서버에 cold volume이 있는 storage policy를 만들고 테이블에서 그 policy를 명시적으로 선택합니다.
-- Separate example: the server must already define the logs_tiered policy.
CREATE TABLE logs.tiered_example
(
    timestamp DateTime,
    message String
)
ENGINE = MergeTree
ORDER BY timestamp
TTL timestamp + INTERVAL 7 DAY TO VOLUME 'cold',
    timestamp + INTERVAL 90 DAY DELETE
SETTINGS storage_policy = 'logs_tiered';
이 예제 생성 전 logs_tiered가 있어야 합니다. TTL 작업은 비동기이며 행별 정확한 삭제 deadline이 아닙니다. TTL이 S3 권한이나 storage policy를 생성하지도 않습니다. 검토에서는 local disk로 policy 동작을 확인했으며 S3 배포는 실행하지 않았습니다.
서버 workload의 AWS identity, bucket/prefix로 제한한 권한, private bucket 설정, 암호화와 필요한 KMS 권한을 사용합니다. use_environment_credentials만 지정해도 ServiceAccount identity 연결이 생기거나 선택한 ClickHouse build의 credential provider 지원이 입증되는 것은 아닙니다.
S3 직접 아카이빙
다음 2025년 1월 범위는 과거 날짜를 사용한 문법 예시입니다. Benchmark가 아니며 90일 TTL 테이블에 해당 데이터가 지금도 있다는 뜻이 아닙니다. Bucket·범위·RUN_ID를 소유한 archive job의 값으로 바꿉니다.
-- Historical January 2025 example; replace range and the unique owned export prefix.
INSERT INTO FUNCTION s3(
    'https://EXAMPLE-ARCHIVE.s3.ap-northeast-2.amazonaws.com/logs/export-RUN_ID/{_partition_id}.parquet',
    'Parquet'
)
PARTITION BY toYYYYMMDD(timestamp)
SELECT timestamp, level, namespace, service, pod_name, container_name,
       node_name, message, trace_id, raw_json
FROM logs.application_logs_distributed
WHERE timestamp >= toDateTime64('2025-01-01 00:00:00', 3, 'UTC')
  AND timestamp < toDateTime64('2025-02-01 00:00:00', 3, 'UTC')
SETTINGS s3_truncate_on_insert = 0,
         s3_create_new_file_on_insert = 0,
         output_format_parquet_compression_method = 'zstd';
PARTITION BY가 {_partition_id} 값을 제공합니다. Distributed source가 의도한 shard를 포함해야 하며 로컬 replica 하나를 export하는 것만으로 전체 sharded cluster를 보관할 수 없습니다. 실행마다 새로 예약한 prefix를 사용하고 공용 filename에 무작정 쓰지 않습니다. 위 설정은 overwrite·자동 추가 파일을 막지만 분산 lock이나 부분 export의 atomicity를 구현하지 않습니다.
의도한 Distributed topology로 shard당 authoritative copy 하나를 선택합니다. 모든 replica를 union하여 중복 집계하지 않습니다. 완료 선언이나 원본 retention 변경 전에 export 행 수·시각 범위·schema·대표 집계·object 읽기를 확인합니다.
워터마크 기반 진행 상태 추적
Watermark는 진행 기록이지 완전성 증거가 아닙니다. 일반 MergeTree는 job key의 uniqueness나 compare-and-swap lock을 강제하지 않습니다. 단일 owner 또는 외부 transactional lease/state store로 동시 job을 제어합니다.
Job ID, source cluster/table/schema 버전, 끝 시각을 제외한 범위, shard coverage, output prefix/object manifest, 검증 결과를 기록합니다. 예상 output을 모두 확인한 뒤 완료로 표시합니다. 부분 export retry의 소유권 정책과 겹치는 범위의 deduplication을 명시합니다.
Late-arrival delay는 실제 데이터로 정합니다. 고정된 “3일 후 merge” 가정은 과거 partition을 쓰기 금지로 만들거나 모든 지연 이벤트 도착을 보장하지 않습니다. 정정·replay를 처리하고 export 실패 시 이전 성공 watermark를 유지합니다.
아카이브 데이터 직접 쿼리
SELECT namespace, service, count() AS log_events
FROM s3(
    'https://EXAMPLE-ARCHIVE.s3.ap-northeast-2.amazonaws.com/logs/export-RUN_ID/*.parquet',
    'Parquet'
)
WHERE timestamp >= toDateTime64('2025-01-01 00:00:00', 3, 'UTC')
  AND timestamp < toDateTime64('2025-02-01 00:00:00', 3, 'UTC')
GROUP BY namespace, service;
완료·검증된 export prefix만 조회합니다. Restore가 필요한 archive storage class는 먼저 복원해야 일반 S3 읽기가 가능합니다. Region, 저장 byte, storage class, request/retrieval, replication, retention을 반영해 비용을 계산합니다. 모든 환경에 적용하는 “90% 압축”이나 “원본 TB-month당 $2.3”은 이 전제를 숨깁니다.
참고 자료와 검증 범위
- ClickHouse LTS 릴리스
- Altinity Operator 릴리스
- Buffer engine과 제한
- Kafka engine
- Sampling
- S3 table function
- Vector ClickHouse sink
- Vector Kubernetes source
- Vector secret backend
- Grafana ClickHouse 설정
- Grafana ClickHouse alerting
- HyperDX source
로컬 native 검사는 SQL 파싱, 합성 schema/query 동작, Vector 변환, operator chart 렌더링과 schema/configuration 계약을 확인합니다. Cluster 호환성·HA/failover·실제 Kafka/S3 수집·IAM·TLS·운영 용량을 입증하지 않습니다. 실제 환경에서 해당 조건을 검증한 뒤 설계를 사용합니다.
퀴즈
ClickHouse 퀴즈로 내용을 확인합니다.