LLM 서빙을 위한 추론 프레임워크
검토 기준: 2026년 9월 12일 확인한 공식 릴리스·API·차트와 로컬 검증. GPU/Neuron 모델 실행 결과가 아닙니다. 마지막 업데이트: 2026년 10월 12일
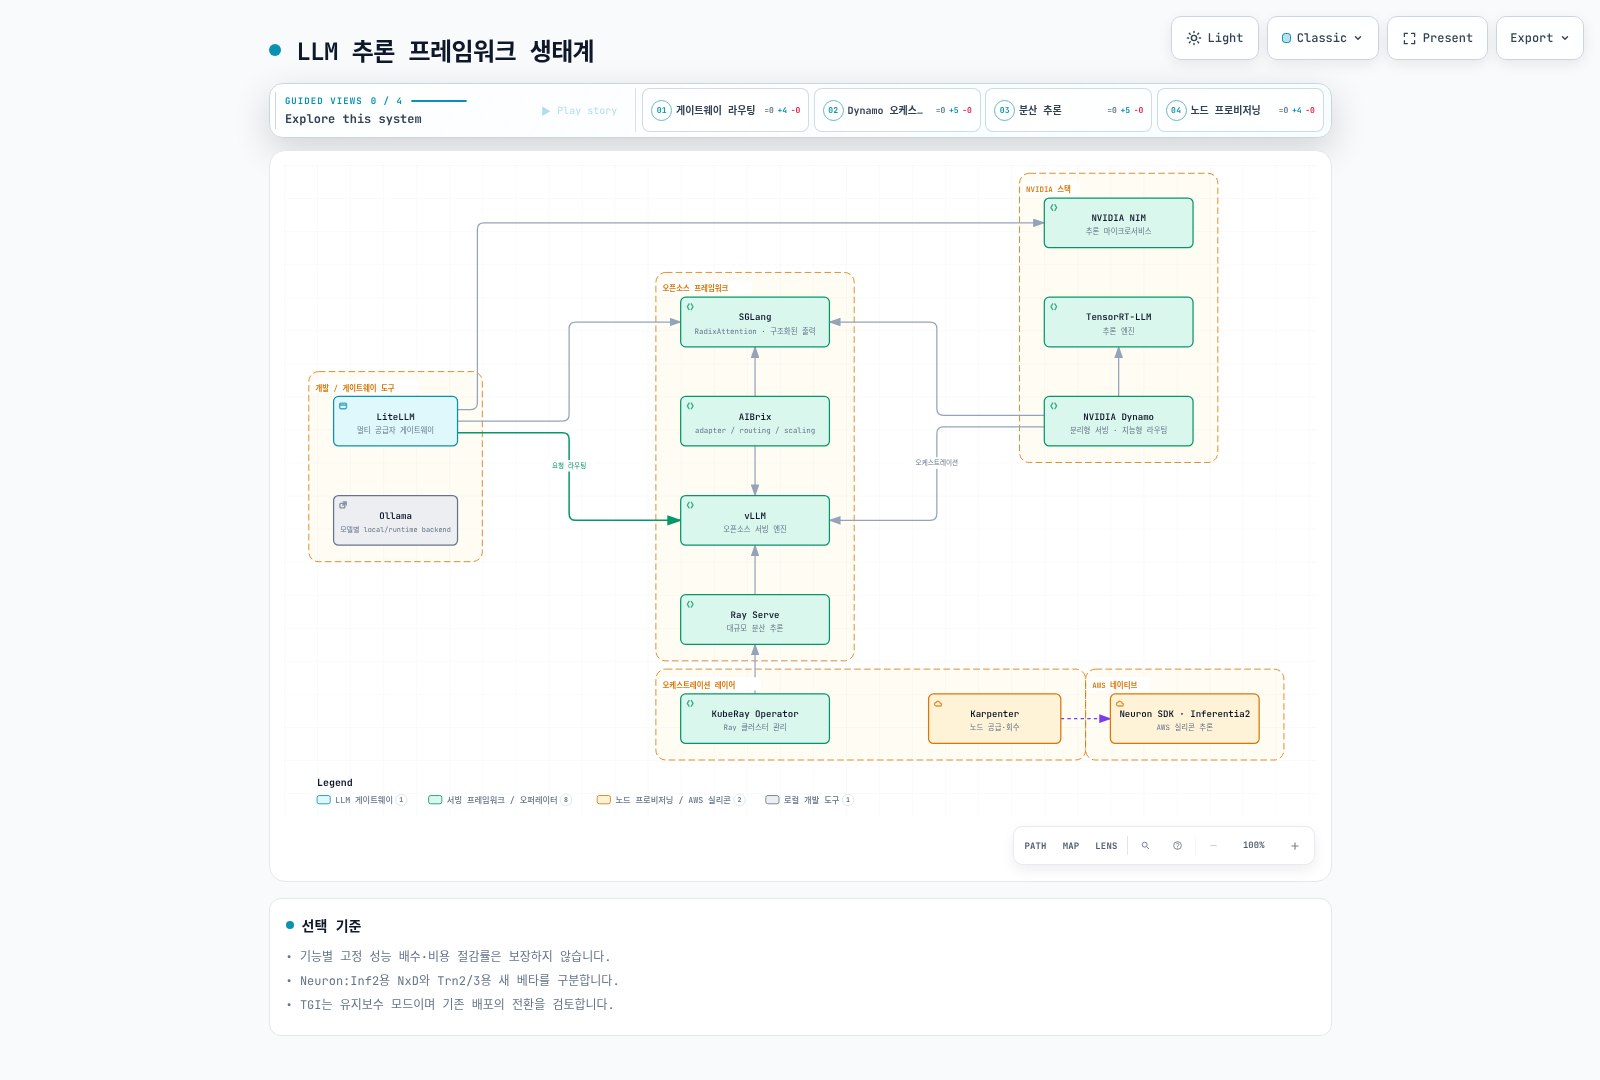
추론 엔진, 분산 실행 계층, Kubernetes controller와 provider gateway를 구분해 선택해야 합니다. 같은 “OpenAI 호환” 표현도 지원 endpoint·요청 필드·streaming·tool call·인증이 완전히 같다는 뜻은 아닙니다.
추론 프레임워크 생태계
| 구성 | 확인한 기준 | 선택 시 확인할 점 |
|---|---|---|
| NIM LLM/VLM | 2.0.12 문서; 3.0 별도 제품 경로 | 모델·profile·장치·지원 계약과 backend |
| Dynamo | 1.4.2 | aggregated/disaggregated, KV 전송, planner와 controller |
| AIBrix | 0.7.0 | Envoy Gateway, adapter/controller, autoscaler |
| SGLang | 0.5.19 | 모델·grammar backend·장치·실제 부하 |
| vLLM / Ray Serve | vLLM 0.29.0 / Ray 2.58.0 / KubeRay 1.7.0 | 각각 검증된 이미지·모델·controller 조합 |
| TGI | 3.3.7; 유지보수 모드 | 기존 시스템 유지와 새 엔진 전환 계획 |
| Ollama | 0.34.0 | 로컬 API 접근, 모델 저장·사전 준비 |
| LiteLLM | 1.100.1 | provider 변환, 인증·fallback·비용 계측 |
| Neuron | SDK 2.32.0; Helm 1.10.0 | Inf2/Trn별 plugin·compiler·driver 조건 |
vLLM은 이 표의 기존 로컬 검증 기준인 0.29.0 이후 0.31.0이 2026년 10월 5일 공개됐습니다. 표의 버전은 확인한 조합을 뜻하며 최신 릴리스나 서로 호환되는 전체 조합을 뜻하지 않습니다. vLLM 0.31.0의 요청별 멀티모달 인자 기본 차단 등은 배포 장의 업데이트를 확인하세요.
버전별 기능 표를 단순한 지원/미지원으로 고정하지 않습니다. 예를 들어 Dynamo의 planner, vLLM/SGLang의 분리 서빙과 CPU·GGUF 지원은 릴리스·backend·장치에 따라 달라집니다. adapter 로딩이나 model alias는 tenant 인증 경계가 아닙니다.
NVIDIA NIM
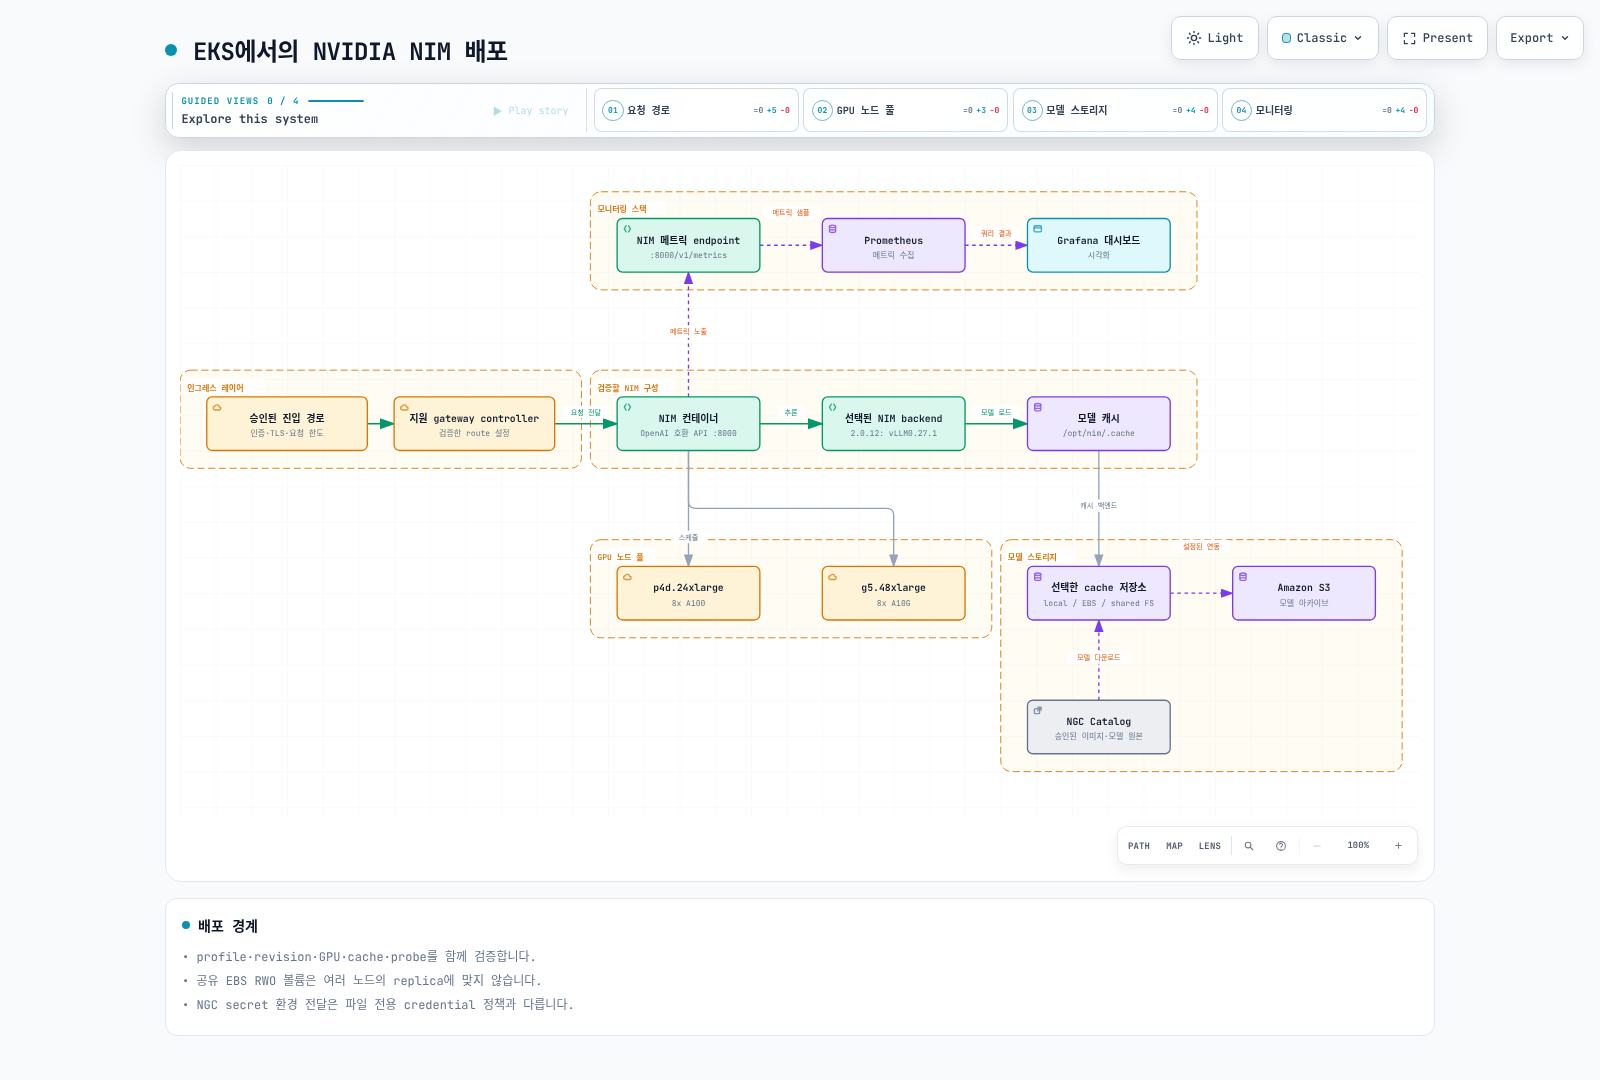
NIM의 컨테이너, 모델 profile, GPU 조건과 지원 계약을 함께 확인합니다. NIM Operator 3.1.2는 LLM/VLM 컨테이너 2.0.12와 별도 릴리스입니다. 검토한 2.0.12는 vLLM 0.27.1 backend를 설명하며, 모든 NIM이 항상 TensorRT-LLM을 쓰는 것은 아닙니다. 3.0의 Dynamo 기반 분산 경로를 2.0과 동일 배포법으로 취급하지 마세요.
배포 준비와 profile
GPU 가이드의 AMI·driver/toolkit·device plugin 조건을 사용하세요. GPU Operator를 항상 driver.enabled=true로 설치하면 제공 AMI의 driver와 충돌할 수 있습니다. Karpenter의 NodePool/EC2NodeClass, 실제 schedulable CPU/RAM/GPU와 장치 수를 확인합니다. 8GPU Pod에는 1/4GPU 노드를 선택할 수 없으며, Custom AMI는 EKS bootstrap을 별도로 구현해야 합니다.
현재 선택 변수는 NIM_MODEL_PROFILE이며 지원되는 profile ID 또는 이름을 컨테이너의 profile 목록에서 확인합니다. 예전 NIM_MANIFEST_PROFILE과 임의 vllm-bf16-tp8 문자열을 유효하다고 가정하지 마세요. image digest, model revision, profile, driver와 실제 검증 결과를 함께 기록합니다.
NGC 이미지 pull credential과 실행 중 모델 다운로드 credential은 역할이 다릅니다. 공식 NGC 다운로드 경로의 NGC_API_KEY 환경 변수 전달은 파일 전용 credential 정책을 충족하지 않습니다. 승인된 방식으로 사전 준비한 모델 경로나 검증한 credential adapter를 사용해야 하며, shell 인자·코드에 실제 키를 쓰지 않습니다. 내부 Service라는 이유만으로 추론 호출이 인증되는 것도 아닙니다.
단일 EBS RWO PVC를 서로 다른 노드의 여러 replica가 동시에 공유하는 구성은 피합니다. replica별 볼륨/로컬 cache 또는 적합한 공유 파일시스템을 선택하고, 다운로드 실패·스토리지 성능·startupProbe·롤아웃을 검증합니다. 모든 모델이 이미지에 포함되거나 모든 cache가 FSx/S3와 자동 동기화되는 것은 아닙니다.
메트릭과 GenAI-Perf
검토한 NIM 2.0.12 문서의 메트릭 경로는 /v1/metrics이며 backend의 vLLM 메트릭을 전달합니다. 이전의 임의 nim_* 이름과 /metrics를 그대로 복사하지 말고 실제 endpoint의 이름·단위·label을 확인합니다. Prometheus scrape와 Grafana datasource/sidecar를 구성해야 대시보드 ConfigMap이 사용됩니다. 초 단위 값을 ms 패널에 그대로 그리지 마세요.
TTFT, ITL, end-to-end latency, 성공 요청 처리량과 queue를 workload별 SLO로 정합니다. 일정한 간격을 가정한 end-to-end 근사는 TTFT + (출력 token 수 - 1) × ITL이며 후처리·네트워크 overhead는 별도입니다. 500ms·GPU 80% 같은 수치는 모든 모델의 보편적인 정상 기준이 아닙니다.
GenAI-Perf 0.0.16의 CLI에는 profile subcommand와 synthetic-input-tokens-mean/output-tokens-mean 옵션이 있습니다. 아래는 이미 준비된 내부 endpoint에 부하를 발생시키는 명령 형식이며, 이번 검토에서는 실행하지 않았습니다. perf_analyzer·tokenizer 등 해당 배포판 의존성을 먼저 준비하세요.
genai-perf profile --endpoint-type chat --service-kind openai --url http://127.0.0.1:8000 --model approved-model-alias --concurrency 2 --synthetic-input-tokens-mean 128 --output-tokens-mean 64 --num-prompts 20 --profile-export-file profile_export.jsonanalyze는 단순히 JSON 파일을 읽는 후처리 명령으로 간주하지 마세요. sweep 조건에 따라 추가 profiling을 수행할 수 있습니다. raw 요청·응답/실패 수·tokenizer·warm-up·동시성·model/backend revision을 함께 보관하고, GPU 활용률에는 실제 metrics 수집이 필요합니다.
NVIDIA Dynamo
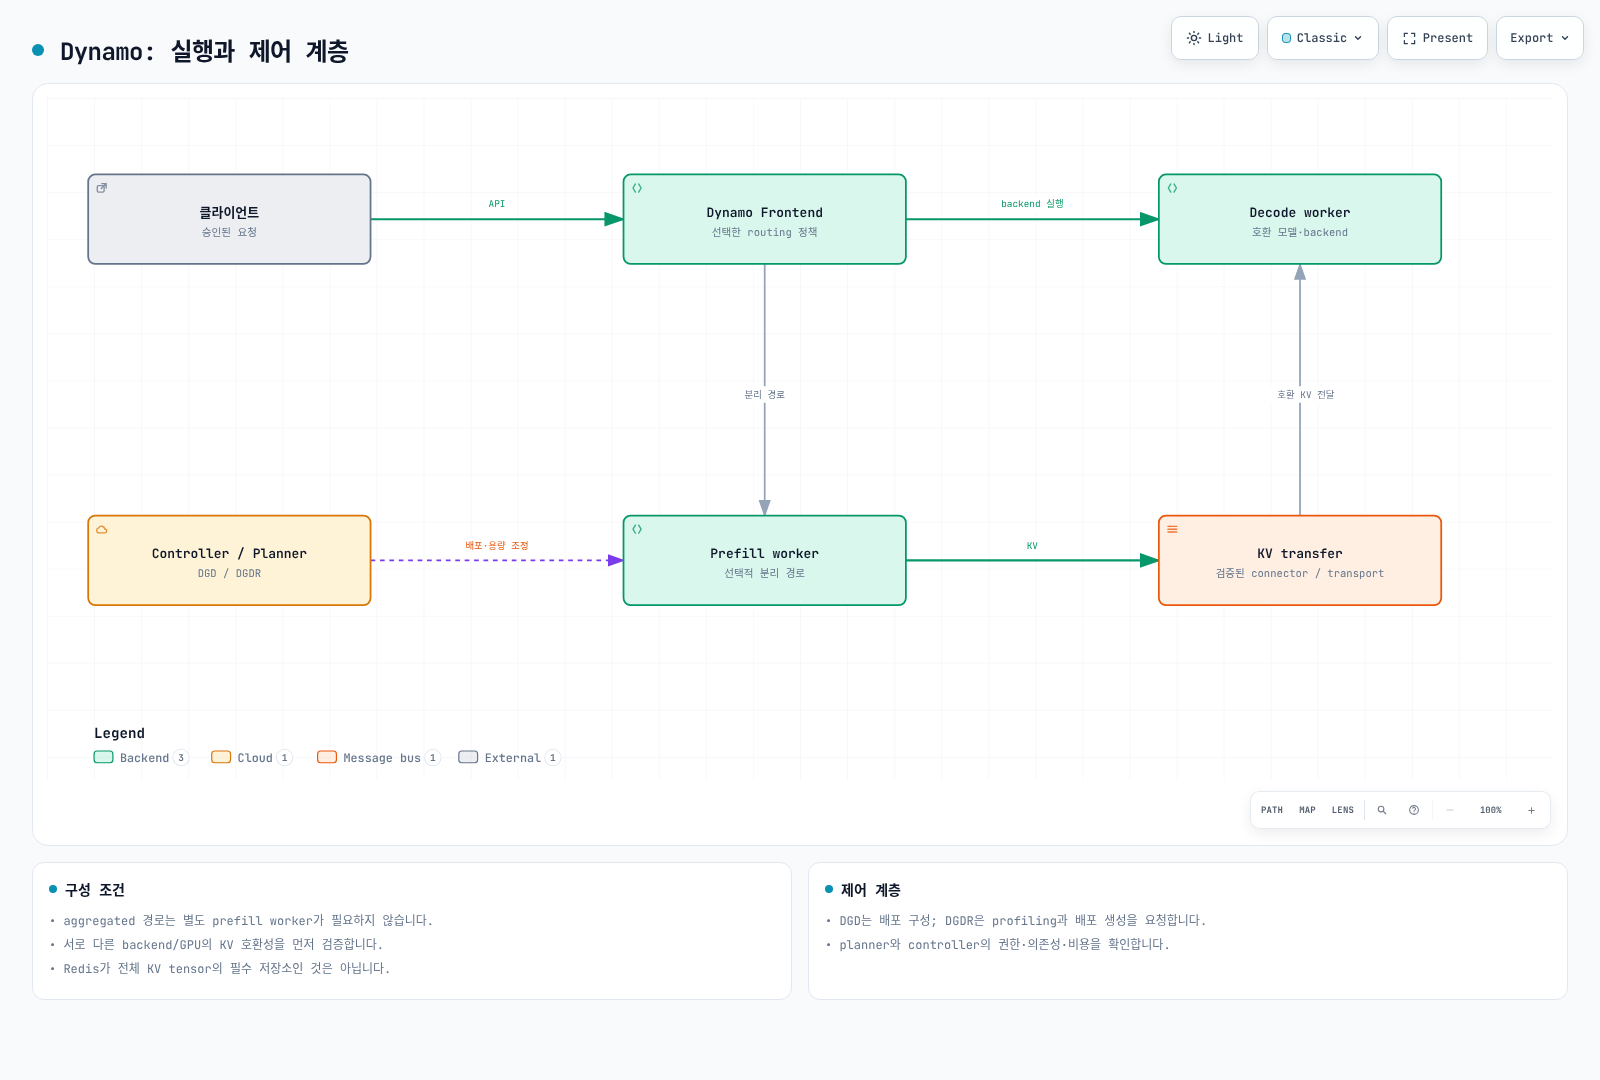
1.4.2의 공식 Kubernetes 경로는 Dynamo platform과 DynamoGraphDeployment(DGD), DynamoGraphDeploymentRequest(DGDR) 등을 사용합니다. 기존의 가짜 dynamo-router/dynamo-worker 이미지, KV_CACHE_HOST와 임의 router YAML로 구성되지 않습니다. DGDR은 profiling과 DGD 생성을 요청하므로 읽기 전용 검사 명령이 아닙니다.
실제 DGD 구조
다음은 공식 1.4.2 v1beta1 aggregated 예제를 토대로 public 모델과 작은 실행 한도를 지정한 스키마 검증용 구성입니다. platform/controller·namespace·GPU·모델 접근·네트워크를 별도로 준비해야 합니다. model/image digest와 실장치 검증은 배포 전에 추가해야 하며, 이번 검토에서 모델을 실행하지 않았습니다.
apiVersion: nvidia.com/v1beta1
kind: DynamoGraphDeployment
metadata:
  name: vllm-agg
  namespace: dynamo-system
spec:
  components:
  - name: Frontend
    podTemplate:
      spec:
        containers:
        - image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.2
          name: main
          resources:
            requests:
              cpu: 250m
              memory: 512Mi
            limits:
              cpu: '1'
              memory: 2Gi
    replicas: 1
    type: frontend
  - name: VllmDecodeWorker
    podTemplate:
      spec:
        containers:
        - args:
          - --model
          - Qwen/Qwen3-0.6B
          - --max-model-len
          - '2048'
          - --max-num-seqs
          - '8'
          command:
          - python3
          - -m
          - dynamo.vllm
          image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.2
          name: main
          resources:
            limits:
              nvidia.com/gpu: '1'
              cpu: '4'
              memory: 12Gi
            requests:
              ephemeral-storage: 2Gi
              cpu: '2'
              memory: 4Gi
          workingDir: /workspace/examples/backends/vllm
    replicas: 1
    type: worker
분리형 경로는 decode/prefill 역할, KV connector·메모리 형식·모델 revision과 네트워크가 맞아야 합니다. 서로 다른 backend나 GPU를 임의로 섞는다고 호환되지 않습니다. KV-aware routing은 cache 지역성과 부하를 함께 고려하며 고정된 0.7/0.3 공식이 모든 버전의 구현은 아닙니다. Redis는 Dynamo 전체의 필수 KV tensor 저장소가 아닙니다.
검토한 platform chart의 cluster-wide operator는 crd-apply init container로 CRD를 관리합니다. upgradeCRD=false는 외부 관리 경로이며 CRD가 불필요하다는 뜻이 아닙니다. planner·discovery·NATS/etcd·Grove/KAI 등은 chart 설정과 릴리스별 요구를 확인하세요. chart 렌더링은 CRD 적용·권한·실제 서비스 발견을 검증하지 않습니다.
AIBrix
0.7.0은 Envoy Gateway와 gateway plugin, controller-manager, metadata service 등을 사용합니다. KubeRay는 Ray 기반 기능을 사용할 때의 선택 의존성입니다. 문서에 있던 독립 aibrix-registry 서버와 /v1/lora/register API는 검증된 0.7.0 설치 경로가 아닙니다.
ModelAdapter와 PodAutoscaler
ModelAdapter의 실제 필드는 baseModel, podSelector, artifactURL 등입니다. replicas를 생략하면 모든 matching Pod에, 1이면 선택된 한 Pod에 adapter를 로드하며 다른 수치는 허용되지 않습니다. 다음 bucket/revision과 base model은 환경에 맞게 교체할 값입니다. controller의 다운로드 권한, 지원 runtime과 adapter 크기·수명·tenant 접근을 별도로 검증하세요.
apiVersion: model.aibrix.ai/v1alpha1
kind: ModelAdapter
metadata:
  name: support-lora
  namespace: ai-inference
spec:
  baseModel: approved-base-model
  podSelector:
    matchLabels:
      model.aibrix.ai/name: approved-base-model
  artifactURL: s3://REPLACE_WITH_APPROVED_BUCKET/adapters/support/REVISION/
  replicas: 1
PodAutoscaler 0.7.0 사용 예시는 다음과 같습니다. metricsSources와 HPA/KPA/APA 전략을 사용하며 임의 autoscaler ConfigMap만 생성해서 작동하지 않습니다. CPU 예제는 metrics-server와 workload의 CPU requests, controller가 필요하며 GPU queue 기반 scaling을 검증한 결과가 아닙니다. 동일 target에 경쟁하는 scaler를 두지 마세요.
apiVersion: autoscaling.aibrix.ai/v1alpha1
kind: PodAutoscaler
metadata:
  name: model-cpu
  namespace: ai-inference
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: prepared-model-server
  minReplicas: 1
  maxReplicas: 3
  scalingStrategy: HPA
  metricsSources:
  - metricSourceType: resource
    targetMetric: cpu
    targetValue: '70'
Ray Serve 통합
Ray Serve 가이드와 KubeRay 가이드의 검토한 API를 사용합니다. KubeRay controller, Ray worker autoscaler와 Serve replica autoscaler는 서로 다른 역할입니다. RayCluster를 일반 Deployment처럼 HPA scaleTarget으로 지정하지 마세요. 생성되는 RayCluster/Serve Service 이름·selector를 임의로 추측하지 않습니다.
모델 실행 코드와 의존성은 head뿐 아니라 실행될 worker에도 있어야 합니다. user_config는 constructor 인자를 자동 변경하지 않으며 reconfigure 경로 등 구현을 확인해야 합니다. 모델의 실제 chat template, stream·cancel·finish_reason·usage·오류를 처리해야 호환 API가 됩니다. 단순히 prompt에 역할 문자열을 붙이고 stream=true를 무시하는 예제는 OpenAI 호환 서버가 아닙니다. 2.9 이미지와 1.1 operator 예제, 무조건 trust_remote_code=True 설정은 제거했습니다.
SGLang
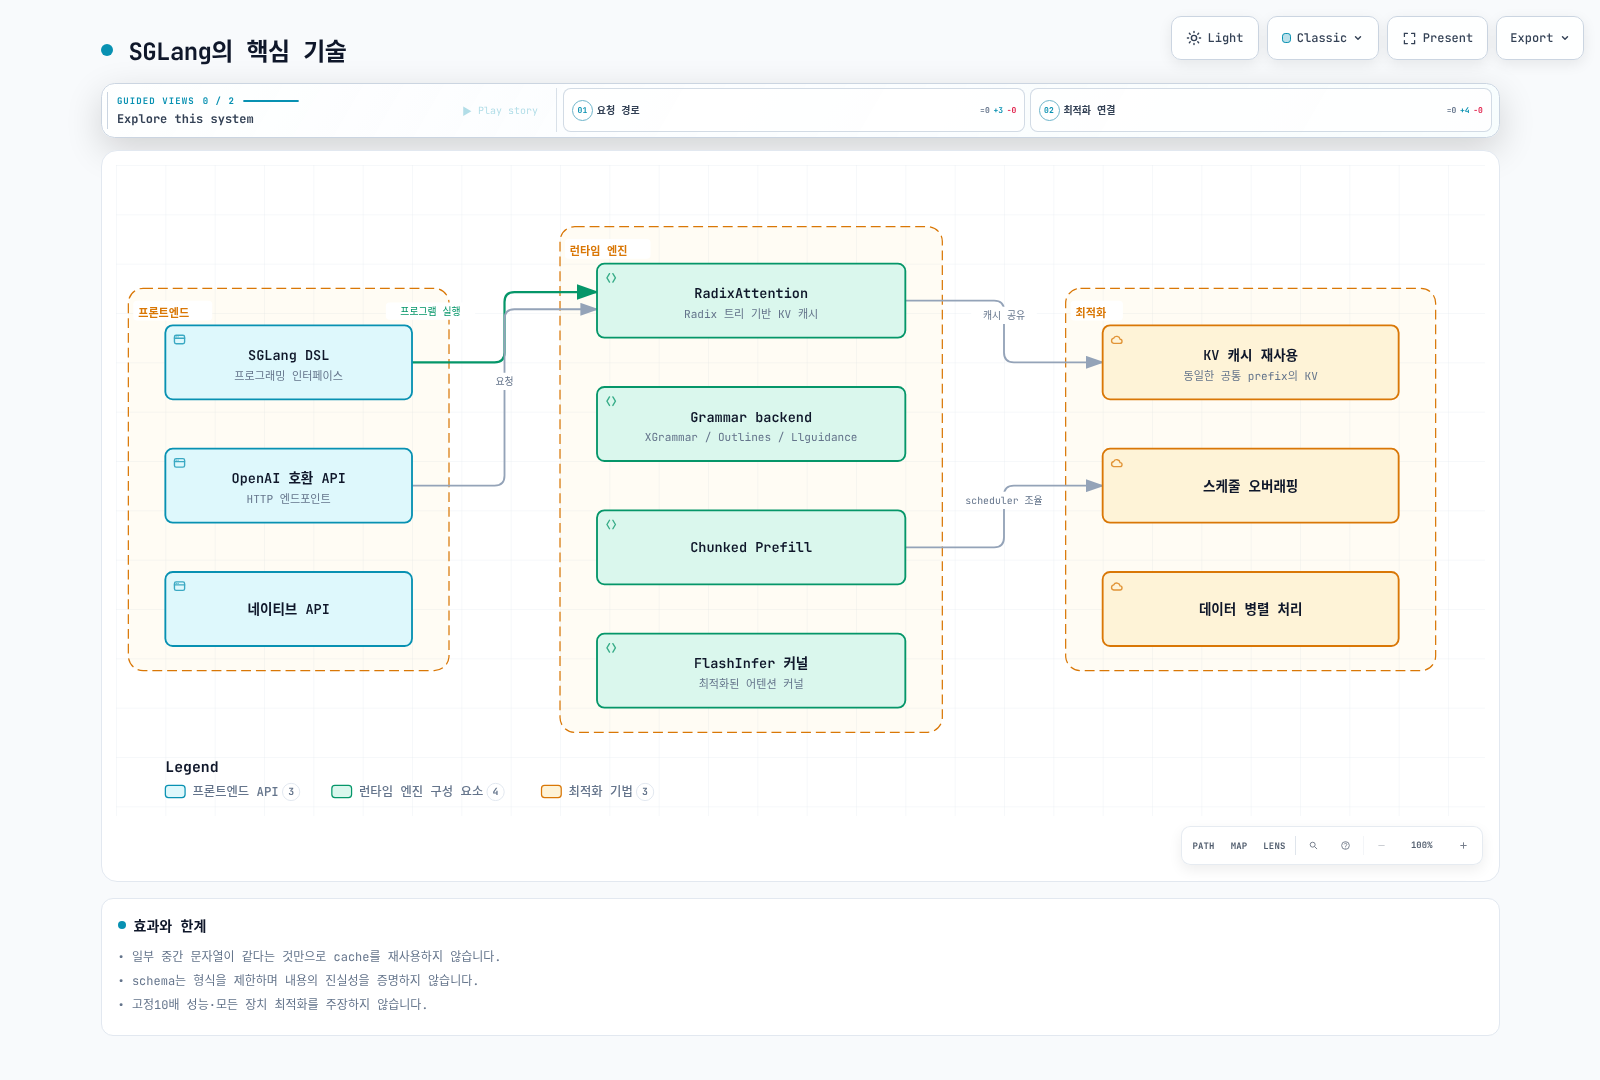
0.5.19의 RadixAttention은 공통 prefix의 KV 재사용을 위한 구조입니다. 임의로 겹치는 중간 substring이 동일 cache처럼 재사용된다는 뜻은 아닙니다. 모델·KV 형식·cache 접근 정책을 맞춰야 합니다. 현재 grammar backend는 기본 XGrammar와 Outlines/Llguidance 선택 경로이며 “압축 FSM 덕분에 항상10배 빠름”을 일반 결론으로 쓰지 않습니다.
구조화 요청 예제
아래는 승인된 gateway가 SGLang의 json_schema 형식을 지원하는 경우의 client입니다. 정상 종료와 결과 형식도 확인합니다. 검토에서는 합성 응답을 주는 로컬 HTTP fixture로 요청과 실패 분기를 검사했으며 실제 모델의 정확성을 측정하지 않았습니다. JSON 형식 준수는 내용의 진실성이나 tool 권한을 증명하지 않습니다.
from pathlib import Path
import json
from urllib.request import Request, urlopen

# Existing private gateway and a scoped credential mounted as a file.
base_url = "https://inference.example.internal/v1"
credential = Path("/run/secrets/inference/token").read_text().strip()
payload = {
    "model": "approved-model-alias",
    "messages": [{"role": "user", "content": "Return the city Seoul and country Korea."}],
    "temperature": 0,
    "max_tokens": 128,
    "response_format": {
        "type": "json_schema",
        "json_schema": {
            "name": "location",
            "schema": {
                "type": "object",
                "properties": {"city": {"type": "string"}, "country": {"type": "string"}},
                "required": ["city", "country"],
                "additionalProperties": False,
            },
        },
    },
}
request = Request(
    base_url + "/chat/completions",
    data=json.dumps(payload).encode(),
    headers={"Content-Type": "application/json", "Authorization": "Bearer " + credential},
    method="POST",
)
with urlopen(request, timeout=30) as response:
    result = json.load(response)
choice = result["choices"][0]
if choice["finish_reason"] != "stop":
    raise RuntimeError("Generation did not complete normally")
location = json.loads(choice["message"]["content"])
if set(location) != {"city", "country"} or not all(isinstance(v, str) for v in location.values()):
    raise ValueError("Unexpected output shape")
print(location)
SGLang DSL의 function/system/user/assistant/gen API는 해당 릴리스에 남아 있습니다. 함수 선언만으로 추론이 일어나지는 않으며 준비된 RuntimeEndpoint/backend를 연결하고 run 결과를 읽어야 합니다. 설치 시 Torch·FlashInfer·장치 조건을 함께 확인하세요. 이번 검토에서는 GPU SDK 전체를 설치하거나 DSL을 모델에 연결하지 않았습니다.
Hugging Face TGI
공식 저장소는 유지보수 모드를 명시하며 최신 확인 릴리스는3.3.7(2025-12-19)입니다. 경미한 수정·문서·유지보수를 받고 새 추론 엔진으로 vLLM/SGLang 등을 안내합니다. 새 프로젝트의 일반적인 기본 추천에서 제외하고 기존 TGI 시스템은 모델·template·streaming·메트릭·SLO를 기준으로 전환을 검증하세요.
기존 모델에 --quantize=awq를 붙여 AWQ weights가 자동 생성되는 것은 아닙니다. 해당 quantization 형식으로 준비한 지원 모델이 필요합니다. 최신 태그 사용, gated 모델 token 미준비, 짧은 liveness 제한은 재현성과 시작 성공을 해칩니다.
Ollama
0.34.0에서 모델 pull과 serving은 별개입니다. postStart에서 sleep10 후 pull하는 방식은 server 준비를 보장하지 않습니다. 승인된 모델을 사전 준비하거나 health 확인·bounded retry·실패 처리가 있는 별도 준비 절차를 사용하고, model tag 변경 가능성과 저장소 권한을 기록합니다.
Ollama 로컬 API는 자체 사용자 인증이 없는 경로이므로 서비스 공개 전 gateway 인증·경로 제한이 필요합니다. Pod 내부 localhost만 바인딩된 server는 Service에서 접근할 수 없습니다. OLLAMA_HOST 변경은 listen 범위를 바꿀 뿐 인증을 추가하지 않습니다. 모델 관리 endpoint와 추론 endpoint의 허용 범위도 분리하세요.
Modelfile은 base model, system prompt와 generation 설정을 정의하며 모델을 학습시키거나 Kubernetes image를 빌드하는 Dockerfile이 아닙니다. CPU/GPU 지원은 모델 크기·장치·backend별로 검증하고 대규모 멀티테넌트 기능을 자동으로 가정하지 않습니다.
LiteLLM
Agentic AI 가이드의 검토한1.100.1 Router 설정을 사용합니다. provider gateway는 inference engine과 다른 계층입니다. model alias를 gpt-4-equivalent라고 이름 짓는다고 품질이 같아지는 것은 아닙니다. fallback은 허용된 provider와 데이터 전송 정책을 먼저 만족해야 합니다.
config 파일을 실제 proxy command에 연결하고 client credential·DB/Redis·callback 요구를 구성합니다. dummy key나 ClusterIP만으로 인증되지 않으며 drop_params=true는 일부 의미 있는 요청 조건을 제거할 수 있습니다. 요청·성공·실패·재시도·cache 비용을 구분해 기록하세요.
AWS Neuron과 Inferentia2
칩, NeuronCore와 host RAM/HBM을 구분해야 합니다. Inferentia2 칩 하나는 NeuronCore-v2 두 개와 HBM32GiB를 갖습니다.
| Instance | Chips | NeuronCores-v2 | Device HBM (GiB) | Host RAM (GiB) | vCPU |
|---|---|---|---|---|---|
| inf2.xlarge | 1 | 2 | 32 | 16 | 4 |
| inf2.8xlarge | 1 | 2 | 32 | 128 | 32 |
| inf2.24xlarge | 6 | 12 | 192 | 384 | 96 |
| inf2.48xlarge | 12 | 24 | 384 | 768 | 192 |
장치 할당과 plugin 경로
aws.amazon.com/neuron은 전체 장치, aws.amazon.com/neuroncore는 코어 단위입니다. inf2.xlarge에 neuron:2·CPU8·RAM24Gi를 요청했던 예제는 장치1개·vCPU4·RAM16Gi 노드에 배치되지 않습니다. NEURON_RT_VISIBLE_CORES는 runtime의 선택 범위이며 Kubernetes가 할당하지 않은 장치를 만들어주지 않습니다. NUM_CORES와 함께 설정할 때의 우선순위·논리 코어 정책도 릴리스별로 확인해야 합니다.
검토한 공식 Helm1.10.0은 device plugin 외에 scheduler·node problem detector 등 옵션을 포함합니다. 설치 전 렌더링으로 DaemonSet·hostPath·RBAC·복구 동작을 검토해야 합니다. 아래 명령은 로컬 출력만 생성합니다.
helm template neuron-audit oci://public.ecr.aws/neuron/neuron-helm-chart --version 1.10.0 --namespace kube-system --include-crds > neuron-rendered.yamlSDK2.32.0은 서로 다른 두 serving 경로를 설명합니다. Inf2/Trn1/Trn2용 NxD Inference plugin0.5.x + vLLM0.16과 Trn2/Trn3 전용 새 vLLM Neuron 베타0.24.0.1.1.0을 혼합하지 마세요. 상세 NxD 문서에 남은0.5.0/SDK2.29와 개요의0.5.3 차이도 있어, 선택한 plugin tag·DLC·의존성의 정확한 조합을 확인해야 합니다. 최신 베타를 Inf2에 그대로 설치하거나 오래된2.18 DLC에 pip install을 추가하는 것으로 검증을 대신하지 않습니다.
Neuron compilation은 지원 모델 구현, shape/batch/sequence bucket, TP, compiler/SDK·장치·cache artifact를 함께 다룹니다. 일반 Transformers 모델에 torch_neuronx.trace를 호출하고 사용하지 않는 tp_degree dict를 만드는 예제는 distributed causal-LM serving 구성이 아닙니다. compiler 출력 파일과 tokenizer 디렉터리도 구분하세요. 이번 검토에서는 compiler나 Neuron 인스턴스를 실행하지 않았습니다.
성능·비용 비교와 운영
출처 없는 A100 비교표와 고정40–70% 절감률은 제거했습니다. 동일 모델·revision·정밀도·입출력 token 분포·동시성·성공률·SLO·warm-up·가격 시점으로 직접 비교해야 합니다. 월100만 요청/일을30일로 계산하면3천만 요청이므로, 가상의 월48,000달러는1천 요청당1.60달러입니다. 예전 표의0.80달러는 산술적으로 맞지 않으며 이 예시는 현재 AWS 가격이 아닙니다.
엔진 변경은 실제 payload/template/streaming/usage와 실패 동작을 회귀 검사합니다. sharded model group과 독립 replica를 구분하고, StatefulSet의 순차 readiness가 서로 기다리는 worker를 막지 않는지도 확인합니다. StatefulSet 자체가 TP/PP·rendezvous·NCCL을 구성하지 않습니다.
스토리지는 모델 크기·재시작 횟수·동시 다운로드·권한·비용에 따라 local cache, EBS, EFS, FSx 등을 비교합니다. EFS가 항상 FSx보다 느리다거나 gp3의 과거 제한이 현재 한계라고 고정하지 않습니다. GPU/storage 예제를 참조하세요.
운영 전에는 인증·TLS·관리 endpoint 제한, probes·배치·할당량·단일 scaler owner, metrics 단위, model revision·cache 수명, rollout/rollback·중단 복구를 실제 환경에서 확인합니다.
검증 범위
공식 chart와 CRD, 실제 SDK/CLI source, 로컬 HTTP 요청/실패 fixture, Markdown과 이미지 검사를 수행했습니다. GPU·Neuron 모델 실행, 실제 throughput/비용 측정, cloud 배포나 데이터 다운로드는 하지 않았습니다. 스키마/차트 통과는 admission·권한·model compatibility·운영 가능성을 증명하지 않습니다.
참고 자료
- NIM 2.0 release notes
- NIM configuration
- NIM observability
- Dynamo 1.4.2
- AIBrix 0.7.0
- SGLang 0.5.19 structured output
- TGI maintenance notice
- Ollama 0.34.0
- GenAI-Perf 0.0.16
- Neuron SDK 2.32.0 inference paths
- Inf2 architecture
- Neuron Kubernetes components