Part 4: Katib — 하이퍼파라미터 튜닝과 AutoML
지원 버전: Katib 0.19.0, Kubeflow Community Distribution 26.03.1 마지막 업데이트: 2026년 9월 12일
실습 환경 준비
Katib 0.19.0 컨트롤러·DB manager·저장소, 필요한 Suggestion 이미지, Experiment를 생성할 네임스페이스 권한이 필요합니다. 전체 Kubeflow 설치의 Profile과 standalone 접근 모델은 구분하세요. GPU 용량은 선택 사항이며 Karpenter는 공급 방법 중 하나입니다.
Katib이란 무엇인가
Katib은 하이퍼파라미터 최적화(HPO)와 신경망 구조 탐색(NAS)을 지원합니다. Experiment가 목표·탐색 공간·알고리즘·Trial 템플릿을 정의하고, Suggestion과 알고리즘 서비스가 후보를 제안하며, Trial은 후보 하나의 실행을 관리합니다. 후보 선택이 과거 결과를 활용하는 방식은 알고리즘마다 다릅니다.
이들은 CRD로 정의된 커스텀 리소스 객체이며 실행마다 새 CRD를 설치하는 것은 아닙니다. Trial 컨트롤러는 설정된 Job 리소스를 만들고, 해당 Job 컨트롤러와 Kubernetes 스케줄러가 실제 Pod 생성·노드 배치를 담당합니다. 0.19.0 기본 trialResources에는 TrainJob.v1alpha1.trainer.kubeflow.org, Kubernetes Job과 레거시 학습 Job 종류가 포함됩니다. 실제 Trainer API, runtime, 권한, 성공·실패 조건과 collector 대상 Pod/컨테이너를 맞춰야 하며 자동 호환을 가정해서는 안 됩니다.
kubectl get experiments.kubeflow.org와 kubectl get trials.kubeflow.org로 상태를 볼 수 있습니다. 같은 이름의 KFP Experiment API와는 다른 리소스입니다.
탐색 알고리즘
알고리즘 이름은 설치된 KatibConfig와 Suggestion 이미지에 맞아야 합니다. 0.19.0의 기본 설정에는 다음 항목이 포함됩니다.
| 이름 | 전략과 조건 |
|---|---|
random | 지정된 탐색 공간·분포의 샘플링. 모든 파라미터가 반드시 균등 분포인 것은 아님 |
grid | 유한한 조합 탐색. 목표 도달·실패·Trial 제한으로 전체를 실행하지 못할 수 있음 |
bayesianoptimization, tpe, multivariate-tpe | 관측값으로 후보를 고르는 서로 다른 모델 기반 전략. 적은 Trial로 최적화된다는 보장은 없음 |
hyperband | 여러 자원 예산과 successive halving을 이용한 탐색. 학습 코드의 예산 파라미터와 호환 필요 |
cmaes, sobol | 각각 공분산 적응 진화 전략과 저불일치 샘플링. 동일한 알고리즘이 아님 |
pbt | population-based training. checkpoint 공유 등 별도 요구사항이 있으며 CMA-ES와 다름 |
enas, darts | 구조 탐색용 알고리즘; 일반 HPO와 템플릿·의존성이 다름 |
PBT 가이드는 RWX 볼륨과 resumePolicy: FromVolume을 요구합니다. 단순히 알고리즘 이름만 바꿔 모든 학습 코드를 재사용할 수 있는 것은 아닙니다.
Experiment 스펙의 구조
| 필드 | 의미 |
|---|---|
objective | 메트릭 이름, maximize/minimize, 선택적 목표값 |
parameters | double/int/discrete/categorical과 허용 범위·목록·분포 |
algorithm | 실제 설치된 Suggestion 알고리즘과 설정 |
trialTemplate | trialParameters 치환과 Job 스펙, primary container/Pod 선택, 성공·실패 조건 |
parallelTrialCount | 동시 처리 Trial 수. Pod·GPU·EC2 수와 동일하지 않음 |
maxTrialCount | 완료 Trial 수에 따른 종료 기준. 성공한 학습 수나 고정된 평생 비용 상한이 아님 |
maxFailedTrialCount | 실패와 메트릭 미확보 Trial을 포함한 실패 종료 기준 |
metricsCollectorSpec / earlyStopping | 메트릭 보고 방식과 별도 조기 종료 설정 |
목표 달성, 최대 완료 수, Suggestion 소진으로 성공 종료할 수 있고 실패 제한이나 Suggestion 오류로 실패할 수 있습니다. 상태 판정의 완료 수에는 성공·실패·강제 종료·조기 종료·메트릭 미확보가 포함됩니다. 재시작 정책이나 스펙 변경도 수명에 영향을 주므로 maxTrialCount를 불변의 전체 생성 상한이나 비용 한도로 해석하지 마세요.
Succeeded는 제어 루프의 종료 상태이며 모델 품질을 인증하지 않습니다. status.currentOptimalTrial은 수집된 관측값 중 현재 최적 결과이고, 메트릭을 얻지 못했다면 쓸 수 있는 최적 모델이 없을 수도 있습니다.
조기 종료와 0.19.0의 medianstop 구현
조기 종료는 진행 중인 Trial을 평가해 중단할 수 있습니다. 공식 가이드는 StdOut/File collector와 타임스탬프가 있는 로그를 요구합니다. 다른 collector나 임의의 학습 루프에도 그대로 적용된다고 가정하지 마세요. 기본 설정은 min_trials_required=3, start_step=4입니다.
이 버전은 설명과 구현을 구분해야 합니다. 공식 문서는 완료 Trial의 running average에 대한 중앙값 규칙을 설명합니다. 그러나 v0.19.0의 get_median_value는 성공 Trial별 처음 start_step개 관측값의 평균을 저장한 뒤, 저장된 평균값들의 산술평균을 반환합니다. 로컬에서 수정하지 않은 함수를 실행했을 때 [1, 2, 100]은 중앙값 2가 아니라 약 34.333의 임계값을 만들었습니다. 알고리즘 이름만으로 통계적 중앙값 계산을 보장하면 안 됩니다.
Hyperband의 예산 배분과 이 조기 종료 서비스는 별도 설정·실행 경로입니다. 중단이 유망한 후보를 제거할 가능성과 메트릭 형식·주기·예산 파라미터의 영향을 검증하세요.
Experiment의 전체 실행 흐름
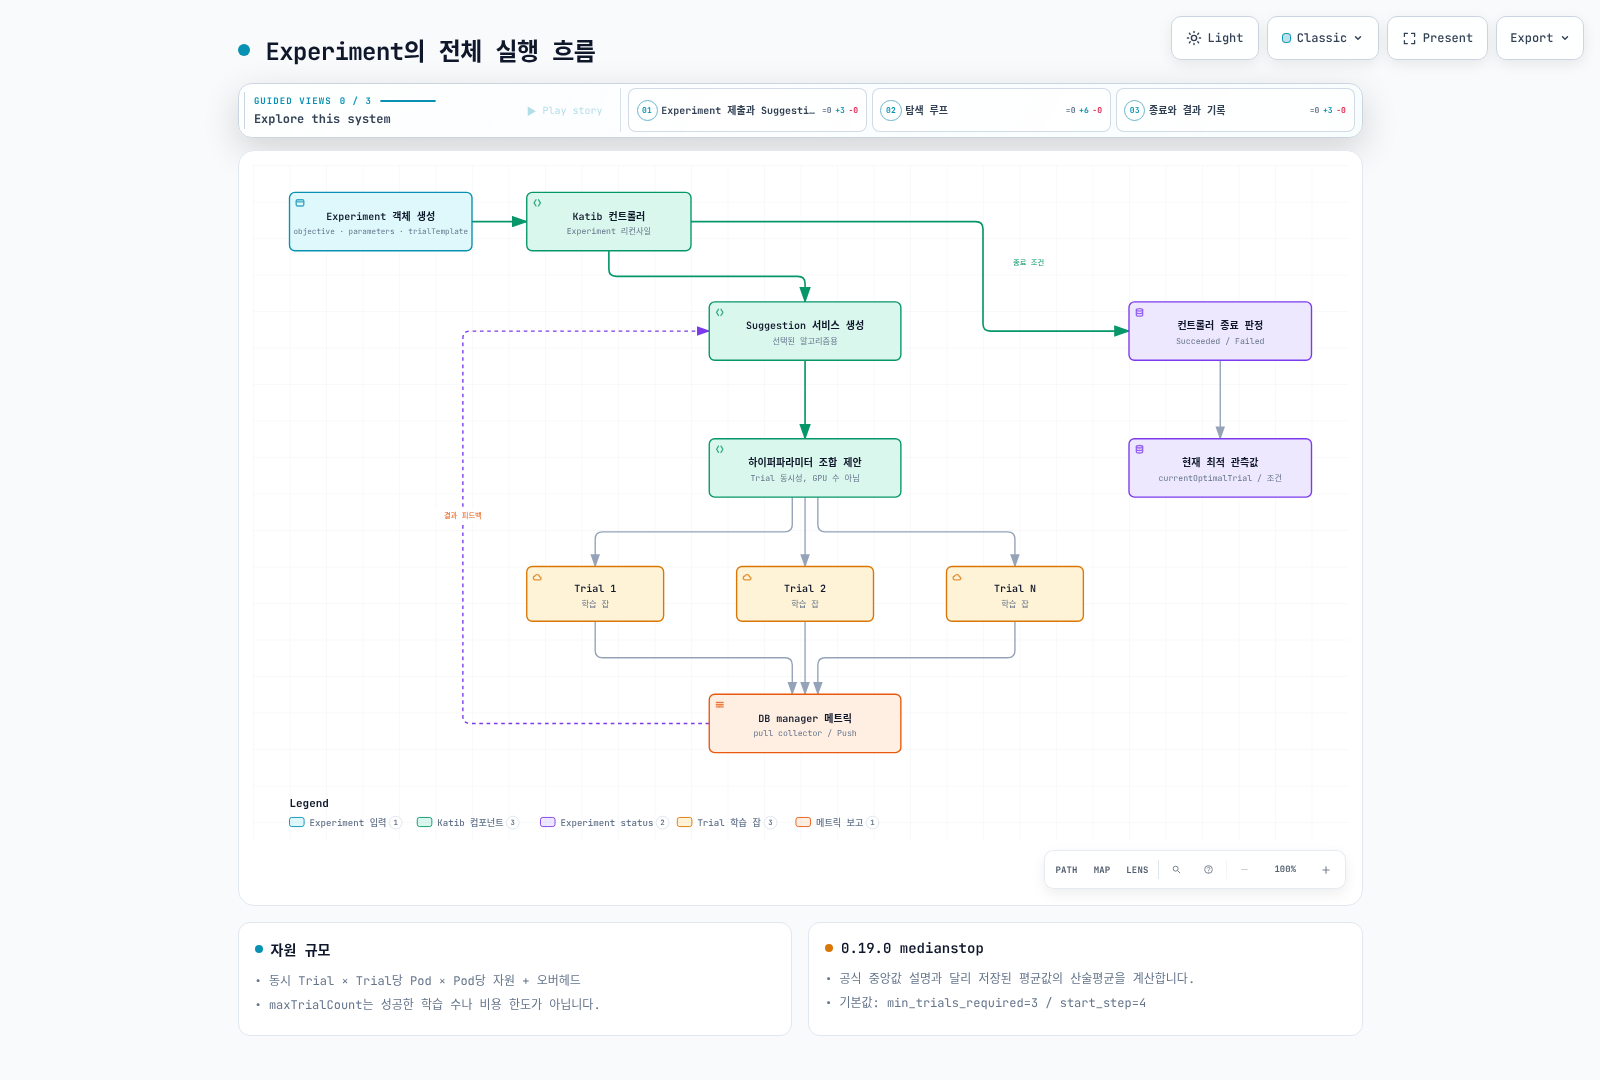
Experiment 컨트롤러는 Suggestion 리소스를 통해 후보를 요청하고 Trial 객체를 만듭니다. Trial 컨트롤러와 학습 Job 컨트롤러가 실행을 진행하며 메트릭이 DB manager로 보고됩니다. 알고리즘은 지원하는 방식으로 결과를 활용합니다. 성공·실패 조건과 실제 하위 Job의 잔존 여부를 함께 확인해야 하며, 최적 하이퍼파라미터가 곧 배포 가능한 모델 아티팩트인 것은 아닙니다.
메트릭 수집
| 방식 | 설정과 조건 |
|---|---|
StdOut | 기본 pull 방식. 지정된 primary container의 로그 형식에서 메트릭 추출 |
File | TEXT 또는 줄별 JSON 파일, 경로·필터 설정 필요 |
TensorFlowEvent | 이벤트 파일 디렉터리에서 수집. 호환되는 TensorBoard writer도 가능 |
Custom | 사용자가 collector 컨테이너와 동작을 구현. 임의 HTTP scrape는 기본 내장 방식이 아님 |
Push | 학습 코드가 SDK report_metrics()로 DB manager에 전송. collector 사이드카가 항상 필요한 것은 아님 |
Pull collector 주입에는 네임스페이스의 katib.kubeflow.org/metrics-collector-injection: enabled, 동작하는 webhook과 적절한 대상 Pod/컨테이너 선택이 필요합니다. 분산 학습은 어느 rank가 메트릭을 보고하는지 정해야 합니다. 메트릭 이름, 숫자 형식, 타임스탬프, 네트워크·정책을 검증하세요. 학습 Job 성공만으로 메트릭 확보가 보장되지는 않습니다.
EKS에서의 용량과 비용
수요는 대략 동시 Trial 수 × Trial당 Pod 수 × Pod당 자원에 collector·Suggestion·DB 등의 오버헤드를 더한 값입니다. 예를 들어 Trial당 2 Pod가 각각 GPU 4개를 요청하면 parallelTrialCount 8은 최대 64 GPU 수요이며 8 GPU가 아닙니다.
Pending이면 Pod 이벤트와 스케줄링 조건, quota, NodePool/EC2 용량, 드라이버·부팅 상태를 확인하세요. Karpenter가 항상 용량을 공급하거나 높은 동시성이 반드시 전체 실행을 단축한다고 가정할 수 없습니다. 조기 종료로 Pod 자원이 풀려도 노드가 남아 있으면 EC2 비용은 계속 발생할 수 있습니다.
총 Trial 기준, 동시성, Trial 내부 재시도·분산 크기, 종료 시간과 데이터 보존을 함께 설정하세요. 작은 CPU 예제로 메트릭 수집·종료를 확인한 뒤 GPU 규모를 늘리는 편이 원인 분리에 유리합니다.
검증과 근거
v0.19.0 설정·컨트롤러·API·collector 경로와 medianstop 소스를 검토했습니다. 수정하지 않은 medianstop 함수를 로컬에서 사전 입력한 성공 이력으로 실행하고 네트워크 호출을 차단했습니다. Experiment나 GPU를 실제 실행한 결과는 아닙니다.
다음 단계
Part 5: Trainer에서 분산 학습 API와 런타임을 살펴봅니다.
퀴즈
이 장에서 배운 내용을 확인하려면 주제 퀴즈를 풀어보세요.