Flagger Progressive Delivery
검토 기준: Flagger/Chart 1.45.0, Loadtester 0.39.0, Flux 2.9.5(릴리스 노트 검토 후 패치 2.9.6로 갱신, 예제 재실행 안 함), Podinfo 6.15.0 마지막 업데이트: 2026년 10월 12일
Flagger는 Canary CRD로 기존 Kubernetes workload의 점진적 배포를 관리합니다. 트래픽과 버전을 제어하지만 데이터베이스 변경이나 외부 부작용을 되돌리는 트랜잭션 관리자는 아닙니다. 아래는 실습 예제이며 실제 네트워크·계측·권한·SLO에 맞게 준비해야 합니다.
코드에는 전체 manifest와 spec/Helm values 조각이 섞여 있습니다. 설명에 맞춰 원본에 병합하고, 같은 이름의 전략 예제는 대안으로 사용합니다. 모든 블록을 순서대로 적용하는 절차가 아닙니다.
목차
- 개요 및 학습 목표
- Flagger 아키텍처
- EKS 설치 및 구성
- Canary 배포 전략
- Blue-Green 배포 전략
- A/B Testing 전략
- Custom Metrics 및 Webhook
- GitOps 통합 (Flux + Flagger)
- Observability 및 알림
- 프로덕션 모범 사례
개요 및 학습 목표
Kubernetes Deployment의 RollingUpdate도 Pod를 점진적으로 교체합니다. Flagger는 별도 버전의 트래픽을 제어하고 지표/테스트로 승격을 판단합니다. 이 장에서는 리소스 소유권, 세 가지 전략, 지표와 게이트, GitOps 연동 및 관측 방법을 학습합니다.
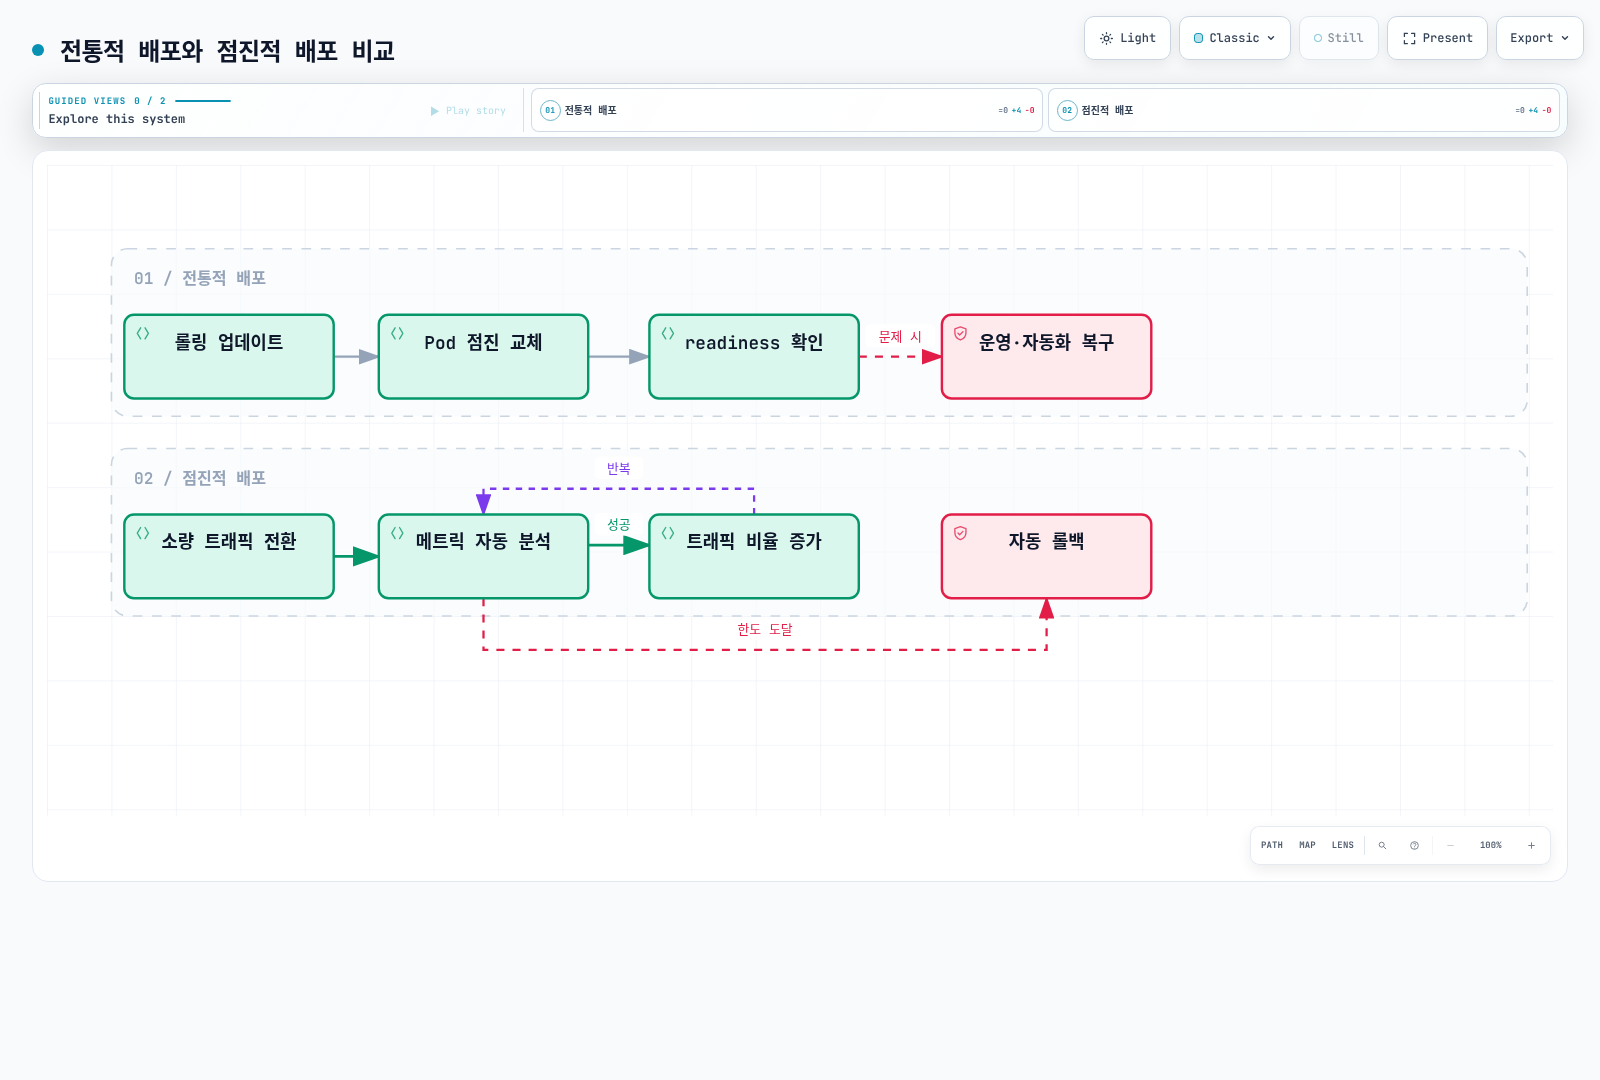
| 전략 | 제어 방식 | 운영 시 확인 |
|---|---|---|
| Canary | 단계별 가중치 증가 | 추가 replica, 최소 트래픽, 실패 조건 |
| Blue-Green | 별도 버전 검증 후 전환 | 두 workload와 rollout surge 용량, DB 호환성 |
| A/B | 지원되는 헤더/쿠키 조건 | cohort 할당, 통계 검증, 별도 인증 |
Blue-Green이 정확히 두 배의 리소스나 즉시 무중단 rollback을 보장하지는 않습니다. Flagger는 primary를 새 버전으로 갱신하며, 완료 후 이전 버전 전체를 별도 standby로 유지하지 않습니다.
Flagger와 Argo Rollouts
| 항목 | Flagger | Argo Rollouts |
|---|---|---|
| 리소스 | Canary가 기존 Deployment 등 참조 | Rollout CRD; Deployment workloadRef도 지원 |
| GitOps | Flux 및 다른 GitOps 도구와 연동 | Argo CD 및 다른 GitOps 도구와 연동 |
| 분석 | MetricTemplate, 임계값, Webhook | AnalysisTemplate/AnalysisRun, Web/Job 등 |
| 프로젝트 | CNCF Graduated Flux의 구성 요소 | CNCF Graduated Argo의 구성 요소 |
생태계 연동은 배타적인 종속성이 아닙니다. 같은 workload를 두 점진적 배포 controller가 동시에 제어하도록 구성하지 않습니다.
Flagger 아키텍처
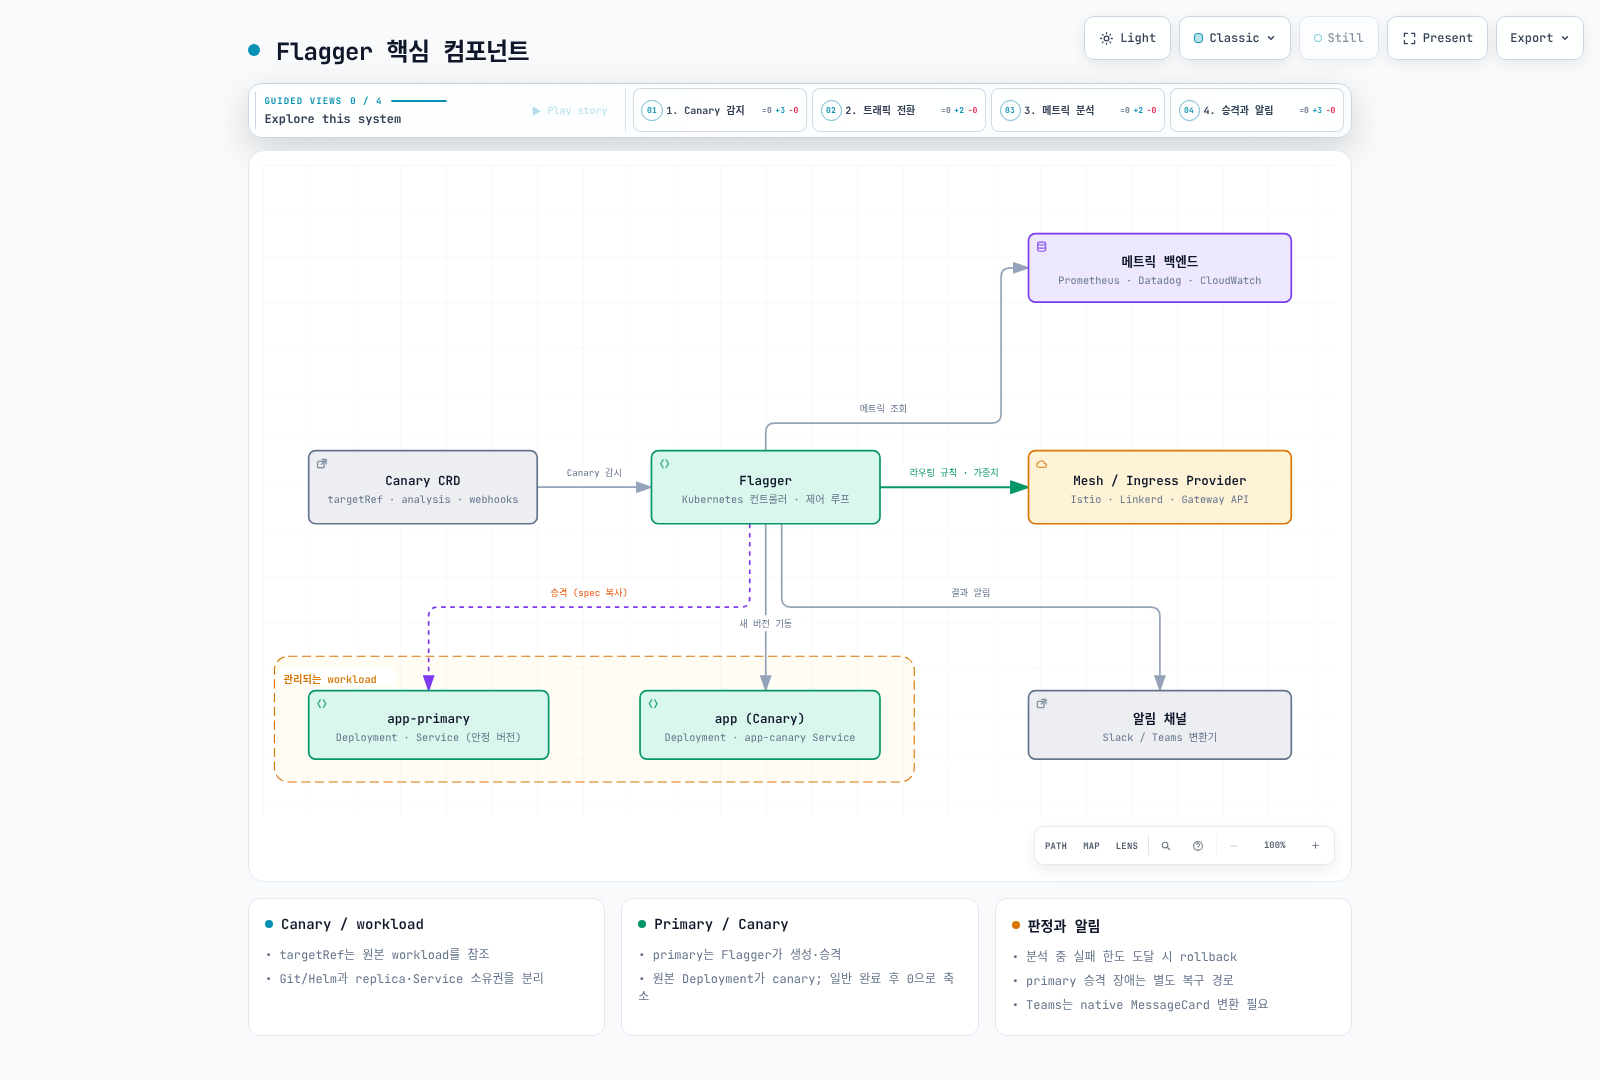
Deployment 예제에서 podinfo는 원래 리소스이자 canary workload입니다. 새 안정 workload는 podinfo-primary입니다. podinfo-canary는 Service 이름이며 추가 Deployment나 CloneSet이 아닙니다.
| 리소스 | 관리/용도 |
|---|---|
| podinfo Deployment | Git/Helm의 Pod template, Flagger의 canary 조정 |
| podinfo-primary Deployment | Flagger가 생성·승격하는 안정 workload |
| podinfo / podinfo-primary / podinfo-canary Services | Flagger가 관리하는 진입점/대상 |
| Primary autoscaler | autoscalerRef 사용 시 대응 autoscaler 구성 |
| VirtualService/DestinationRule/HTTPRoute 등 | 선택한 provider의 라우팅 |
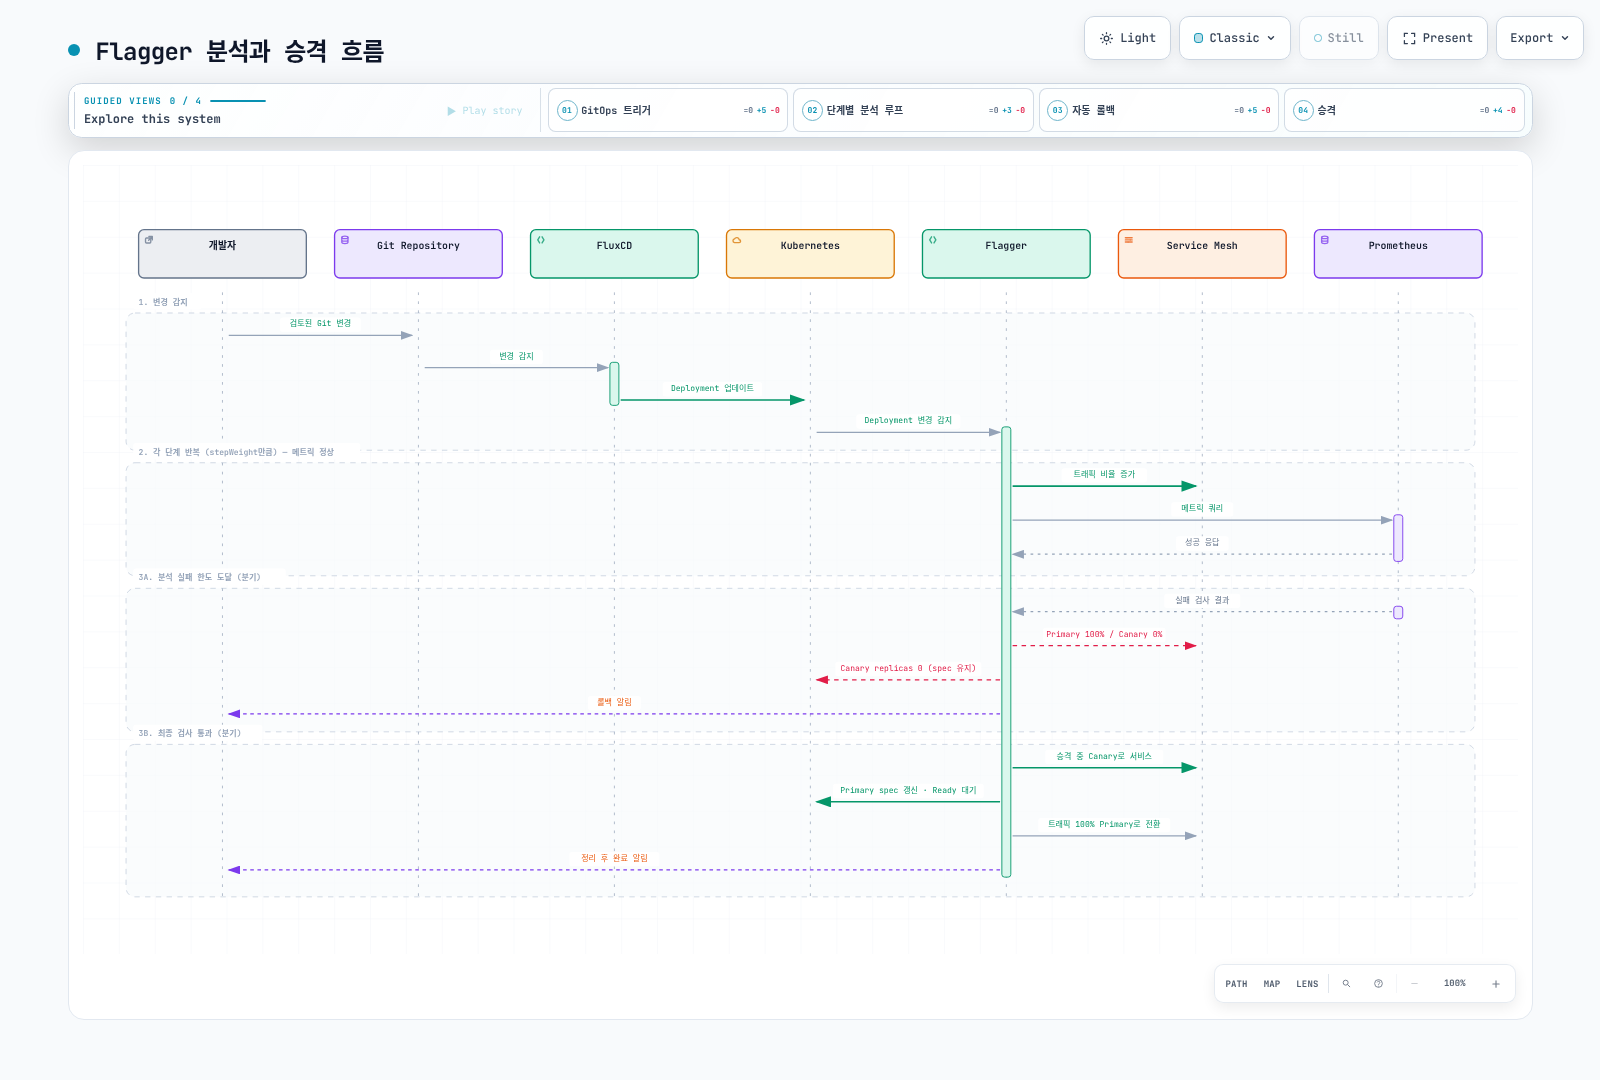
초기 primary를 준비한 뒤 Pod template 또는 추적하는 ConfigMap/Secret 변경을 감지하면 canary를 준비합니다. pre-rollout 검사, 분석과 라우팅을 거쳐 승격할 때는 준비된 canary로 트래픽을 보내면서 primary를 새 spec으로 갱신합니다. primary readiness를 확인한 후 트래픽을 되돌리고 canary를 축소합니다.
분석 중 실패는 정상 primary로 복귀합니다. primary 갱신 중 장애는 다릅니다. 1.45.0은 Promoting/Finalising 중 primary가 비정상이면 건강한 canary로 트래픽을 유지/되돌리고 실패를 보고할 수 있습니다. Failed 표시만 보고 이전 primary가 서비스 중이라고 가정하지 않습니다.
Provider와 수명주기
| Provider | 선택 시 확인 |
|---|---|
| Istio | VirtualService/DestinationRule, sidecar HTTP 지표 |
| gatewayapi:v1 | Gateway 구현의 HTTPRoute 기능과 MetricTemplate |
| Linkerd/Contour/Gloo/Traefik/Kuma 등 | 설치 버전의 기능·메트릭 계약 |
| kubernetes | Service 전환 Blue-Green; L7 가중치/A/B와 구분 |
| App Mesh / ingress-nginx / OSM | 아래 legacy 수명주기 제한 |
AWS App Mesh 지원은 2026-09-30 종료됐으며, AWS는 그 이후 콘솔과 리소스에 접근할 수 없다고 안내합니다. community ingress-nginx는 2026년 3월 종료되었고 OSM 저장소는 archived 상태입니다.
adapter 존재를 신규 운영 플랫폼의 유지보수 보장으로 해석하지 않습니다. A/B, mirroring, session affinity는 provider/구현별 지원을 확인합니다.
EKS 설치 및 구성
기본 실습은 지원 중인 EKS/Kubernetes, 설치된 Istio sidecar 환경, 해당 지표를 수집하는 Prometheus가 필요합니다. URL은 실제 Prometheus Service로 바꿉니다. Flagger가 Istio나 계측을 자동 설치하지 않습니다. chart에 포함된 Prometheus 기본 이미지는 오래된 2.41.0이므로 사용하지 않습니다.
하나의 release/관리 방식만 선택합니다. 다른 namespace에 동일 Flagger를 두 번 설치하면 같은 Canary를 제어할 수 있습니다. 예제는 controller용 flagger-system, workload용 flagger-demo입니다. 주입 레이블은 실제 Istio revision에 맞게 조정합니다.
apiVersion: v1
kind: Namespace
metadata:
  name: flagger-system
  labels:
    istio-injection: enabled
---
apiVersion: v1
kind: Namespace
metadata:
  name: flagger-demo
  labels:
    istio-injection: enabled
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: flagger-loadtester
  namespace: flagger-system
automountServiceAccountToken: false
Flagger Helm 설치
fullnameOverride: flagger
meshProvider: istio
namespace: flagger-demo
noCrossNamespaceRefs: true
metricsServer: http://prometheus.monitoring.svc.cluster.local:9090
prometheus:
  install: false
leaderElection:
  enabled: true
  replicaCount: 2
resources:
  requests:
    cpu: 100m
    memory: 128Mi
  limits:
    cpu: '1'
    memory: 512Mi
podDisruptionBudget:
  enabled: true
minAvailable: 1helm repo add flagger https://flagger.app
helm repo update flagger
helm upgrade --install flagger flagger/flagger --version 1.45.0 \
--namespace flagger-system -f flagger-values.yaml --wait --timeout 5mnamespace 값은 감시 범위이며 chart의 ClusterRole을 namespace RBAC로 바꾸지 않습니다. 멀티 테넌트 권한은 별도로 제한합니다. leaderElection.replicaCount는 실제 chart 설정입니다. Helm 최초 설치와 달리 일반 upgrade는 crds/를 갱신하지 않으므로 검토한 버전의 CRD를 별도 적용하거나 Flux CRD 정책을 사용합니다.
kubectl apply --server-side -f https://raw.githubusercontent.com/fluxcd/flagger/v1.45.0/artifacts/flagger/crd.yamlLoadtester와 접근 범위
fullnameOverride: flagger-loadtester
replicaCount: 1
service:
  type: ClusterIP
  port: 80
serviceAccountName: flagger-loadtester
rbac:
  create: false
cmd:
  timeout: 2m
  namespaceRegexp: ^flagger-demo$
resources:
  requests:
    cpu: 100m
    memory: 64Mi
  limits:
    cpu: 500m
    memory: 256Mi
securityContext:
  enabled: true
  context:
    allowPrivilegeEscalation: false
    capabilities:
      drop:
      - ALL
    readOnlyRootFilesystem: true
    runAsUser: 100
    runAsGroup: 101
volumes:
- name: tmp
  emptyDir: {}
volumeMounts:
- name: tmp
mountPath: /tmphelm upgrade --install flagger-loadtester flagger/loadtester --version 0.39.0 \
--namespace flagger-system -f loadtester-values.yaml --wait --timeout 5mLoadtester는 HTTP 요청의 명령을 실행합니다. namespaceRegexp는 body 문자열 필터이며 호출자 인증이 아닙니다. 인터넷에 노출하지 않고 controller Pod만 접근하도록 CNI NetworkPolicy를 적용합니다. 운영자 exec/port-forward는 RBAC로 통제합니다. 메모리 gate 실습은 replicas 1을 사용합니다.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: flagger-loadtester-ingress
  namespace: flagger-system
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/name: loadtester
  policyTypes:
  - Ingress
  ingress:
  - from:
    - namespaceSelector:
        matchLabels:
          kubernetes.io/metadata.name: flagger-system
      podSelector:
        matchLabels:
          app.kubernetes.io/name: flagger
    ports:
    - protocol: TCP
      port: 8080
Istio mTLS와 scrape 경로도 허용되어야 합니다. API 작업을 하지 않는 이 loadtester는 ServiceAccount token 자동 마운트를 끕니다. Helm/kubectl 테스트를 추가하면 필요한 권한과 쓰기 경로를 별도로 준비합니다.
Gateway API 대안
Istio GatewayClass와 호환되는 Gateway API CRD가 이미 있다는 전제입니다. 오래된 CRD bundle을 덮어씌우지 않습니다. 다른 Gateway 구현은 그에 맞는 계측/query가 필요합니다. 생성 Service/LB 노출·DNS·TLS를 실제 환경에 맞춥니다.
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: podinfo-gateway
  namespace: flagger-demo
spec:
  gatewayClassName: istio
  listeners:
  - name: http
    protocol: HTTP
    port: 80
    allowedRoutes:
      namespaces:
        from: Same
provider는 gatewayapi:v1이며 선택은 Canary service.gatewayRefs에 둡니다. gatewayApi.gateway라는 Helm 값이 아닙니다. 뒤의 MetricTemplate 세 개를 먼저 준비하고 다음 Canary를 Istio 방식의 대안으로 사용합니다.
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: gatewayapi:v1
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    hosts:
    - app.example.com
    gatewayRefs:
    - name: podinfo-gateway
      namespace: flagger-demo
      sectionName: http
  analysis:
    interval: 1m
    threshold: 5
    maxWeight: 50
    stepWeight: 10
    metrics:
    - name: error-rate
      templateRef:
        name: istio-error-rate
      thresholdRange:
        min: 0
        max: 1
      interval: 1m
    - name: latency-p99-ms
      templateRef:
        name: istio-latency-ms
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    - name: request-count
      templateRef:
        name: istio-request-count
      thresholdRange:
        min: 100
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/helm upgrade --install flagger flagger/flagger --version 1.45.0 \
--namespace flagger-system -f flagger-values.yaml --set meshProvider=gatewayapi:v1Canary 배포 전략
기본 Istio 예제의 workload와 HPA입니다. Metrics Server가 필요합니다. Deployment replicas는 Git에서 고정하지 않고 HPA/Flagger에 맡깁니다. 경쟁하는 일반 Service도 만들지 않습니다. 이 manifest 방식과 뒤의 HelmRelease 방식 중 하나를 선택합니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  selector:
    matchLabels:
      app: podinfo
  template:
    metadata:
      labels:
        app: podinfo
    spec:
      containers:
      - name: podinfo
        image: ghcr.io/stefanprodan/podinfo:6.15.0
        ports:
        - name: http
          containerPort: 9898
        readinessProbe:
          httpGet:
            path: /readyz
            port: http
        livenessProbe:
          httpGet:
            path: /healthz
            port: http
        resources:
          requests:
            cpu: 100m
            memory: 64Mi
          limits:
            cpu: 500m
            memory: 256Mi
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  minReplicas: 2
  maxReplicas: 4
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80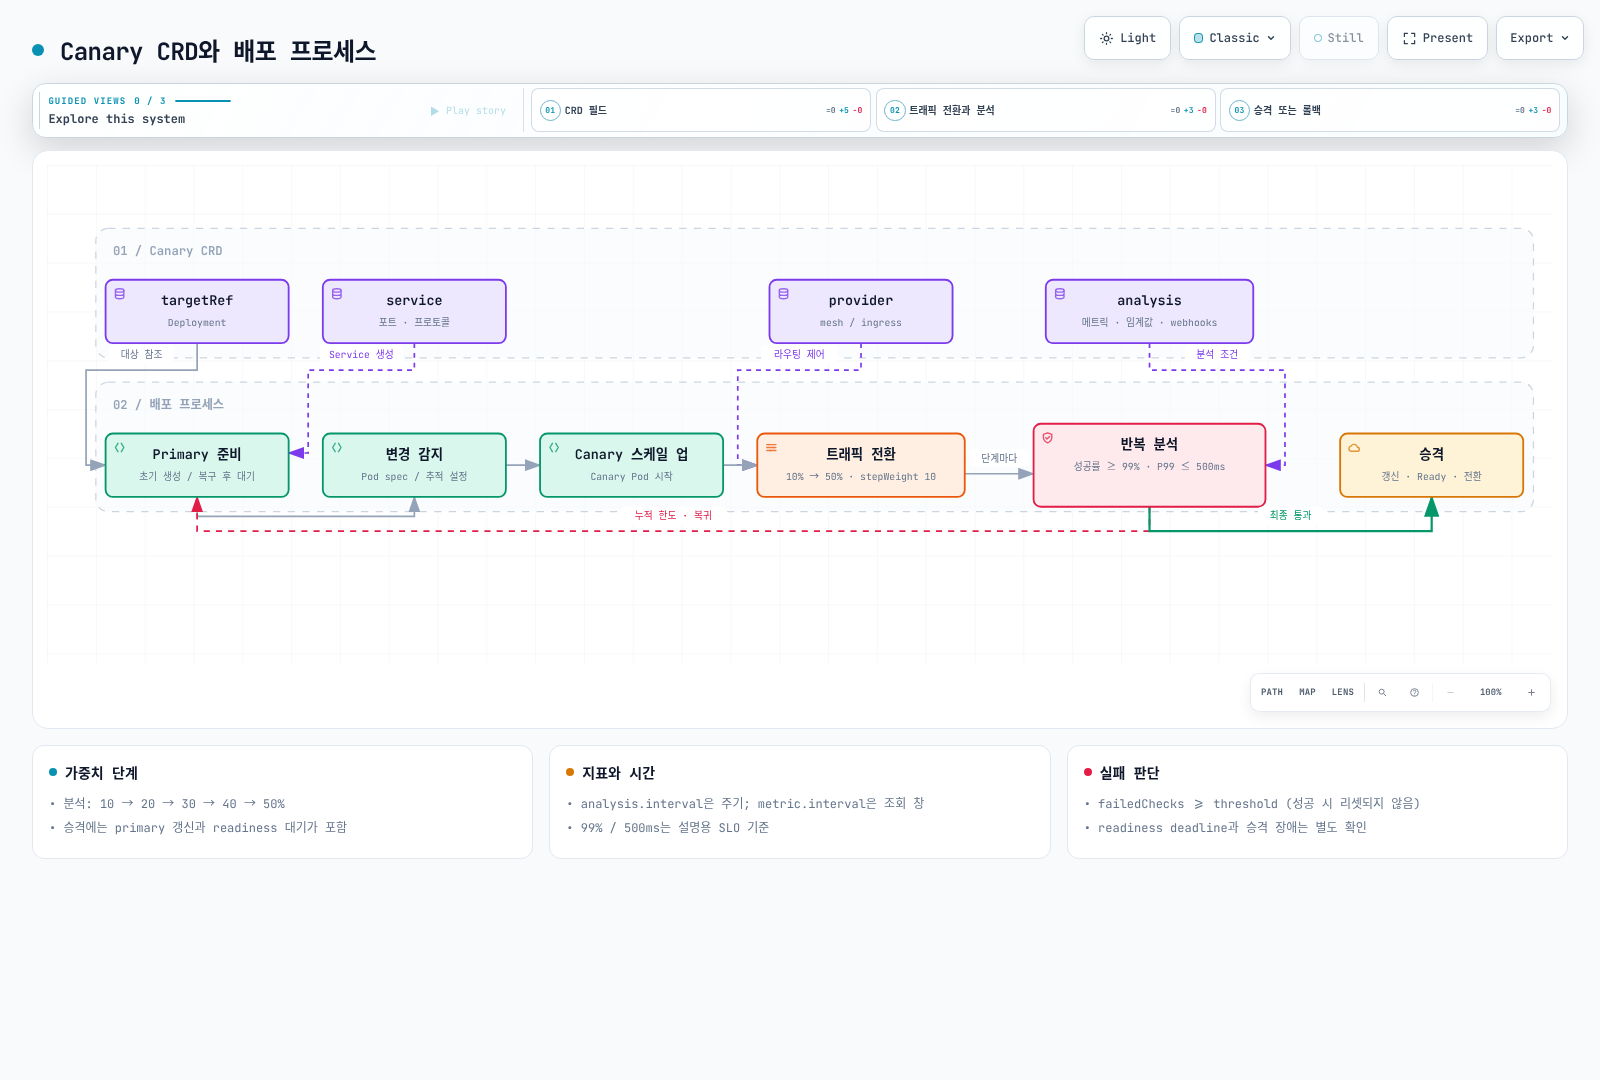
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: istio
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    portName: http
    gateways:
    - mesh
    hosts:
    - podinfo
    trafficPolicy:
      tls:
        mode: ISTIO_MUTUAL
  analysis:
    interval: 1m
    threshold: 5
    maxWeight: 50
    stepWeight: 10
    metrics:
    - name: request-success-rate
      thresholdRange:
        min: 99
        max: 100
      interval: 1m
    - name: request-duration
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
        cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/
iterations가 있으면 Blue-Green(또는 match가 있으면 A/B)이 선택되므로 가중치 Canary에 섞지 않습니다. stepWeight 10, maxWeight 50은 10→20→30→40→50% 분석 후 승격하는 예입니다. 총 시간은 readiness, 검사 지연, 실패·승인 대기와 primary rollout에 따라 달라집니다.
analysis.interval은 분석 주기, metric의 interval은 query의 조회/집계 창입니다. threshold 5는 한 revision 분석 중 누적 실패 검사 수에 적용되며 성공 때마다 초기화되는 연속 실패 수가 아닙니다. 5에 도달하면 후속 조정에서 rollback합니다. pre-rollout 및 rollout/metric 실패가 이 경로에 포함됩니다. progressDeadlineSeconds는 workload 진전/readiness 제한이며 전체 배포 시간의 두 배로 정하는 공식이 아닙니다.
비선형 가중치는 아래처럼 stepWeights를 쓰고 기존 stepWeight/maxWeight를 제거합니다. 연결 유지와 라우터 반영 지연 때문에 설정값이 모든 순간의 정확한 요청 비율을 보장하지는 않습니다.
spec:
  analysis:
    stepWeights:
    - 1
    - 2
    - 5
    - 10
    - 25
- 50kubectl get canary podinfo -n flagger-demo --watch
kubectl describe canary podinfo -n flagger-demo
kubectl logs -n flagger-system -l app.kubernetes.io/name=flagger -c flagger --prefix --tail=100첫 stable 초기화가 완료된 뒤 Git에서 검토된 image/tag/digest 또는 Pod template 변경을 적용해야 새 분석이 시작됩니다. 같은 tag의 원격 내용 교체가 Git 변경을 대신하지는 않습니다. 생성된 primary·Service·routing 리소스는 직접 편집하지 않습니다.
Blue-Green 배포 전략
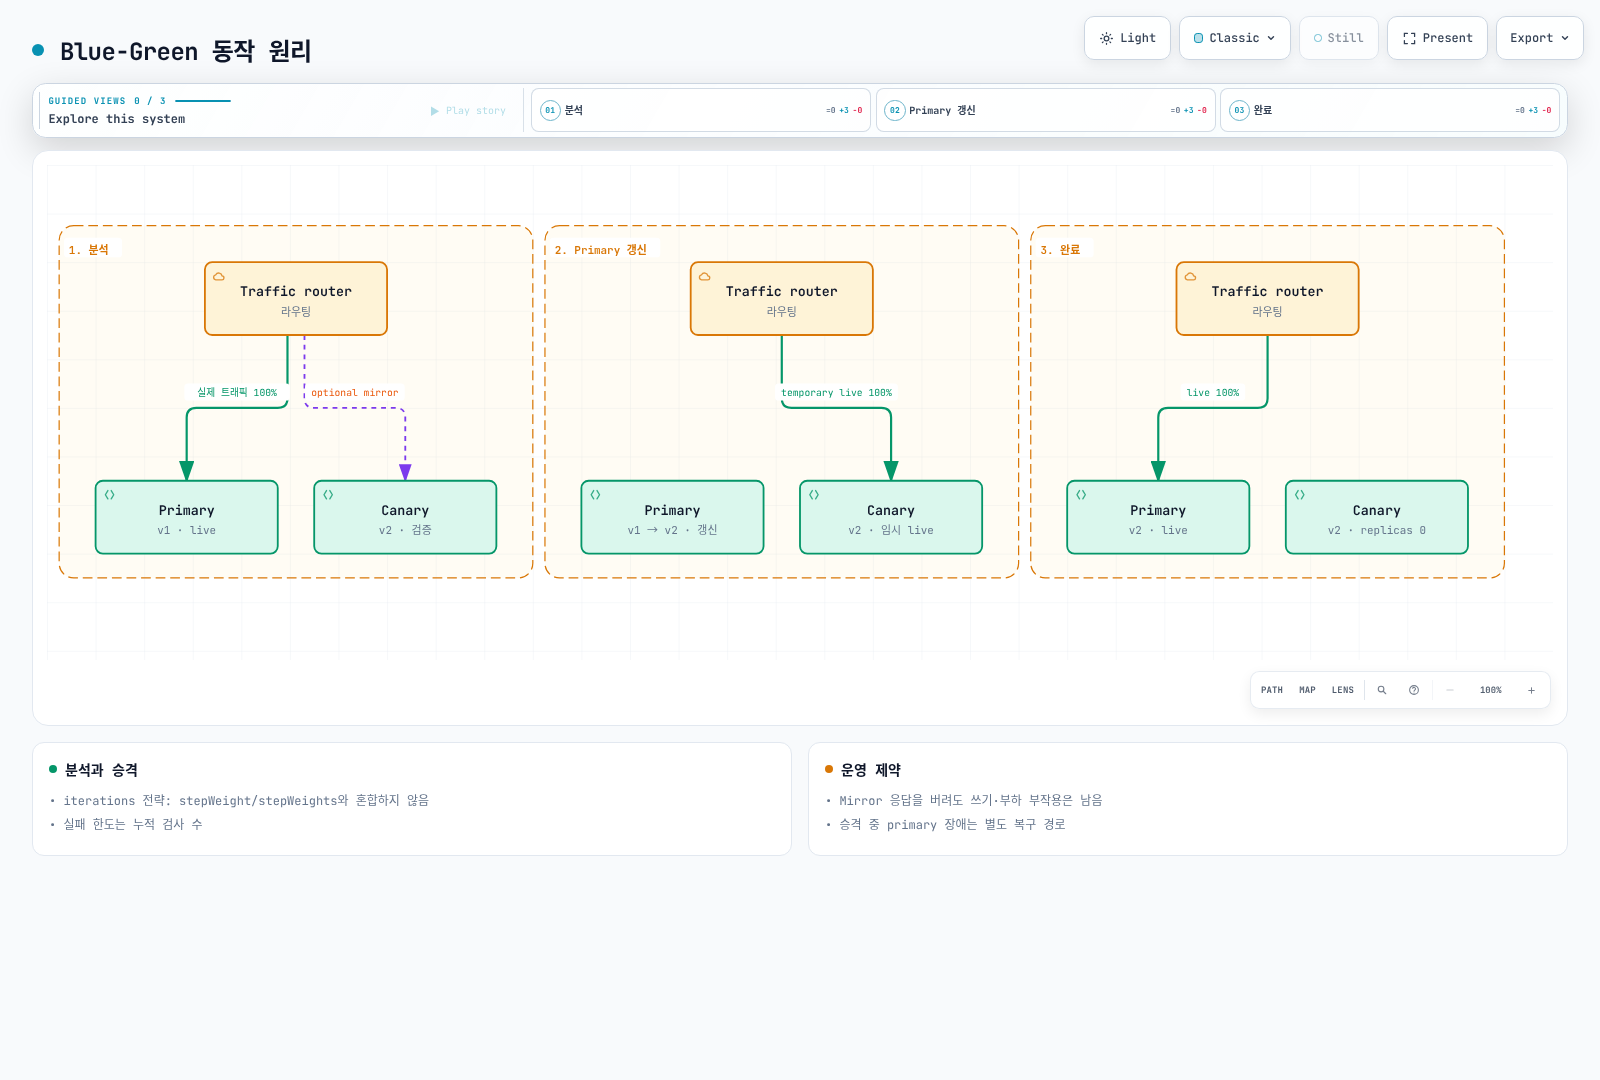
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: istio
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    portName: http
    gateways:
    - mesh
    hosts:
    - podinfo
    trafficPolicy:
      tls:
        mode: ISTIO_MUTUAL
  analysis:
    interval: 1m
    threshold: 5
    metrics:
    - name: request-success-rate
      thresholdRange:
        min: 99
        max: 100
      interval: 1m
    - name: request-duration
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
        cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/
    iterations: 10
이 예제는 synthetic traffic으로 검사하며 분석 중 live traffic은 primary에 둡니다. 통과 후 canary로 전환하여 primary를 갱신하고, primary가 준비되면 되돌립니다. 실패 한도는 Canary와 같으며 한 번의 실패가 항상 즉시 rollback이라는 뜻은 아닙니다. 대기 중인 이전 버전 전체를 유지하는 별도 blue/green 환경과 혼동하지 않습니다.
선택적 Traffic Mirroring
spec:
  analysis:
    mirror: true
    mirrorWeight: 10
지원 provider에서 mirror는 Canary 사전 단계 또는 Blue-Green에 사용할 수 있습니다. Gateway API는 구현의 RequestMirror 지원을 확인합니다. 응답을 버려도 DB 쓰기, 결제, 메시지 발송과 부하는 발생할 수 있으므로 검증된 read-only 요청이나 격리된 환경에 제한합니다. Mirror는 DB 복제나 rollback 수단이 아닙니다.
A/B Testing 전략
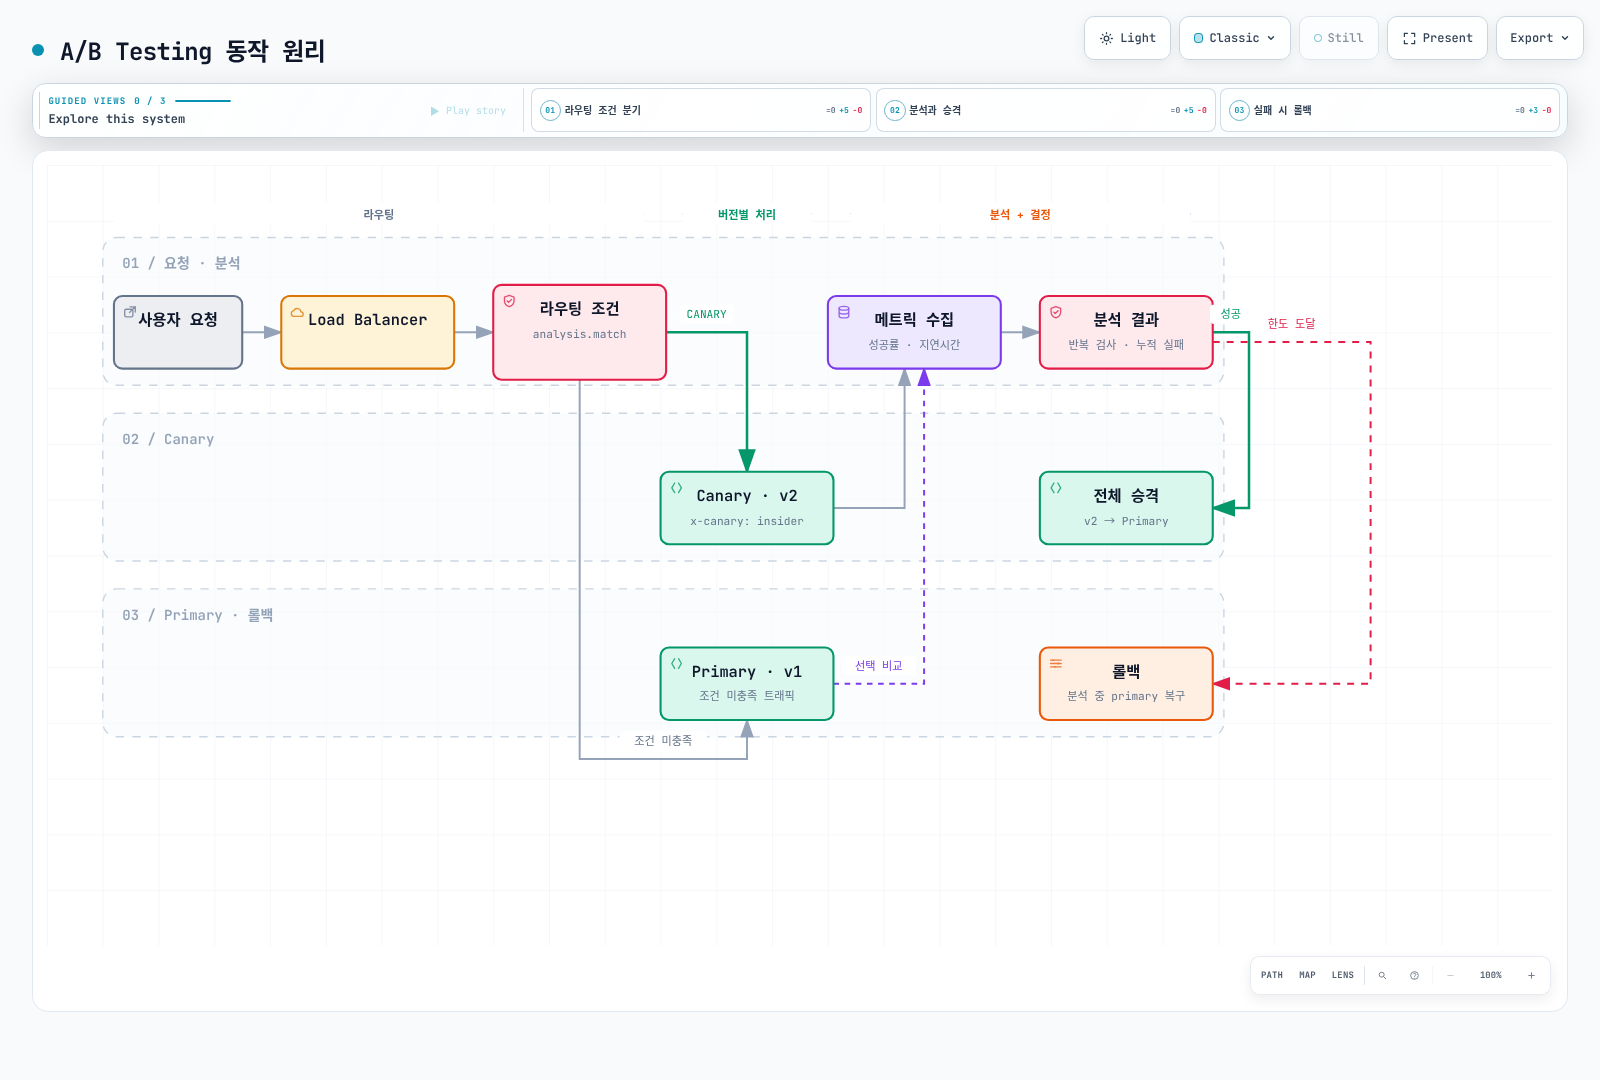
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: istio
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    portName: http
    gateways:
    - mesh
    hosts:
    - podinfo
    trafficPolicy:
      tls:
        mode: ISTIO_MUTUAL
  analysis:
    interval: 1m
    threshold: 5
    metrics:
    - name: request-success-rate
      thresholdRange:
        min: 99
        max: 100
      interval: 1m
    - name: request-duration
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
        cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/
    iterations: 10
    match:
    - headers:
        x-canary:
          exact: insider
    - headers:
        cookie:
          regex: (^|.*;\s*)canary=always(;.*|$)
여러 match 항목은 OR이며 한 항목의 조건은 provider 규칙을 따릅니다. 예제 cookie 정규식은 세미콜론 뒤 공백을 처리합니다. Istio sourceLabels는 workload 레이블이지 소스 IP 조건이 아닙니다. Gateway 구현/버전별 matcher 지원을 확인합니다.
라우팅은 인증이나 통계 실험 전체를 구현하지 않습니다. 클라이언트가 바꿀 수 있는 헤더/쿠키를 직원 권한으로 신뢰하지 말고 신뢰하는 edge에서 cohort를 할당하고 서버에서 권한을 확인합니다. 실제 A/B 결론에는 표본 수·할당 방식·통계 검정도 필요합니다.
기본 mesh 경로는 주입된 loadtester Pod에서 확인합니다. 외부 Gateway 경로는 실제 hostname/TLS/ingress로 별도 검사합니다. -canary 주소를 직접 호출하면 라우팅 조건을 검증하는 것이 아닙니다.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS http://podinfo.flagger-demo.svc.cluster.local:9898/
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -H 'x-canary: insider' http://podinfo.flagger-demo.svc.cluster.local:9898/
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -b 'canary=always' http://podinfo.flagger-demo.svc.cluster.local:9898/
Custom Metrics 및 Webhook
Prometheus MetricTemplate
다음 query는 Istio sidecar 지표 계약입니다. namespace/workload 레이블, reporter, scrape를 확인합니다. 5xx 시계열만 없으면 분자를 0으로 보완하지만 전체 트래픽 부재나 0 분모를 성공으로 바꾸지 않습니다. 최소 100건과 지연/오류 기준은 설명용이며 SLO·표본 요구에 맞게 조정합니다.
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: istio-error-rate
  namespace: flagger-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.monitoring.svc.cluster.local:9090
  query: |
    (sum(rate(istio_requests_total{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}", response_code=~"5.."}[{{ interval }}])) or vector(0)) / sum(rate(istio_requests_total{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}"}[{{ interval }}])) * 100
---
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: istio-latency-ms
  namespace: flagger-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.monitoring.svc.cluster.local:9090
  query: |
    histogram_quantile(0.99, sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}"}[{{ interval }}])) by (le))
---
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: istio-request-count
  namespace: flagger-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.monitoring.svc.cluster.local:9090
  query: |
    sum(increase(istio_requests_total{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}"}[{{ interval }}]))
---
spec:
  analysis:
    metrics:
    - name: error-rate
      templateRef:
        name: istio-error-rate
      thresholdRange:
        min: 0
        max: 1
      interval: 1m
    - name: latency-p99-ms
      templateRef:
        name: istio-latency-ms
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    - name: request-count
      templateRef:
        name: istio-request-count
      thresholdRange:
        min: 100
      interval: 1m
MetricTemplate은 하나의 숫자를 반환해야 합니다. Prometheus provider는 빈 결과/NaN을 실패로 처리합니다. 백분율에는 유한한 0–100 범위도 두고, custom latency의 ms/seconds 단위를 일치시킵니다. min 이상·max 이하가 허용 범위입니다. 조회 창이 겹치는 측정은 독립 표본으로 간주하지 않습니다.
Datadog 단위와 선택 datapoint
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: datadog-average-latency-ms
  namespace: flagger-demo
spec:
  provider:
    type: datadog
    address: https://api.datadoghq.com
    secretRef:
      name: datadog-api
  query: |
    avg:myapp.request_duration_ms{kube_deployment:{{ target }},kube_namespace:{{ namespace }}}.rollup(avg, 60)
---
apiVersion: v1
kind: Secret
metadata:
  name: datadog-api
  namespace: flagger-demo
type: Opaque
stringData:
  datadog_api_key: REPLACE_WITH_API_KEY
  datadog_application_key: REPLACE_WITH_APPLICATION_KEY
myapp.request_duration_ms는 별도로 발행할 custom 평균 latency(ms) 예제이며 P99가 아닙니다. 사이트는 provider.address로 선택합니다. native client는 표시된 두 Secret 키를 읽고 datadog_site는 사용하지 않습니다. metric interval의 10배를 조회하여 첫 시계열의 가장 오래된 첫 datapoint를 반환합니다. 최신 canary 검증의 유일한 지표로 사용하지 말고 신선한 버전별 측정으로 보완합니다.
추가로 원본 client를 사용한 로컬 모의 응답 검증에서 첫 datapoint의 null이 0으로 디코딩되는 것을 확인했습니다. 0ms를 정상으로 받아들이는 latency gate에는 특히 주의가 필요합니다. 최신 timestamp와 결측값을 검증하는 중계 또는 신선한 Prometheus 지표를 사용합니다.
CloudWatch 지원 필드와 한계
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: cloudwatch-error-percent
  namespace: flagger-demo
spec:
  provider:
    type: cloudwatch
    region: ap-northeast-2
  query: |
    [
      {
        "Id": "errorrate",
        "Expression": "IF(FILL(requests,0)>=100,100*FILL(errors,0)/FILL(requests,0),-1)",
        "Label": "CanaryErrorPercent",
        "ReturnData": true
      },
      {
        "Id": "errors",
        "MetricStat": {
          "Metric": {
            "Namespace": "MyApp",
            "MetricName": "5xxErrors",
            "Dimensions": [
              {
                "Name": "Service",
                "Value": "{{ target }}"
              },
              {
                "Name": "Namespace",
                "Value": "{{ namespace }}"
              }
            ]
          },
          "Period": 60,
          "Stat": "Sum"
        },
        "ReturnData": false
      },
      {
        "Id": "requests",
        "MetricStat": {
          "Metric": {
            "Namespace": "MyApp",
            "MetricName": "TotalRequests",
            "Dimensions": [
              {
                "Name": "Service",
                "Value": "{{ target }}"
              },
              {
                "Name": "Namespace",
                "Value": "{{ namespace }}"
              }
            ]
          },
          "Period": 60,
          "Stat": "Sum"
        },
        "ReturnData": false
      }
    ]
---
spec:
  analysis:
    metrics:
    - name: cw-error-percent
      templateRef:
        name: cloudwatch-error-percent
      thresholdRange:
        min: 0
        max: 1
      interval: 1m
provider.region은 지원되며 필수입니다. MyApp 지표와 Service/Namespace 차원을 별도로 발행해야 합니다. 식은 결측·저트래픽 구간을 -1로 표현하여 0–1% 검사에 통과시키지 않습니다. 수집 지연으로 거부될 수 있으므로 실제 발행 주기와 집계/조회 창을 검증합니다.
native provider는 metric interval의 10배를 조회하고 첫 결과의 첫 값을 선택하며 timestamp/StatusCode를 별도로 검사하지 않습니다. 오래된 datapoint나 ALB 전체 지표를 현재 canary의 증거로 오인하지 않도록 현재 버전의 Prometheus 요청/헬스 검사 등으로 보완합니다. 필요한 AWS API 권한은 GetMetricData입니다.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "cloudwatch:GetMetricData",
      "Resource": "*",
      "Condition": {
        "StringEquals": {
          "aws:RequestedRegion": "ap-northeast-2"
        }
      }
    }
  ]
}
CloudWatch를 사용할 때만 Flagger ServiceAccount 인증과 역할 trust를 구성하고 region 조건을 맞춥니다. 이 검토에서는 AWS API를 호출하거나 역할을 배포하지 않았습니다.
Webhook 계약
| Type | 의미 / 거절 시 동작 |
|---|---|
| confirm-rollout | 시작 승인 대기 |
| pre-rollout | 첫 트래픽 전환 전 검사; 실패 수 증가 |
| rollout | 분석 중 호출; 실패 수 증가 |
| confirm-traffic-increase | 다음 가중치 증가 승인 대기 |
| confirm-promotion | 승격 승인 대기 |
| post-rollout | Succeeded 또는 Failed 후 통지/정리; 결과를 되돌리지 않음 |
| rollback | 분석/승인 대기 중 성공 응답이면 rollback 요청 |
| event | 상태 관련 이벤트 전달 |
일반적으로 HTTP 200을 반환하는 계약을 사용합니다. 1.45.0은 202보다 큰 상태 코드를 오류로 취급하므로 204도 성공으로 가정하지 않습니다. metadata는 그대로 복사되어 {{ .Version }}가 치환되지 않습니다. payload의 name/namespace/phase/checksum으로 상태를 판단합니다. 비성공 response body는 로그/이벤트에 남을 수 있어 민감한 값을 반환하지 않습니다.
name: podinfo
namespace: flagger-demo
phase: Progressing
checksum: example-revision-checksum
metadata:
  gate: promotion
Webhook에는 임의 Authorization header 설정이 없습니다. 필요한 인증은 검토된 mTLS/내부 proxy 경계로 구현하며 비밀을 공개 Git의 URL/metadata에 넣지 않습니다. TLS 검증을 끄는 옵션은 기본 예제로 사용하지 않습니다.
cmd load test는 비동기 수락이며 HTTP 성공이 부하 테스트 품질 통과를 뜻하지 않습니다. bash는 완료를 기다리므로 timeout 안에 끝나야 합니다. 0.39.0 이미지에 curl/jq/hey/wrk/bash는 있지만 k6는 없습니다. k6에는 별도 검증한 이미지가 필요하며 check()만으로 실패 exit를 기대하지 말고 thresholds도 설정합니다.
아래는 k6가 준비된 전용 테스트 이미지에 넣을 script 예제입니다. 기본 loadtester 이미지에 그대로 실행하는 명령이 아닙니다.
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  vus: 2,
  duration: '20s',
  thresholds: {
    checks: ['rate==1'],
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(99)<500'],
  },
};
export default function () {
  const result = http.get('http://podinfo-canary.flagger-demo.svc.cluster.local:9898/');
  check(result, { 'HTTP 200': (response) => response.status === 200 });
  sleep(0.5);
}
수동 승인 (Manual Gating)
spec:
  analysis:
    webhooks:
    - name: promotion-approval
      type: confirm-promotion
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/gate/check
      timeout: 5s
      metadata:
        gate: promotion
기존 Canary의 webhooks 목록에 병합합니다. /gate/approve는 항상 승인하는 테스트 endpoint이므로 수동 게이트로 쓰지 않습니다. /gate/check는 name.namespace 메모리 상태를 읽습니다. 같은 JSON body를 open/close/check에 전달합니다. close는 승격 보류이며 rollback이 아닙니다.
# Close before starting a new revision.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/gate/close
# Approve the reviewed revision.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/gate/open
# A closed gate returns 403.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -sS -o /dev/null -w '%{http_code}\n' -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/gate/check
내장 gate는 checksum별 승인이 아니고 Pod 재시작 시 초기화되며 replica 간에 공유되지 않습니다. 다음 배포 전에 다시 닫습니다. 운영용 승인은 인증·감사·만료와 name/namespace/checksum/gate별 상태를 갖춘 외부 서비스로 구현합니다. 같은 메모리 gate를 시작/승격 양쪽에 연결해 독립 승인처럼 다루지 않습니다.
수동 rollback과 suspend
spec:
  analysis:
    webhooks:
    - name: operator-rollback
      type: rollback
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/rollback/check
      timeout: 5s
rollback endpoint는 평소 403으로 신호 없음, 요청할 때 200으로 신호를 줍니다. 알림 수신 서버를 이 hook에 연결하면 성공 응답 자체가 의도치 않은 rollback 요청이 될 수 있습니다. 다음은 정상적으로 조정 중인 분석/승격 승인 대기 단계의 요청 예제입니다. 즉시 실행이나 모든 단계의 복구를 보장하는 스위치가 아닙니다.
kubectl get canary podinfo -n flagger-demo -o jsonpath='{.status.phase}{"\n"}'
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/rollback/open
kubectl get canary podinfo -n flagger-demo --watch
# Reset the request after observing the operation.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/rollback/close
controller/readiness 문제나 닫힌 confirm-rollout gate는 이 hook 이전에 조정을 중단할 수 있습니다. Promoting/Finalising 단계의 primary 장애도 앞서 설명한 별도 복구 상황입니다. 배포가 끝난 뒤 rollback gate를 열어 두면 다음 배포에 영향을 줄 수 있습니다.
flagger.app/rollback, flagger.app/suspend, flagger.app/skipAnalysis 어노테이션을 제어 API로 가정하지 않습니다. suspend와 skipAnalysis는 spec 필드입니다. suspend는 트래픽을 primary로 돌리지 않고 rollback hook도 포함해 조정을 멈춥니다. skipAnalysis는 분석 없이 승격하므로 rollback 옵션이 아닙니다. Git 관리 대상은 원본 설정도 바꿉니다.
spec:
  suspend: true
GitOps 통합 (Flux + Flagger)
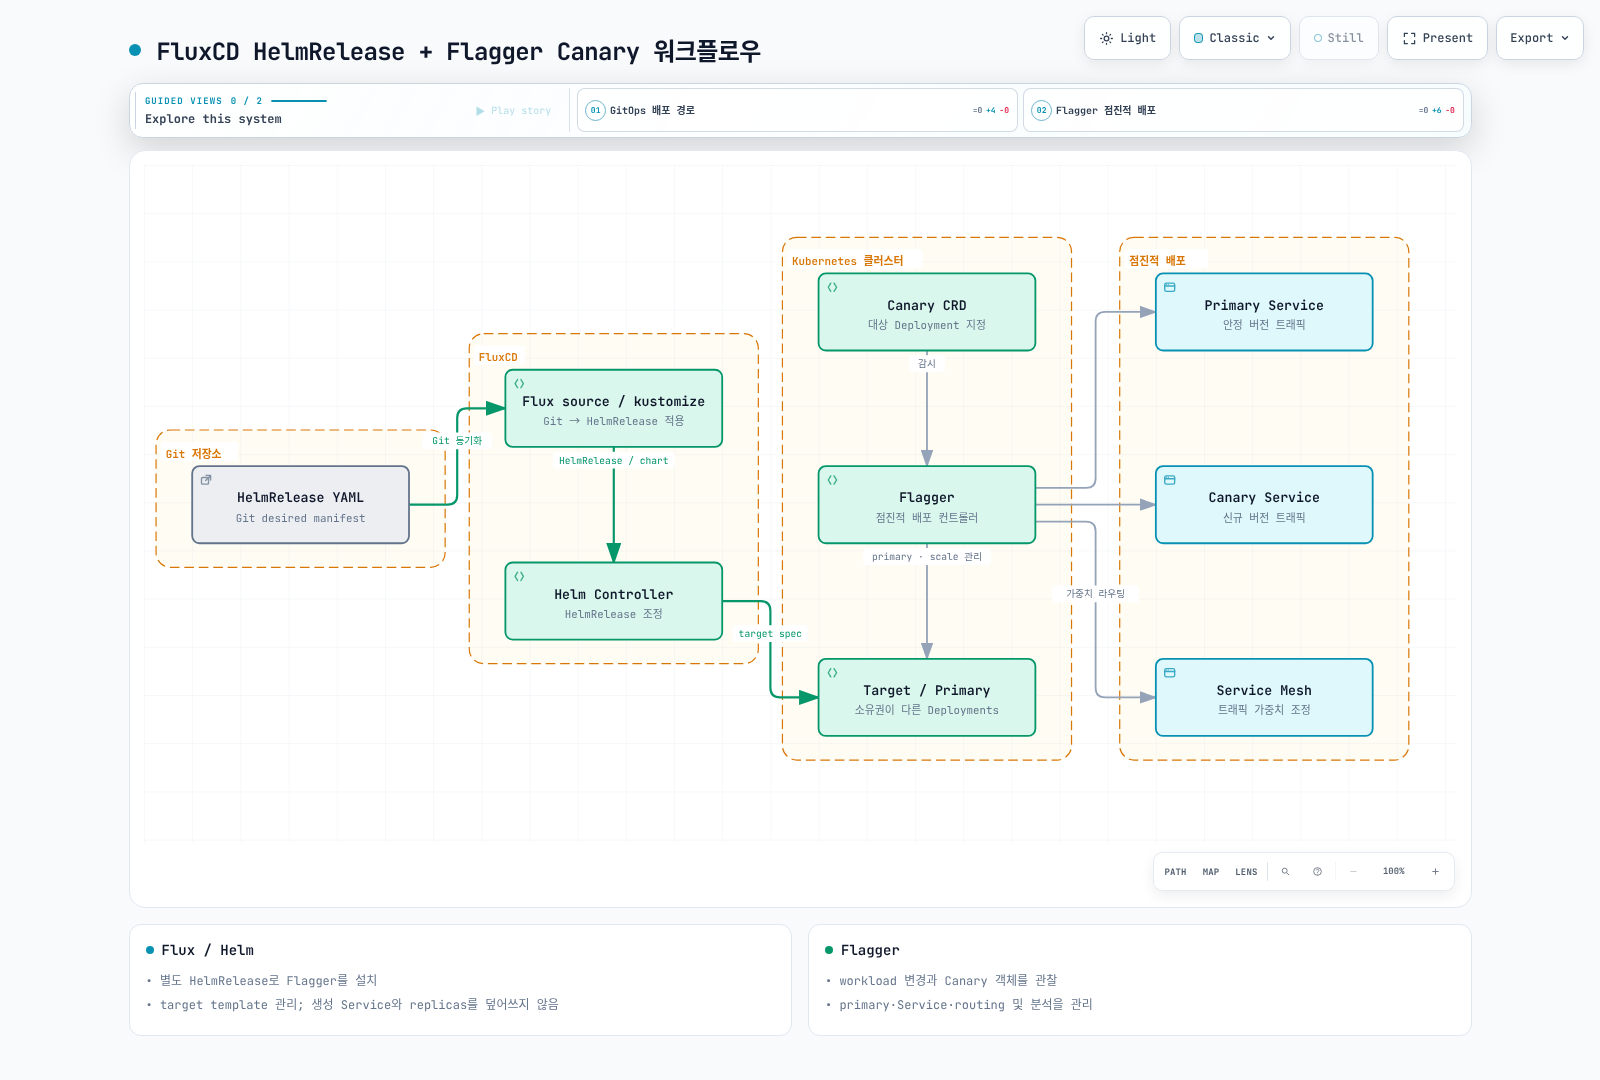
Flux bootstrap이 Flagger를 내장 controller로 설치하는 것은 아닙니다. 아래 HelmRelease 또는 Kustomization으로 별도 설치합니다. Helm CLI 설치와 같은 release를 이중 관리하지 않습니다. 앞서 준비한 namespace, ServiceAccount, NetworkPolicy도 Git에서 관리합니다.
apiVersion: source.toolkit.fluxcd.io/v1
kind: HelmRepository
metadata:
  name: flagger
  namespace: flagger-system
spec:
  interval: 1h
  url: https://flagger.app
---
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: flagger
  namespace: flagger-system
spec:
  interval: 1h
  releaseName: flagger
  chart:
    spec:
      chart: flagger
      version: 1.45.0
      sourceRef:
        kind: HelmRepository
        name: flagger
  install:
    crds: Create
  upgrade:
    crds: CreateReplace
  values:
    fullnameOverride: flagger
    meshProvider: istio
    namespace: flagger-demo
    noCrossNamespaceRefs: true
    metricsServer: http://prometheus.monitoring.svc.cluster.local:9090
    prometheus:
      install: false
    leaderElection:
      enabled: true
      replicaCount: 2
    resources:
      requests:
        cpu: 100m
        memory: 128Mi
      limits:
        cpu: '1'
        memory: 512Mi
    podDisruptionBudget:
      enabled: true
      minAvailable: 1
---
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: loadtester
  namespace: flagger-system
spec:
  interval: 1h
  releaseName: flagger-loadtester
  chart:
    spec:
      chart: loadtester
      version: 0.39.0
      sourceRef:
        kind: HelmRepository
        name: flagger
  values:
    fullnameOverride: flagger-loadtester
    replicaCount: 1
    service:
      type: ClusterIP
      port: 80
    serviceAccountName: flagger-loadtester
    rbac:
      create: false
    cmd:
      timeout: 2m
      namespaceRegexp: ^flagger-demo$
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
    securityContext:
      enabled: true
      context:
        allowPrivilegeEscalation: false
        capabilities:
          drop:
          - ALL
        readOnlyRootFilesystem: true
        runAsUser: 100
        runAsGroup: 101
    volumes:
    - name: tmp
      emptyDir: {}
    volumeMounts:
    - name: tmp
      mountPath: /tmp
Flux가 CRD를 CreateReplace로 갱신하는 설정도 무조건 안전한 migration 보장은 아닙니다. 업그레이드할 CRD 변경과 기존 저장 객체를 검토합니다. 소스와 provider 설치가 준비된 뒤 Canary 객체를 적용합니다.
HelmRelease 방식의 애플리케이션
apiVersion: source.toolkit.fluxcd.io/v1
kind: HelmRepository
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  interval: 1h
  url: https://stefanprodan.github.io/podinfo
---
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  interval: 5m
  releaseName: podinfo
  chart:
    spec:
      chart: podinfo
      version: 6.15.0
      sourceRef:
        kind: HelmRepository
        name: podinfo
  values:
    service:
      enabled: false
    hpa:
      enabled: true
      minReplicas: 2
      maxReplicas: 4
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
Podinfo 6.15.0의 service.enabled=false는 Flagger와 Service 소유권 충돌을 피합니다. hpa.enabled=true이면 chart가 Deployment replicas를 고정하지 않습니다. 기본 manifest와 이 HelmRelease를 동시에 적용하지 않습니다. 다른 chart는 동일한 값 이름을 가정하지 말고 실제 렌더링으로 확인합니다.
Canary CRD는 앞선 예제와 함께 관리합니다. Flux/Helm의 Ready는 원하는 리소스 적용/readiness 상태이며 해당 revision의 Flagger 승격 완료를 자동으로 뜻하지 않습니다. 다음 환경 승격은 현재 변경과 일치하는 Canary 상태·checksum·실제 배포 버전을 확인한 뒤 진행합니다.
Kustomization 방식
apiVersion: kustomize.toolkit.fluxcd.io/v1
kind: Kustomization
metadata:
  name: podinfo
  namespace: flux-system
spec:
  interval: 10m
  targetNamespace: flagger-demo
  sourceRef:
    kind: GitRepository
    name: flux-system
  path: ./apps/podinfo
  prune: true
timeout: 5mapiVersion: kustomize.config.k8s.io/v1beta1
kind: Kustomization
namespace: flagger-demo
resources:
- deployment.yaml
- hpa.yaml
- canary.yaml위 sourceRef는 기본 bootstrap GitRepository 이름입니다. apps/podinfo에는 앞선 native manifest를 저장하며 Flagger가 관리하는 Service/primary 리소스를 넣지 않습니다. Kustomization의 적용 완료를 배포 승격 완료로 오인하지 않습니다.
환경 overlay는 scalar 설정만 바꾸는 JSON patch로 만들 수 있습니다. 아래는 선택 예시이며 정해진 운영 표준값이 아닙니다. 다른 CRD patch에서 배열이 교체되는 동작도 확인합니다.
apiVersion: kustomize.config.k8s.io/v1beta1
kind: Kustomization
resources:
- ../base
patches:
- target:
    group: flagger.app
    version: v1beta1
    kind: Canary
    name: podinfo
  patch: |
    - op: replace
      path: /spec/analysis/threshold
      value: 3
    - op: replace
      path: /spec/analysis/maxWeight
      value: 30
    - op: replace
      path: /spec/analysis/stepWeight
      value: 5
Image Automation과 승격 브랜치
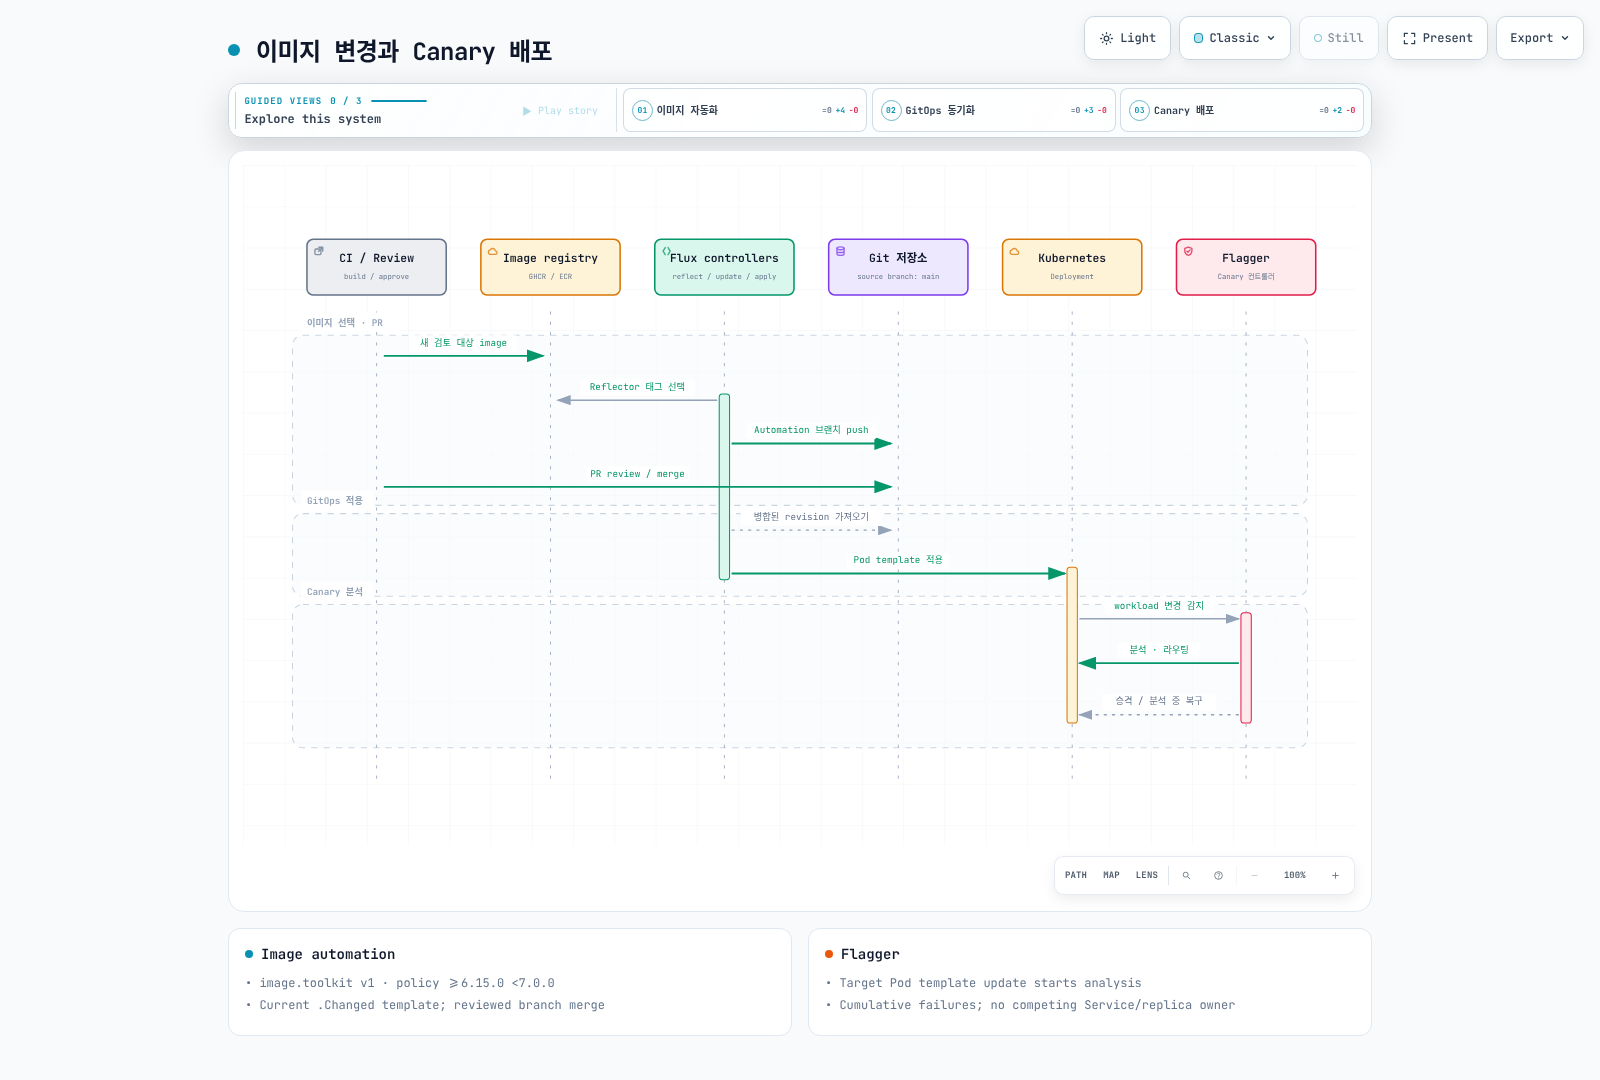
apiVersion: image.toolkit.fluxcd.io/v1
kind: ImageRepository
metadata:
  name: podinfo
  namespace: flux-system
spec:
  image: ghcr.io/stefanprodan/podinfo
  interval: 5m
---
apiVersion: image.toolkit.fluxcd.io/v1
kind: ImagePolicy
metadata:
  name: podinfo
  namespace: flux-system
  labels:
    app: podinfo
spec:
  imageRepositoryRef:
    name: podinfo
  policy:
    semver:
      range: '>=6.15.0 <7.0.0'
  digestReflectionPolicy: IfNotPresent
---
apiVersion: image.toolkit.fluxcd.io/v1
kind: ImageUpdateAutomation
metadata:
  name: podinfo
  namespace: flux-system
spec:
  interval: 5m
  sourceRef:
    kind: GitRepository
    name: flux-system
  policySelector:
    matchLabels:
      app: podinfo
  git:
    checkout:
      ref:
        branch: main
    commit:
      author:
        name: Flux
        email: flux@example.com
      messageTemplate: |-
        Update podinfo image
        {{ range .Changed.Changes }}{{ .OldValue }} -> {{ .NewValue }}
        {{ end }}
    push:
      branch: flux/podinfo-updates
  update:
    path: ./apps/podinfo
    strategy: Setters
image-reflector와 image-automation controller, policy marker와 Git 쓰기 권한이 필요합니다. 이 예제는 main이 아닌 전용 브랜치에 push하므로 PR 생성/검사/병합은 별도 절차입니다. 실제 저장소/경로를 맞추고 자동화 전용 브랜치를 사용합니다. .NewTag 같은 없는 commit-template 필드 대신 현재 .Changed 모델을 사용합니다.
# Native Deployment Pod-template fragment.
spec:
  template:
    spec:
      containers:
      - name: podinfo
image: ghcr.io/stefanprodan/podinfo:6.15.0 # {"$imagepolicy": "flux-system:podinfo"}# Alternative: merge into HelmRelease.spec.values.
image:
repository: ghcr.io/stefanprodan/podinfo
tag: "6.15.0" # {"$imagepolicy": "flux-system:podinfo:tag"}tag 전용 marker는 digest 고정이 아닙니다. chart의 digest 지원 또는 registry의 tag 불변성·검증 절차를 확인합니다. 같은 이미지 값을 Kustomize images와 Deployment marker 양쪽에서 다르게 덮어쓰지 않습니다. ECR로 바꾸면 image-reflector의 AWS 인증과 실제 Pod image-pull 권한을 각각 준비합니다.
Observability 및 알림
Flagger metrics와 Istio/application metrics는 서로 다른 scrape 대상입니다. annotation만으로 모든 Prometheus 구성이 자동 수집하는 것은 아닙니다. Prometheus Operator 사용 시 chart의 serviceMonitor.enabled와 실제 selector/namespace/mTLS 설정을 맞춥니다.
serviceMonitor:
  enabled: true
  labels:
    release: prometheus
release 레이블은 예시이며 Prometheus의 serviceMonitorSelector와 일치해야 합니다. 설치된 Operator CRD가 선행 조건입니다.
| 메트릭 | 유형 / 실제 의미 |
|---|---|
| flagger_info | Gauge, version/mesh_provider |
| flagger_canary_total | Gauge, namespace별 Canary 객체 수 |
| flagger_canary_status | Gauge, 0=Progressing, 2=Failed, 나머지 phase는 1로 매핑 |
| flagger_canary_weight | Gauge, workload/namespace별 트래픽 가중치 |
| flagger_canary_metric_analysis | Gauge, metric별 실제 측정값; 일반적인 0/1 통과 판정 아님 |
| flagger_canary_duration_seconds | Histogram, 분석 조정 호출의 처리 시간; 배포 전체 시간 아님 |
| flagger_canary_successes_total / failures_total | Counter, 결과 횟수; strategy/analysis_status 구분 |
status의 1만으로 Succeeded를 판정하지 않습니다. 승인 대기/승격 등도 같은 값일 수 있으므로 실제 Canary.status.phase와 해당 revision을 확인합니다. name 레이블은 targetRef.name이며 Canary 객체 이름과 항상 같지는 않습니다. weight는 name 대신 workload 레이블을 씁니다. 내장 iterations 메트릭을 가정하지 말고 status.iterations를 조회합니다.
Grafana 대시보드
다음 query를 현재 Grafana의 Stat/Time series 패널에 구성할 수 있습니다. 중앙 집계라면 cluster 외부 레이블도 필터링합니다. Flagger clusterName 설정은 알림용이며 Prometheus metric에 cluster 레이블을 자동 추가하지 않습니다.
flagger_canary_status{namespace="flagger-demo"}
flagger_canary_weight{namespace="flagger-demo",workload="podinfo"}
flagger_canary_metric_analysis{namespace="flagger-demo",name="podinfo",metric="request-success-rate"}
increase(flagger_canary_successes_total{namespace="flagger-demo",analysis_status="completed"}[7d])
increase(flagger_canary_failures_total{namespace="flagger-demo",analysis_status="completed"}[7d])
공식 Istio dashboard JSON도 참고할 수 있지만, 파일의 datasource 이름과 panel/schema를 현재 Grafana에서 검증한 뒤 export합니다. JSON은 Kubernetes manifest가 아니므로 kubectl apply에 바로 넣지 않습니다. HTTP dashboard API의 {"dashboard": ...} envelope가 아닌 export된 dashboard 모델을 파일로 사용합니다.
curl -fsSL -o flagger-istio-reference.json \
  https://raw.githubusercontent.com/fluxcd/flagger/v1.45.0/charts/grafana/dashboards/istio.json
# After reviewing/exporting flagger-dashboard.json in Grafana:
jq -e '.title and (.panels | type == "array")' flagger-dashboard.json >/dev/null
kubectl create configmap flagger-dashboard -n monitoring \
  --from-file=flagger-dashboard.json=./flagger-dashboard.json \
  --dry-run=client -o yaml > flagger-dashboard-cm.yaml
kubectl label --local -f flagger-dashboard-cm.yaml grafana_dashboard=1 \
  -o yaml > flagger-dashboard-ready.yaml
생성한 ConfigMap은 검토 후 GitOps 경로에 둡니다. Grafana sidecar/provisioner가 해당 레이블과 namespace를 읽도록 별도로 구성해야 합니다. 확인되지 않은 dashboard ID를 설치 지침으로 사용하지 않습니다.
Prometheus 경보
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: flagger-alerts
  namespace: monitoring
spec:
  groups:
  - name: flagger
    rules:
    - alert: FlaggerAnalysisFailed
      expr: flagger_canary_status == 2
      for: 1m
      labels:
        severity: warning
      annotations:
        summary: Flagger analysis failed for {{ $labels.namespace }}/{{ $labels.name }}
        description: Inspect Canary phase, events, and actual routing before assuming the old primary is serving
          traffic.
    - alert: FlaggerAnalysisLongRunning
      expr: flagger_canary_status == 0
      for: 1h
      labels:
        severity: warning
      annotations:
        summary: Flagger analysis remains active for {{ $labels.namespace }}/{{ $labels.name }}
        description: Check approval gates, failed checks and workload readiness; this is not a measurement of rollout
          duration.
이 예제는 클러스터별 Prometheus를 전제로 합니다. ==0의 for:1h는 Progressing으로 관찰된 조건의 지속 시간이며 모든 활성 phase나 배포 시작 시각을 측정하지 않습니다. 의도적인 gate 대기는 별도 판단합니다. histogram의 기본 bucket은 짧은 조정 처리 시간을 위한 것이며 time()-duration 계산이나 600초 배포 P99 경보로 쓰지 않습니다.
Slack, Teams와 외부 알림
apiVersion: flagger.app/v1beta1
kind: AlertProvider
metadata:
  name: slack
  namespace: flagger-demo
spec:
  type: slack
  channel: C0123456789
  username: flagger
  secretRef:
    name: slack-bot
---
apiVersion: v1
kind: Secret
metadata:
  name: slack-bot
  namespace: flagger-demo
type: Opaque
stringData:
  address: https://slack.com/api/chat.postMessage
  token: REPLACE_WITH_SLACK_BOT_TOKEN
---
spec:
  analysis:
    alerts:
    - name: deployment-alerts
      severity: info
      providerRef:
        name: slack
Secret 값은 설명용이며 실제 token을 Git에 저장하지 않습니다. 이 버전의 AlertProvider secretRef에는 address가 필수이며 Slack Bot API를 쓸 때 token도 둡니다. Bot에 필요한 chat:write와 채널 참여를 구성하고 channel을 실제 ID로 바꿉니다. Incoming Webhook을 쓰면 생성한 채널/허용된 override 동작을 확인합니다.
severity는 배타적인 채널 분류가 아니라 최소 수준입니다. info는 모든 수준, warn은 warn/error, error는 error를 받습니다. 같은 수신자에 중복 구독하면 중복 알림이 생길 수 있습니다.
Flagger 1.45.0의 native msteams는 아직 MessageCard를 생성합니다. Workflows의 Adaptive Card endpoint로 URL만 바꾸면 된다고 가정하지 않습니다. 호환 변환기 또는 event Webhook 수신자가 인증과 payload 변환을 수행하도록 별도 구성합니다. Flux 2.9.6의 Teams 구현과 혼동하지 않습니다.
native AlertProvider에 PagerDuty Events API 타입이 있다고 가정하지 않습니다. type: slack을 PagerDuty URL에 연결하면 payload가 맞지 않습니다. 기존 Slack 연동 또는 검증된 이벤트 변환 서비스를 사용합니다.
배포 이력과 이벤트
spec:
  analysis:
    webhooks:
    - name: deployment-events
      type: event
      url: http://deployment-events.flagger-system.svc.cluster.local/events
      timeout: 5s
      metadata:
        environment: demo
deployment-events는 별도로 준비할 내부 수신자 예시입니다. name/namespace/phase/checksum과 eventMessage/eventType/timestamp를 검증하고 저장합니다. post-rollout은 성공과 실패 모두 호출되므로 항상 promoted로 기록하지 않습니다. Flux Notification Alert의 eventSources에는 Canary가 지원되지 않으며 일반 Kubernetes 이벤트를 자동 수집하는 기능도 아닙니다.
kubectl get events -n flagger-demo \
  --field-selector involvedObject.kind=Canary,involvedObject.name=podinfo \
  --sort-by='.lastTimestamp'
kubectl get canaries -A -o custom-columns=\
NAME:.metadata.name,NAMESPACE:.metadata.namespace,PHASE:.status.phase,WEIGHT:.status.canaryWeight,LAST:.status.lastTransitionTime
Kubernetes 이벤트는 보존 기간이 있으므로 영구 이력은 외부 저장소에 남깁니다. changes(status[7d])는 상태 전이 수이지 배포 횟수가 아닙니다. 결과 counter도 skipped/completed와 실제 revision을 구분해 해석합니다.
프로덕션 모범 사례
비핵심/실습 workload에서 정상·실패·결측 데이터·승인 대기·primary 승격 장애를 먼저 확인합니다. failure threshold를 높이면 더 안전해지는 것이 아니라 rollback이 늦어질 수 있습니다. 큰 stepWeight는 더 많은 사용자를 노출하며, 긴 analysis interval은 문제 감지를 늦출 수 있습니다.
| 결정 | 근거 |
|---|---|
| 오류율·latency 범위 | 서비스 SLO, 실제 단위와 정상 분포 |
| 최소 요청 수 / 조회 창 | 저트래픽·수집 지연·표본 수 |
| 실패 한도 | 허용 노출 시간과 false alarm 비용 |
| 가중치 단계 | 영향 범위와 여유 replica/노드 용량 |
| progress deadline | Pod 시작·readiness·rolling update 진전 |
| 승인 / rollback | 인증, revision 구분, 장애 시 복구 절차 |
개발/금융 등 업종 이름만으로 99.9%·200ms 같은 기준이나 정확한 rollout 시간을 정하지 않습니다. 실제 환경에서 조정하고 실패/복구를 정기적으로 검증합니다.
설정 추적과 autoscaler
ConfigMap/Secret 추적은 기본 활성화됩니다. 참조된 설정 변경도 분석을 시작할 수 있습니다. 선택한 ConfigMap/Secret을 제외하려면 그 리소스에 아래 annotation을 사용합니다. 전역 configTracking.enabled=false도 가능하지만 변경 감지·primary 설정 복사에 미치는 영향을 확인합니다.
metadata:
  annotations:
    flagger.app/config-tracking: disabled
HPA/지원되는 KEDA scaler는 올바른 autoscalerRef와 Metrics Server/metric provider가 필요합니다. Flux·Helm이 Flagger의 scale/service 조정을 계속 덮어쓰지 않는지 렌더링과 실제 동작으로 확인합니다. PDB는 주로 자발적 eviction에 적용되며 controller scale-down이나 Deployment rolling update를 제한하는 보장이 아닙니다. workload의 rollout 전략과 readiness도 별도로 구성합니다.
Multi-Cluster Flagger
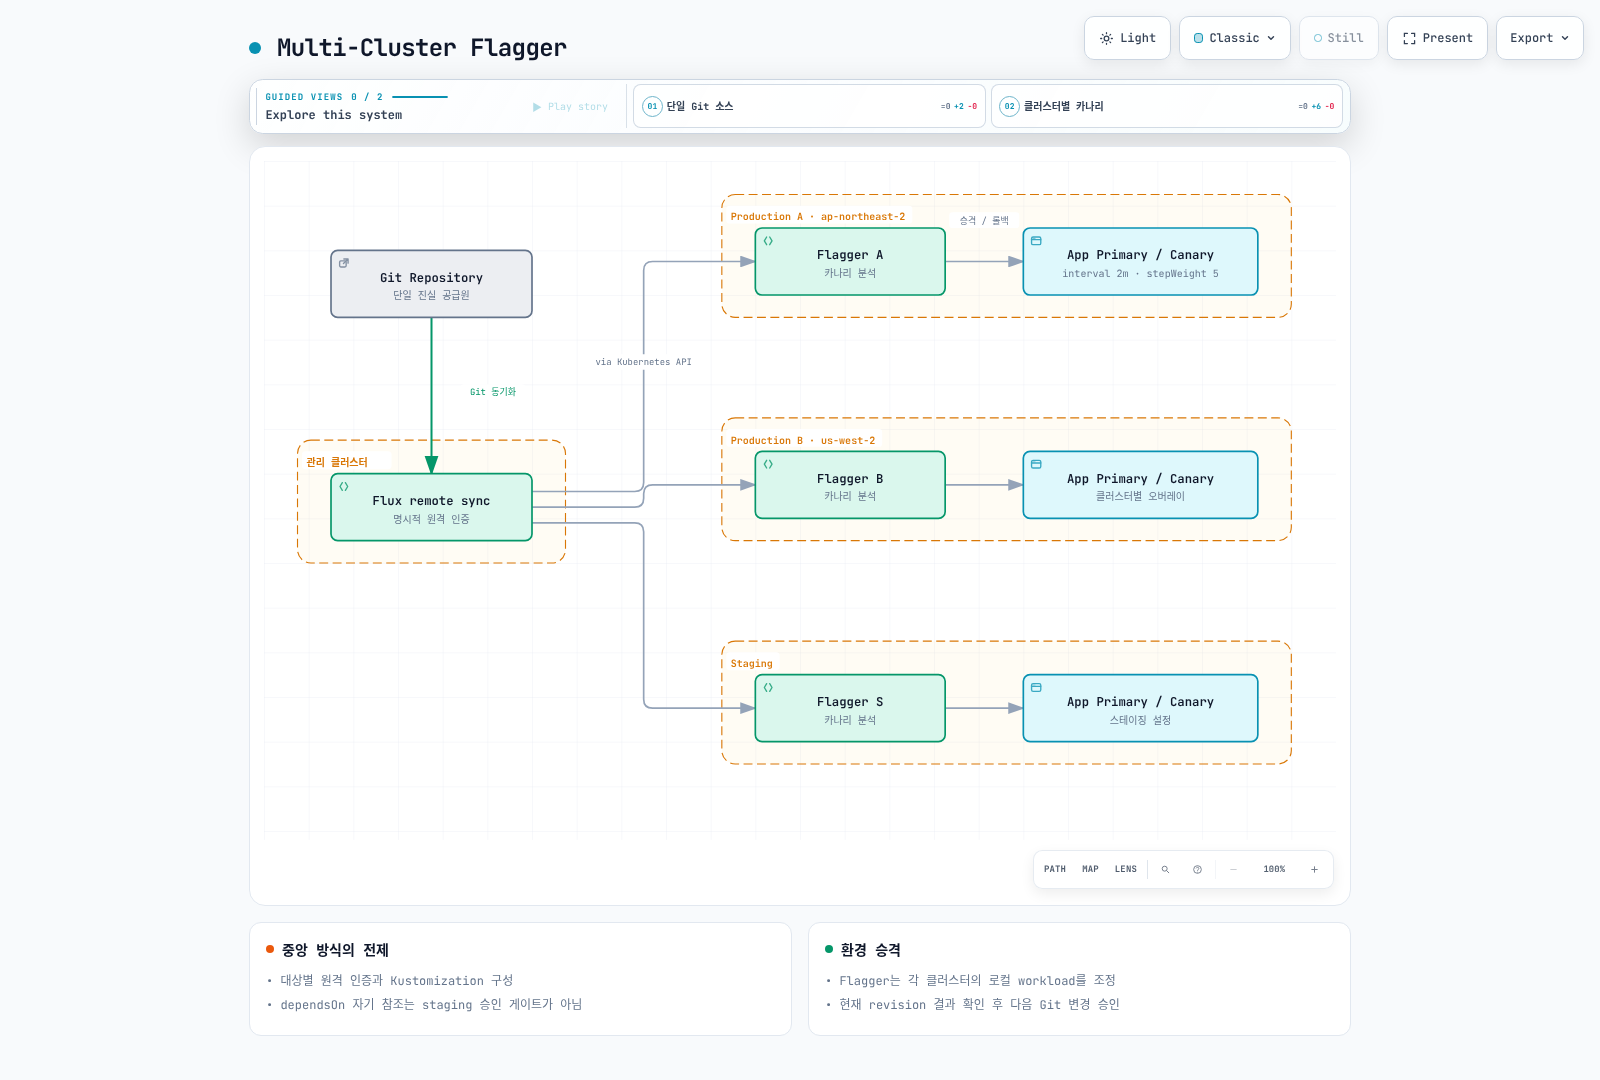
클러스터마다 Flux를 bootstrap하여 서로 다른 Git 경로를 읽거나, 중앙 Flux가 명시적 kubeConfig/workload identity로 원격 리소스를 적용하도록 구성합니다. 같은 Git 저장소를 쓴다는 이유만으로 원격 접근이 생기지는 않습니다. 각 클러스터의 Flagger는 로컬 workload를 제어합니다.
apiVersion: kustomize.toolkit.fluxcd.io/v1
kind: Kustomization
metadata:
  name: podinfo-production-a
  namespace: flux-system
spec:
  interval: 10m
  targetNamespace: flagger-demo
  sourceRef:
    kind: GitRepository
    name: flux-system
  path: ./apps/podinfo/overlays/production-a
  prune: true
위 예제는 해당 클러스터의 Flux가 실행하는 객체입니다. 자기 자신을 dependsOn으로 참조하지 않습니다. 독립 클러스터의 같은 이름을 dependsOn으로 찾을 수도 없습니다. 중앙 control plane에 서로 다른 원격 Kustomization을 만들더라도 Ready가 현재 Flagger revision의 승격 완료를 자동 보장하지 않으므로, 실제 결과를 확인한 release 절차가 다음 환경의 Git 변경을 승인해야 합니다.
관측을 중앙 집계하면 cluster 레이블과 보존 정책을 설정합니다. 알림·MetricTemplate의 namespace 분리만으로 테넌트 보안이 완성되는 것은 아니므로 RBAC, cross-namespace refs, 네트워크와 Secret 접근을 함께 제한합니다.
참고 문서
- Flagger 1.45.0 소스
- Deployment strategies
- Webhook 계약
- 실제 metrics recorder
- Scheduler / rollback 동작
- Gateway API 예제
- AWS App Mesh 지원 종료
- Kubernetes disruptions / PDB
- FluxCD
- Argo Rollouts 트래픽 관리
이전: GitOps 비교 · 다음: Feature Flags · 목록
퀴즈
Flagger 퀴즈에서 학습 내용을 확인하세요.