Part 3: 상태, 체크포인트와 스트리밍 패턴
검토: 2026-09-12. Operator 1.15.0. Kafka 예제는 Flink 2.2.1, Iceberg 예제는 별도 Flink 2.1.3 조합입니다.
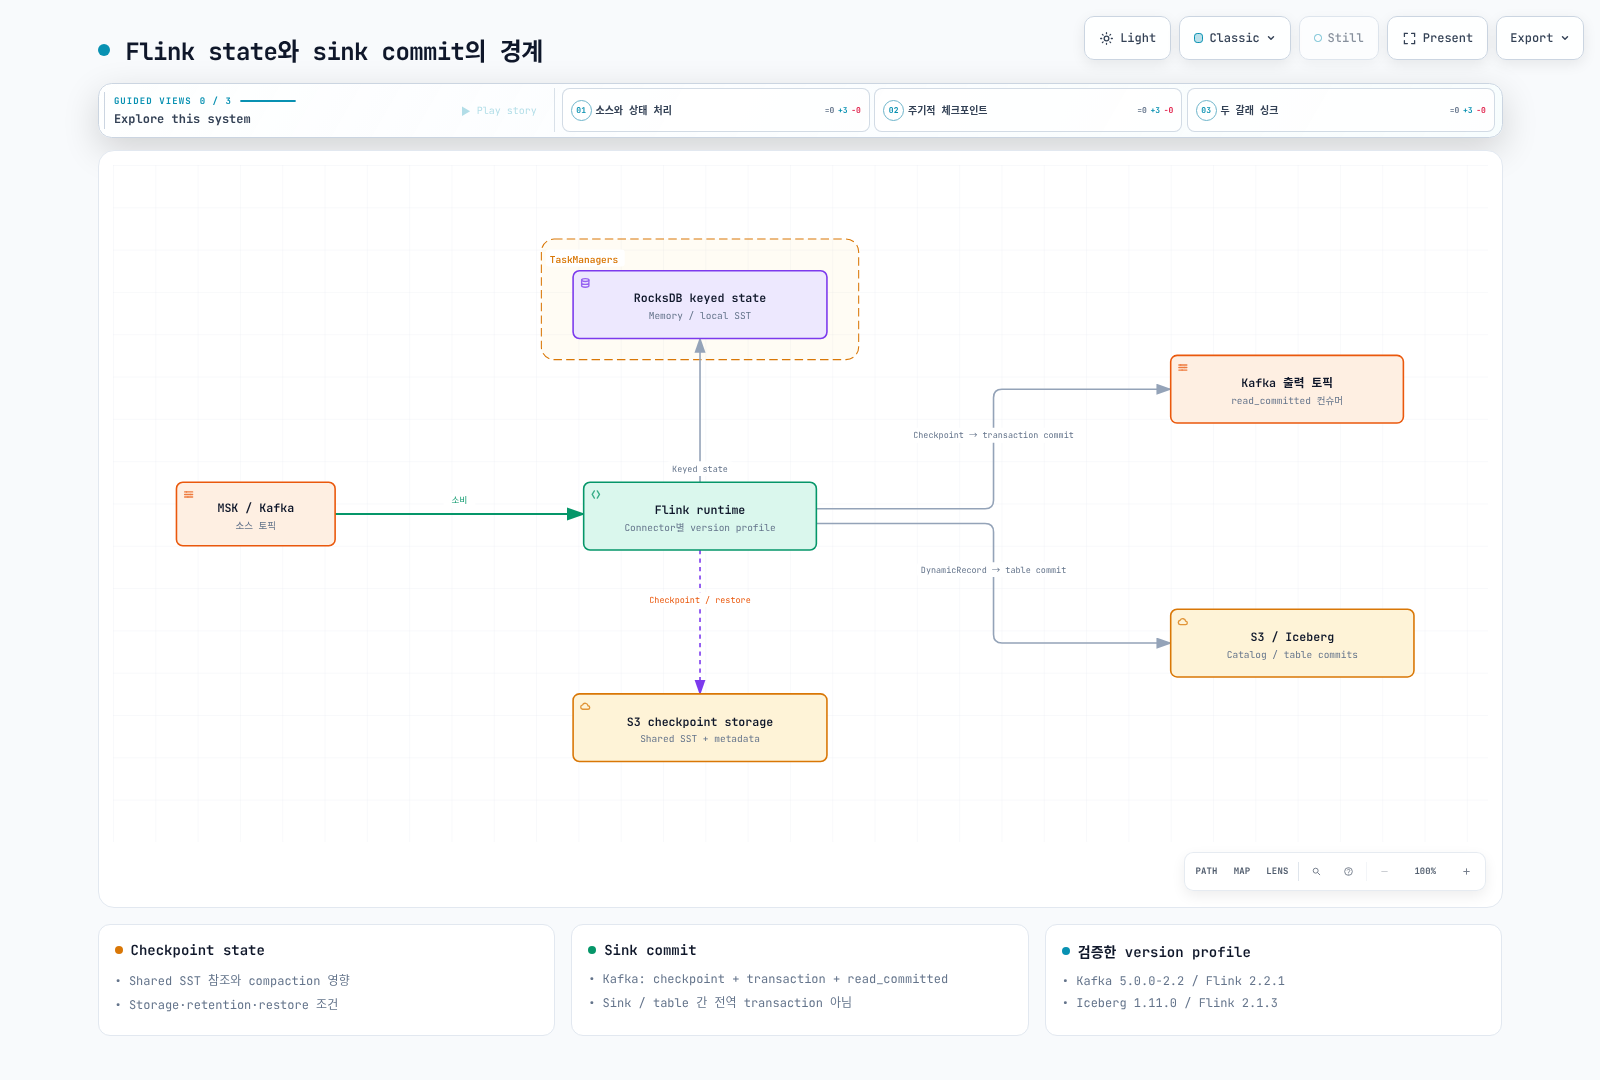
State는 집계·조인·중복 제거가 기억하는 데이터입니다. 모든 윈도우 집계가 원본 레코드 전체를 보관하는 것은 아니며, SUM/COUNT 같은 증분 집계는 accumulator를 유지할 수 있습니다. Stateless 처리도 source 재읽기·ack·외부 쓰기 오류로 데이터 유실/중복이 생길 수 있습니다. 내부 state 일관성, source 재생 가능성, sink commit 보장을 함께 검증해야 합니다.
1. 버전 조합부터 고정
| 예제 | Flink | 추가 dependency |
|---|---|---|
| Kafka sink·SQL | 2.2.1 / Java 17 | flink-connector-kafka 5.0.0-2.2, connector-base와 필요한 SQL/runtime/format 모듈 |
| Dynamic Iceberg sink | 2.1.3 / Java 17 | iceberg-flink-runtime-2.1 1.11.0 |
공식 Iceberg 1.11.0 배포 목록은 Flink 2.1/2.0/1.20 runtime JAR를 제공합니다. 2.1용 JAR를 2.2.1에 넣고 검증된 조합으로 표시하지 않습니다. 아래 Java helper는 각각의 조합으로 컴파일했으며, 실행 시 source·보안·catalog·storage 설정을 별도로 준비합니다.
2. State backend와 checkpoint storage는 별개
| Backend | 특성 | 확인할 한계 |
|---|---|---|
| HashMap | Keyed state를 JVM heap 객체로 보관 | Heap·GC·serializer 비용; state 크기와 부하에 맞춰 측정 |
| EmbeddedRocksDB | Keyed state를 직렬화해 local RocksDB에 보관; native memory/cache와 disk 사용 | Disk뿐 아니라 managed/native memory·I/O·CPU도 필요 |
| ForSt | Remote filesystem의 SST와 local cache를 사용하는 disaggregated backend | 2.2에서 experimental; async-state API와 snapshot 제약 확인 |
RocksDB를 “slot당 정확히 한 인스턴스” 또는 “모든 operator state가 disk에 있으므로 heap이 state 크기와 무관하다”고 설명하지 않습니다. Keyed operator별 backend가 있을 수 있고, 같은 slot의 여러 인스턴스는 managed-memory budget/cache를 공유합니다. Operator state와 사용자 객체·timer·buffer 등도 메모리를 사용합니다.
특정 MB를 넘으면 무조건 RocksDB라는 기준 대신 state 형태·serializer·GC·I/O와 checkpoint/restore 시간을 비교합니다. ForSt도 incremental snapshot을 지원하므로 “증분은 RocksDB만 가능”이라고 일반화하지 않습니다. 이 장의 실습은 RocksDB입니다.
Incremental checkpoint가 줄이는 것
RocksDB의 새로운 SST 파일과 checkpoint metadata를 저장하고, 재사용 가능한 shared SST는 참조합니다. 논리적인 key 변경분을 직접 비교하는 방식이 아닙니다. Compaction이 SST를 다시 만들면 적은 논리 변경에도 업로드가 커질 수 있습니다.
Restore에는 선택한 checkpoint가 참조하는 모든 파일이 필요합니다. 모든 과거 checkpoint를 순서대로 재생하는 것은 아니며, full checkpoint도 항상 단일 파일은 아닙니다. Native SST 복원은 canonical key/value에서 RocksDB를 재구축하는 비용을 줄일 수 있지만 전송량·파일 수·network·I/O에 따라 더 빠르거나 느릴 수 있습니다. Active checkpoint가 참조하는 shared 파일을 S3 수명주기로 임의 삭제하지 않습니다.
3. S3 상태 보존 예제의 실제 전제
Part 2의 Operator와 data-processing namespace, chart가 생성한 Role/flink를 사용합니다. S3 버킷·prefix와 IAM role은 미리 준비하고 아래 예제 값을 실제 값으로 바꿉니다. 읽기·쓰기·list·정리/delete·multipart 처리와 필요 시 KMS 권한을 경로별로 확인합니다. SA annotation은 IAM role 생성이나 OIDC trust 구성을 대신하지 않습니다.
apiVersion: v1
kind: ServiceAccount
metadata:
  name: flink-state
  namespace: data-processing
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/flink-state-checkpoints
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: flink-state
  namespace: data-processing
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: flink
subjects:
- kind: ServiceAccount
  name: flink-state
  namespace: data-processing
다음은 IRSA를 사용하는 FlinkDeployment입니다. JM/TM 모두에 S3 plugin을 활성화하고 local RocksDB 공간은 emptyDir에 둡니다. Pod/node 손실 후 복구할 state는 S3에 있습니다. fsGroup은 이 image의 flink UID/GID 9999에 맞춘 예제입니다.
중요한 버전 제한이 있습니다. 검토한 2.2.1 S3 Hadoop plugin은 Hadoop 3.3.4와 AWS SDK for Java 1.12.779를 포함합니다. SDK 1.x는 2025-12-31 지원 종료 상태입니다. 아래는 그 artifact의 실제 v1 credential class에 맞춘 구성으로, 지원되는 v2 SDK로 검증된 구성이라는 뜻은 아닙니다. Production에서는 upstream filesystem plugin의 지원·보안 상태와 교체 가능한 runtime/connector 조합을 검토합니다. 서로 다른 SDK 세대의 JAR/class 이름만 바꾸어 classpath를 섞지 않습니다.
apiVersion: flink.apache.org/v1beta1
kind: FlinkDeployment
metadata:
  name: flink-state-demo
  namespace: data-processing
spec:
  image: flink:2.2.1-java17
  flinkVersion: v2_2
  mode: native
  flinkConfiguration:
    taskmanager.numberOfTaskSlots: '2'
    state.backend.type: rocksdb
    state.backend.rocksdb.localdir: /opt/flink/state
    execution.checkpointing.storage: filesystem
    execution.checkpointing.dir: s3://replace-with-your-bucket/flink-state-demo/checkpoints
    execution.checkpointing.savepoint-dir: s3://replace-with-your-bucket/flink-state-demo/savepoints
    execution.checkpointing.interval: 2 s
    execution.checkpointing.mode: EXACTLY_ONCE
    execution.checkpointing.timeout: 10 min
    execution.checkpointing.min-pause: 30 s
    execution.checkpointing.incremental: 'true'
    execution.checkpointing.num-retained: '3'
    execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
    high-availability.type: org.apache.flink.kubernetes.highavailability.KubernetesHaServicesFactory
    high-availability.storageDir: s3://replace-with-your-bucket/flink-state-demo/ha
    fs.s3a.aws.credentials.provider: com.amazonaws.auth.WebIdentityTokenCredentialsProvider
  serviceAccount: flink-state
  jobManager:
    resource:
      memory: 2048m
      cpu: 1
  taskManager:
    resource:
      memory: 2048m
      cpu: 1
  job:
    jarURI: local:///opt/flink/examples/streaming/StateMachineExample.jar
    parallelism: 2
    upgradeMode: last-state
    state: running
    args:
    - --backend
    - rocksdb
    - --checkpoint-dir
    - s3://replace-with-your-bucket/flink-state-demo/checkpoints
    - --incremental-checkpoints
    - 'true'
  podTemplate:
    spec:
      securityContext:
        fsGroup: 9999
      containers:
      - name: flink-main-container
        env:
        - name: ENABLE_BUILT_IN_PLUGINS
          value: flink-s3-fs-hadoop-2.2.1.jar
        volumeMounts:
        - name: rocksdb-local
          mountPath: /opt/flink/state
      volumes:
      - name: rocksdb-local
        emptyDir: {}
StateMachineExample은 코드에서 checkpoint interval을 2초로 설정합니다. 이 예제의 config도 그 값과 맞췄으며 min-pause=30초와 checkpoint 소요 시간 때문에 실제 주기가 2초마다 고정되는 것은 아닙니다. 60초를 config에 넣어도 application 코드의 명시적 설정이 덮어쓸 수 있으므로 실행 중 effective config를 확인합니다.
Pod Identity를 선택한다면 IRSA 설정 대신 해당 SA의 association·Agent와 network 경로를 준비하고, 이 v1 artifact에서는 com.amazonaws.auth.DefaultAWSCredentialsProviderChain 등 container credential을 포함하는 경로를 검증합니다. 1.12.779는 문서화된 Pod Identity 최소 버전 1.12.746 이상이지만 SDK 지원 종료 문제까지 없어지는 것은 아닙니다. 더 앞선 환경 변수·IRSA·다른 credential source가 선택되지 않는지도 확인합니다.
배포 후 Running 상태뿐 아니라 실제 완료된 checkpoint, S3 metadata/data 파일, 재시작 후 restore와 application 결과를 확인합니다. EmptyDir는 durable backup이 아닙니다. 이 검토에서는 실제 AWS 배포나 장애 복구를 실행하지 않았습니다.
4. Checkpoint와 savepoint의 수명
| 항목 | Checkpoint | Savepoint |
|---|---|---|
| 일반 목적 | 장애 복구를 위한 state/source 위치 | 계획된 복원·업그레이드·fork 지점 |
| Trigger | 주기 또는 명시적 요청 | 사용자·Operator 요청; 자동화로 주기 생성 가능 |
| 보존 | 개수·externalized retention·job 종료 정책에 따름 | 사용자/Operator 정책과 restore ownership에 따름 |
| 형식·저장소 | JobManager 또는 filesystem storage 등 | Canonical/native 형식과 접근 가능한 저장소 |
Savepoint가 영구적으로 자동 보존되는 것도, checkpoint가 항상 S3에 저장되는 것도 아닙니다. Canonical은 backend 간 이식성을 고려한 형식이며 native는 backend별 형식입니다. State schema·UID·serializer·max parallelism·버전 호환성은 별도로 검증합니다.
Restore의 CLAIM/NO_CLAIM은 snapshot 소유와 삭제 책임에 영향을 줍니다. RocksDB NO_CLAIM 복원 뒤 첫 checkpoint는 독립성을 확보하기 위해 full checkpoint가 될 수 있습니다. 참조 관계가 끊기기 전에 원본 snapshot을 지우지 않습니다. Operator last-state도 HA metadata나 마지막 checkpoint/savepoint 등 접근 가능한 상태를 사용하므로 “항상 마지막 checkpoint 하나만”으로 단순화하지 않습니다.
새 savepoint를 고유 CR로 요청
아래 generateName은 create 때 새 이름을 부여합니다. 같은 완료된 CR을 재사용해 과거 snapshot을 새 성공으로 오인하지 않도록 합니다.
apiVersion: flink.apache.org/v1beta1
kind: FlinkStateSnapshot
metadata:
  generateName: flink-state-before-upgrade-
  namespace: data-processing
spec:
  jobReference:
    kind: FlinkDeployment
    name: flink-state-demo
  savepoint:
    formatType: CANONICAL
disposeOnDelete: falsekubectl create -f savepoint.yaml
kubectl get flinkstatesnapshots -n data-processing --watch생성된 CR의 status.state=COMPLETED와 status.path를 확인합니다. FAILED/ABANDONED이면 error와 job 상태를 조사합니다. disposeOnDelete=false는 이 예제의 보존 선택이며, 기본 true 및 Operator snapshot 정리 정책과 다릅니다. 보존된 파일의 삭제 책임도 기록합니다.
5. Kafka exactly-once: checkpoint, transaction, consumer를 함께
KafkaSink의 EXACTLY_ONCE는 checkpoint 완료에 연동해 Kafka transaction을 commit합니다. 재생 가능한 source와 복구 가능한 state, 올바른 sink 설정이 필요하며 downstream은 read_committed로 읽어야 합니다. 모든 subtask·partition·다른 sink 시스템까지 하나의 전역 atomic transaction이 되는 것은 아닙니다. 한 Kafka transaction은 여러 topic/partition을 포함할 수 있지만, 여러 sink subtask의 서로 다른 transaction 전체를 Flink checkpoint 하나와 동일시하지 않습니다.
다음 helper는 Kafka connector 5.0.0-2.2와 Flink 2.2.1로 컴파일했습니다. Caller가 input stream, 실제 bootstrap 서버, TLS/SASL 등 producer 설정과 timeout을 제공하고 application에서 execute해야 합니다. 자체 완결된 Kafka cluster 설치 예제는 아닙니다.
import java.util.Properties;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.connector.base.DeliveryGuarantee;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.streaming.api.datastream.DataStream;

public final class KafkaExample {
    private KafkaExample() {}

    public static void attach(
            DataStream<String> input,
            String bootstrapServers,
            String transactionalIdPrefix,
            int transactionTimeoutMs,
            Properties securityProperties) {
        if (transactionTimeoutMs <= 0 || transactionalIdPrefix.isBlank()) {
            throw new IllegalArgumentException("Positive timeout and a unique stable prefix are required");
        }
        Properties producer = new Properties();
        producer.putAll(securityProperties);
        producer.setProperty("transaction.timeout.ms", Integer.toString(transactionTimeoutMs));
        input.getExecutionEnvironment().enableCheckpointing(60_000);

        KafkaSink<String> sink = KafkaSink.<String>builder()
                .setBootstrapServers(bootstrapServers)
                .setKafkaProducerConfig(producer)
                .setRecordSerializer(KafkaRecordSerializationSchema.<String>builder()
                        .setTopic("orders-enriched")
                        .setValueSerializationSchema(new SimpleStringSchema())
                        .build())
                .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
                .setTransactionalIdPrefix(transactionalIdPrefix)
                .build();
        input.sinkTo(sink).name("orders-enriched").uid("orders-enriched-sink");
    }
}
transactionalIdPrefix는 같은 Kafka cluster의 독립적인 동시 sink/job 사이에서 고유해야 하며 재시작 동안 안정적으로 유지합니다. 변경하면 이전 transaction이 제대로 중단되지 않아 timeout까지 read_committed 진행이 막힐 수 있습니다. Blue/green의 두 실행에 무조건 같은 prefix를 주면 fencing/충돌 위험이 있습니다.
5.0.0 builder의 기본 transaction timeout은 1시간입니다. Broker의 허용 최대값과 맞추고, 최대 checkpoint·재시작·복구 시간보다 충분히 길게 설계합니다. Transaction 만료 후에는 설정 문자열만으로 exactly-once를 복구할 수 없습니다.
60초 checkpoint interval은 “추가 지연 최대 60초”라는 상한이 아닙니다. 대기·checkpoint 소요 시간·commit·실패/재시도·consumer 지연이 합쳐집니다. 짧은 주기는 commit/metadata 부하를 늘립니다. 기본 INCREMENTING naming은 새 ID를 사용하지만, 선택 가능한 POOLING은 ID를 재사용하며 Kafka 3+·추가 topic read 권한· 정해진 migration 절차가 필요합니다. 모든 설정이 매번 새 ID를 무한히 만든다고 일반화하지 않습니다.
6. Dynamic Iceberg sink: 실제 API와 별도 runtime
Iceberg 1.11.0 / Flink 2.1.3용 helper입니다. Input RowData는 target_table STRING, id BIGINT, value STRING 순서이며, 예제는 insert-only입니다. CatalogLoader는 caller가 catalog·warehouse·인증을 구성해 제공합니다. 대상 table 이름은 신뢰 경계와 허용 목록으로 제한합니다.
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.table.data.GenericRowData;
import org.apache.flink.table.data.RowData;
import org.apache.iceberg.DistributionMode;
import org.apache.iceberg.PartitionSpec;
import org.apache.iceberg.Schema;
import org.apache.iceberg.catalog.TableIdentifier;
import org.apache.iceberg.flink.CatalogLoader;
import org.apache.iceberg.flink.sink.dynamic.DynamicIcebergSink;
import org.apache.iceberg.flink.sink.dynamic.DynamicRecord;
import org.apache.iceberg.types.Types;

public final class IcebergExample {
    private IcebergExample() {}
    private static final Schema PAYLOAD_SCHEMA = new Schema(
            Types.NestedField.required(1, "id", Types.LongType.get()),
            Types.NestedField.optional(2, "value", Types.StringType.get()));

    // Insert-only input RowData: target_table STRING, id BIGINT, value STRING.
    // The caller supplies an authenticated, authorized CatalogLoader.
    public static void attach(DataStream<RowData> input, CatalogLoader catalogLoader) {
        input.getExecutionEnvironment().enableCheckpointing(60_000);
        DynamicIcebergSink.forInput(input)
                .generator((row, out) -> {
                    TableIdentifier target = TableIdentifier.of("docs", row.getString(0).toString());
                    GenericRowData payload = GenericRowData.of(
                            row.getLong(1), row.isNullAt(2) ? null : row.getString(2));
                    out.collect(new DynamicRecord(
                            target, "main", PAYLOAD_SCHEMA, payload,
                            PartitionSpec.unpartitioned(), DistributionMode.HASH, 2));
                })
                .catalogLoader(catalogLoader)
                .uidPrefix("docs-dynamic-iceberg")
                .writeParallelism(2)
                .append();
    }
}
실제 API는 forInput → generator → catalogLoader → append입니다. Generator는 record를 return하는 대신 Collector에 0개 이상을 보냅니다. 기존 forRecords/withTableIdentifierSelector/withSchemaEvolutionEnabled 예제는 이 릴리스에 없는 API였습니다.
각 DynamicRecord에 target·schema·RowData·partition spec 등을 제공합니다. Schema evolution은 허용되는 변경과 설정에 따르며 arbitrary rename/type 변경을 자동 해결하지 않습니다. CDC update/delete에는 RowKind, equality fields, upsert와 table-format 지원을 검증해야 합니다. 이 insert-only helper를 그대로 CDC 처리기로 쓰지 않습니다. 여러 table의 commit이나 Kafka와 Iceberg 동시 출력도 전역 atomic commit이 아닙니다.
단순 적재에는 MSK → Firehose → S3 Tables/Iceberg 또는 MSK Connect sink도 검토할 수 있습니다. 지원 source/network·인증·catalog/table format·row operation·key·buffering과 실패 처리 조건을 확인합니다. 예를 들어 Firehose Iceberg는 문서화된 V2/Parquet/MOR 조건이 있습니다. 관리형이라는 이유로 구성·schema·전달 의미 검증이 없어지지는 않습니다.
7. SQL, time attribute와 늦은 데이터
SQL/Table API는 관계형 변환·집계를 선언적으로 표현하고, DataStream은 사용자 state· timer·operator 로직을 표현합니다. SQL도 고급 기능을 제공하며 DataStream이라고 checkpoint barrier나 backpressure를 임의로 우회할 수 있는 것은 아닙니다. 2.x의 공개 API 지원과 connector/format JAR을 확인합니다. Kafka/Iceberg/JDBC가 항상 기본 배포판에 모두 들어 있거나 모든 Scala API가 유지된다고 가정하지 않습니다.
아래는 watermark가 있는 table 정의까지 포함한 planning 예제입니다. 실행 전 broker·보안 설정과 JSON 필드/시간 인코딩을 실제 source에 맞춥니다.
-- Schema/planning example. Supply real broker/authentication settings before execution.
CREATE TEMPORARY TABLE orders (
  customer_id STRING,
  amount DECIMAL(12,2),
  event_time TIMESTAMP(3),
  WATERMARK FOR event_time AS event_time - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'orders',
  'properties.bootstrap.servers' = 'kafka.example.invalid:9093',
  'properties.group.id' = 'docs-orders',
  'scan.startup.mode' = 'earliest-offset',
  'format' = 'json'
);

SELECT window_start, window_end, customer_id, SUM(amount) AS total_amount
FROM TABLE(TUMBLE(TABLE orders, DESCRIPTOR(event_time), INTERVAL '1' MINUTE))
GROUP BY window_start, window_end, customer_id;
Flink 2.2.1 플래너에서 이 쿼리가 계획되는 것과, watermark 없는 일반 TIMESTAMP 컬럼으로 바꾸면 time attribute 오류로 거부되는 것을 확인했습니다. 실제 Kafka 데이터를 읽거나 window 결과를 실행한 검증은 아닙니다.
Watermark는 event-time 진행 추정치이며 오래된 이벤트가 절대로 오지 않는다는 보장이 아닙니다. 모든 record에 event timestamp가 자동으로 존재하지도 않습니다. Timestamp 추출·watermark 전략과 partition별 idleness를 구성합니다. 느린/유휴 input이 진행을 막을 수 있고, 다시 활성화된 input은 늦은 데이터를 낼 수 있습니다.
- Tumbling: 고정 크기의 겹치지 않는 window.
- Sliding: 고정 크기와 slide 간격의 window; slide가 작으면 겹칩니다.
- Session: event-time gap과 watermark 진행으로 묶이며 단순 wall-clock idle timer와 다릅니다.
DataStream window의 allowedLateness>0이면 state가 유지되는 동안 늦은 record로 window가 다시 계산/발행될 수 있습니다. Cleanup 이후 늦은 데이터는 버려지거나 명시적으로 구성한 late-data side output으로 갑니다. allowedLateness만 설정한다고 side output이 자동 생성되지 않습니다. SQL window의 late-data 동작을 같은 DataStream 옵션으로 일반화하지 않습니다.
검증 범위
서로 다른 두 runtime 조합의 Java helper를 release 17 대상으로 컴파일했습니다. SQL 플래너의 정상/누락-watermark 두 경우, S3 plugin archive의 v1 credential class, CRD/YAML 구조와 릴리스 소스를 확인했습니다. 로컬 Java 도구는 Corretto 21이었으며 Java 17 cluster의 실제 실행·AWS/Kafka/Iceberg 연결·CDC·장애 복구 시험은 하지 않았습니다.
참고 자료
- Flink 2.2 state backends
- Checkpoint configuration
- Savepoints and ownership
- S3 filesystem plugins
- S3 plugin dependencies
- Bundled StateMachineExample
- Operator snapshots
- Kafka connector 5.0.0 sink
- Kafka transaction naming
- Iceberg release/runtime matrix
- Iceberg 1.11 DynamicIcebergSink
- Windows and late data
- Watermarks and idleness
- EKS Pod Identity SDK requirements
- AWS SDK for Java 1.x support status
- Firehose Iceberg prerequisites