Part 2: Kubeflow Pipelines
지원 버전: Kubeflow Pipelines 2.16.1, Kubeflow Community Distribution 26.03.1 최신 독립 릴리스 확인: KFP 2.17.2 (2026년 9월 4일; PyPI
kfpSDK 최신은 2.17.0), 2026년 10월 12일 확인; 예제는 2.16.1 기준 마지막 업데이트: 2026년 10월 12일
실습 환경 준비
로컬 컴파일에는 Python과 kfp==2.16.1이 필요합니다. 이 장은 Python 3.12로 검증했습니다. upstream KFP 2.17.2가 공개됐지만(PyPI의 최신 kfp SDK 패키지는 2.17.0), 이 pin은 Community Distribution 26.03.1과 맞춘 재현 기준입니다. 새 SDK/backend 조합을 검증한 것은 아닙니다.
컴파일은 클러스터에 접속하지 않습니다. 원격 실행에는 호환되는 KFP 백엔드, 인증된 클라이언트와 네임스페이스 권한이 필요합니다. S3를 사용한다면 실제 실행 ServiceAccount와 아티팩트 접근 컴포넌트의 AWS 신원도 구성해야 합니다.
Kubeflow Pipelines란
KFP는 타입이 있는 파라미터·아티팩트로 컴포넌트를 연결하고 실행 이력을 관리합니다. 이 장의 오픈소스 KFP 2.16.1 백엔드는 IR을 Argo Workflow로 변환합니다. Argo 컨트롤러가 실행 순서와 Pod 생성을 관리하고 Kubernetes 스케줄러가 Pod를 노드에 배치합니다. 캐시 적중, importer, 중첩 DAG 같은 경우를 포함하면 모든 논리적 태스크가 별도 사용자 컨테이너 실행과 일대일로 대응하지는 않습니다.
KFP v2 아키텍처: IR YAML과 백엔드 실행
Community Distribution 26.03.1은 KFP 2.16.1을 포함합니다. 레거시 v1의 기본 컴파일 경로는 Argo Workflow YAML을 만들었고, v2의 Compiler().compile(...)은 PipelineSpec 기반 IR YAML을 만듭니다. 파이프라인 업로드·저장과 Run 생성은 별도이며, 업로드만으로 실행되지는 않습니다.
IR은 Argo 객체를 직접 작성하는 부담을 줄이지만 모든 백엔드로의 무조건적인 이식성을 보장하지 않습니다. IR·SDK 버전, 지원 기능, Kubernetes 플랫폼 확장과 인증·저장소 설정이 대상 백엔드와 맞아야 합니다. kfp 패키지는 컴파일뿐 아니라 클라이언트 API와 Python 컴포넌트 실행 지원 코드도 제공합니다.
핵심 개념
| 개념 | 역할과 범위 |
|---|---|
| Pipeline | @dsl.pipeline으로 정의하는 그래프. 업로드된 정의·버전과 실행은 별도 |
| Component / Task | 재사용할 컴포넌트 정의와 그래프 안의 호출. lightweight Python 외에도 container/importer/graph 형식이 있음 |
| Run / Experiment | 입력을 가진 실행과 관련 실행의 그룹. Katib Experiment CRD와는 다름 |
| Parameter | 문자열·수치·작은 구조화 값 등의 입력·출력 |
| Artifact | URI, 타입, 메타데이터를 가진 Dataset/Model/Metrics 등의 객체. 모두 단일 파일이라는 뜻은 아님 |
| MLMD | 등록된 실행·아티팩트·연결 관계를 저장. 모든 외부 부작용이나 파일 무결성을 자동 기록하지는 않음 |
MLMD 기록과 실제 아티팩트 바이트는 구분됩니다. 코드·이미지·데이터 리비전과 해시를 함께 기록해야 재현성과 내용 검증의 근거가 됩니다.
파이프라인 실행이 시스템을 거치는 흐름
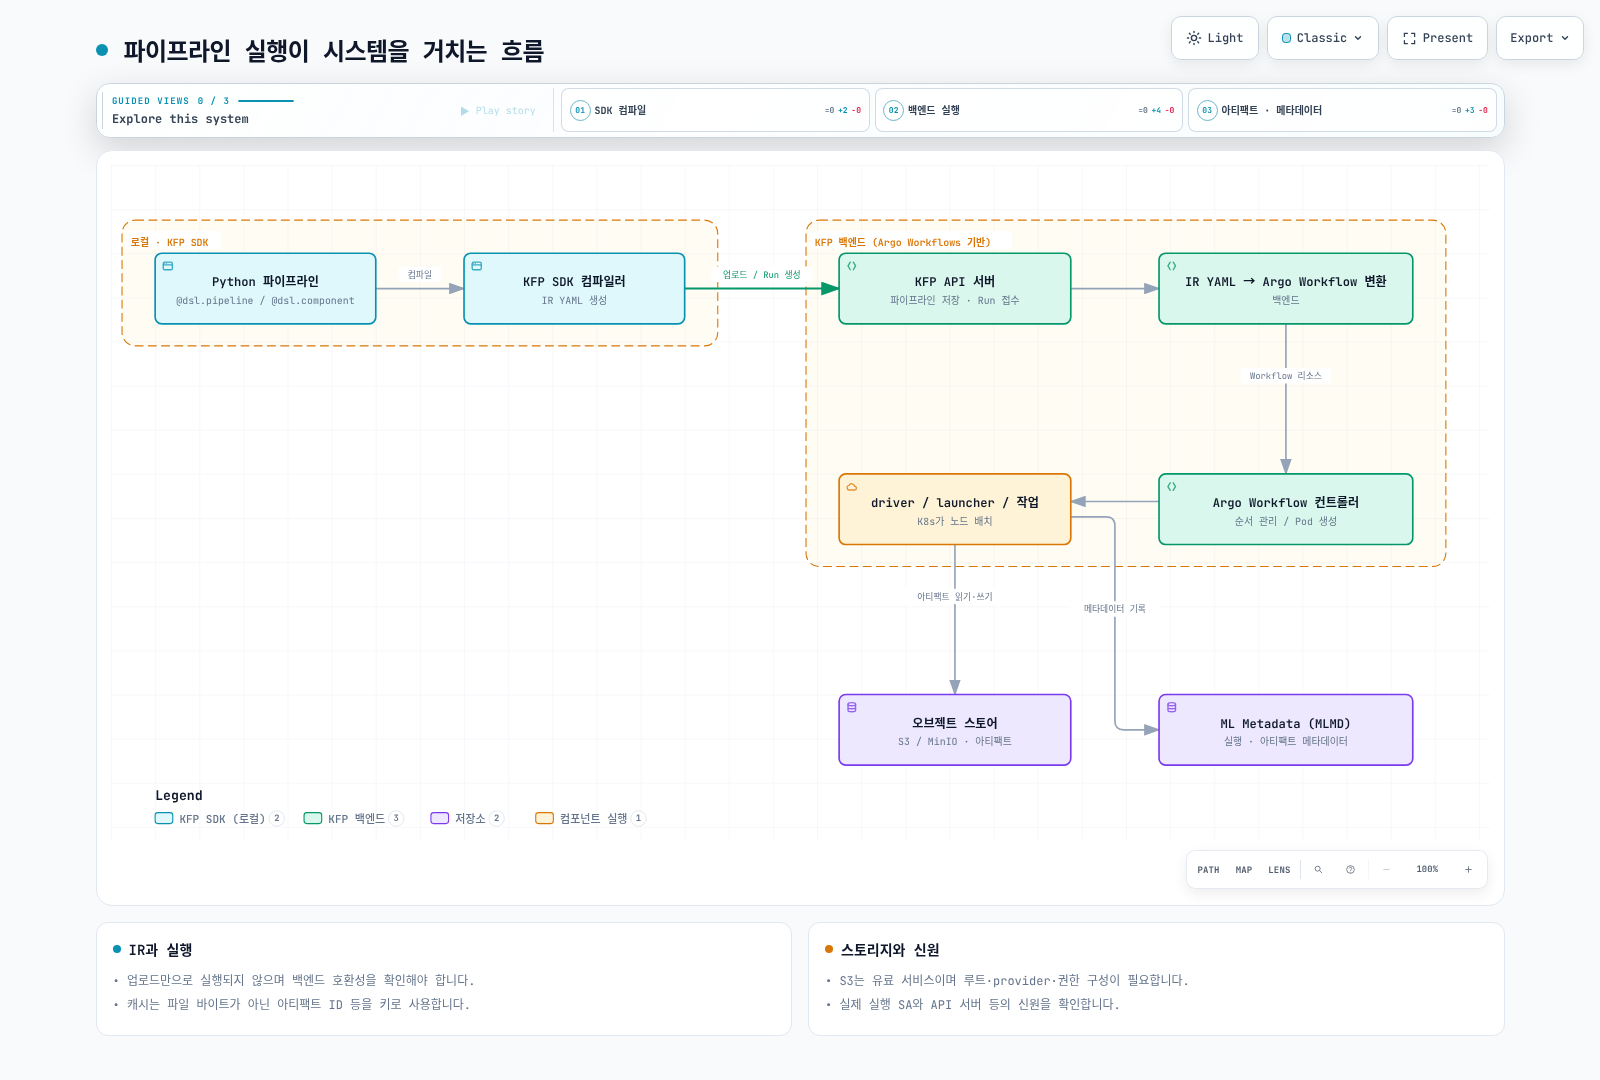
컴파일은 로컬에서 끝나지만 Run 생성 후에는 API 서버, Argo, KFP driver/launcher, 사용자 컨테이너가 협력합니다. launcher/runtime은 아티팩트 경로와 전송을 처리하고 메타데이터를 기록합니다. Kubernetes 스케줄러의 노드 배치는 Argo의 워크플로 순서 관리와 구분됩니다.
EKS에서의 아티팩트 저장소
검토한 배포판의 기본 설치에는 MinIO가 포함되지만, 모든 KFP 배포나 아티팩트 URI가 MinIO를 사용하는 것은 아닙니다. 파이프라인 루트, import된 URI, 저장소 provider 설정을 확인하세요. Metrics 등 메타데이터 중심 아티팩트를 모두 메트릭 파일로 설명해서도 안 됩니다.
S3를 사용하려면 현재 오브젝트 저장소 가이드에 맞게 pipeline_root, provider와 자격 증명 체인을 구성해야 합니다. S3는 저장·요청·전송 등에 요금이 발생하는 서비스이며 무료 기본 저장소가 아닙니다.
pipeline-runner라는 ServiceAccount가 모든 환경의 실행 계정인 것은 아닙니다. Run에 선택된 ServiceAccount와 실제 Pod를 확인하고, 저장소에 접근하는 API 서버·launcher 등의 권한도 검토하세요. IRSA는 현재 가이드에 문서화되어 있습니다. Pod Identity는 실제 SDK, 에이전트, association과 실행 환경의 지원을 검증해야 하며, 이 장에서는 AWS 연동을 실행하지 않았습니다. Part 1은 이 경계와 기존 AWS 배포판의 설치 제약을 설명합니다.
간단한 2단계 파이프라인
다음은 KFP v2 SDK의 데코레이터를 사용한 최소한의 data-prep -> train 파이프라인 예시로, 첫 번째 컴포넌트에서 두 번째 컴포넌트로 타입이 지정된 Dataset 아티팩트가 전달되는 과정을 보여줍니다.
from kfp import dsl, compiler
from kfp.dsl import Dataset, Model, Output, Input

@dsl.component(base_image="python:3.12-slim", packages_to_install=["pandas==2.3.3"])
def prepare_data(output_dataset: Output[Dataset]):
    import pandas as pd

    # 실제 파이프라인에서는 S3 등 외부 소스에서 데이터를 읽어옵니다
    df = pd.DataFrame({"feature": [1, 2, 3, 4], "label": [0, 1, 0, 1]})
    df.to_csv(output_dataset.path, index=False)

@dsl.component(base_image="python:3.12-slim", packages_to_install=["scikit-learn==1.7.2", "pandas==2.3.3"])
def train_model(input_dataset: Input[Dataset], output_model: Output[Model]):
    import pandas as pd
    from sklearn.linear_model import LogisticRegression
    import pickle

    df = pd.read_csv(input_dataset.path)
    clf = LogisticRegression().fit(df[["feature"]], df["label"])
    with open(output_model.path, "wb") as f:
        pickle.dump(clf, f)

@dsl.pipeline(name="data-prep-train-pipeline")
def data_prep_train_pipeline():
    prep_task = prepare_data()
    train_task = train_model(input_dataset=prep_task.outputs["output_dataset"])

compiler.Compiler().compile(
    pipeline_func=data_prep_train_pipeline,
    package_path="data_prep_train_pipeline.yaml",
)Output[Dataset]에서 Input[Dataset]으로 연결하면 그래프 의존성과 아티팩트 타입이 기록됩니다. 실제 .path 준비와 전송은 실행 환경의 역할입니다. 컴파일만으로 저장소나 학습이 검증되지는 않습니다.
이 코드는 lightweight Python 컴포넌트입니다. @dsl.component가 이미지를 자동 빌드하지 않으며, 함수 코드를 추출하고 지정한 base image에서 packages_to_install을 실행 시 설치합니다. 예전 예제는 prepare_data의 pandas 의존성을 누락했습니다. 두 컴포넌트에 필요한 패키지를 명시했고 로컬에서 함수 본문을 확인했습니다. 운영에서는 의존성을 미리 설치한 컨테이너와 이미지 digest를 사용하고 컨테이너 실행도 별도로 검증하세요. 이 예제의 Python 이미지 태그와 전이 의존성은 완전히 고정된 빌드가 아닙니다.
생성된 pickle은 같은 실습에서 만든 신뢰할 수 있는 파일만 읽으세요. 외부 pickle 로드는 임의 코드 실행 위험이 있습니다. 작은 데이터로 만든 모델은 API 예제이며 모델 품질 검증 결과가 아닙니다.
캐싱 동작
2.16.1의 캐시 키에는 입력 파라미터 값, 입력 아티팩트의 이름/ID, 출력 스펙, 컨테이너 이미지 문자열, 명령·인자, PVC 이름 등이 포함됩니다. 파이프라인 이름과 네임스페이스로 캐시 조회를 제한합니다. 입력 아티팩트의 파일 바이트를 매번 읽어 해시하는 방식이 아닙니다.
같은 아티팩트 ID가 가리키는 파일, 이미지 태그, 외부 DB나 API가 바뀌어도 변경이 키에 반영되지 않으면 기존 결과가 재사용될 수 있습니다. 캐시된 메타데이터가 존재해도 실제 오브젝트를 지웠다면 downstream 읽기가 실패할 수 있습니다. 입력 데이터 버전·해시를 명시적 파라미터로 전달하고 변경 가능한 외부 상태나 부작용을 가진 태스크는 캐싱을 끄는 방법을 고려하세요.
# 파이프라인 함수 안에서 특정 태스크의 캐싱 비활성화
prep_task.set_caching_options(enable_caching=False)
인증된 클라이언트의 create_run_from_pipeline_package(..., enable_caching=False)는 Run의 전체 태스크 설정을 덮어씁니다. None은 컴파일된 태스크 설정을 유지합니다. 컴파일 기본값을 바꾸는 CLI 옵션과 KFP_DISABLE_EXECUTION_CACHING_BY_DEFAULT도 있지만, 환경 변수는 KFP를 import하기 전에 설정해야 합니다.
검증과 근거
Python 3.12 / KFP 2.16.1로 IR을 컴파일하고 의존성, 타입, 캐싱 설정을 검사했습니다. pandas 2.3.3 / scikit-learn 1.7.2로 함수 본문을 로컬 CPU에서 실행했습니다. Docker, Argo, 클러스터 캐시, S3, Pod Identity 실행을 검증한 것은 아닙니다.
다음 단계
파이프라인을 작성하고 컴파일해서 실행할 수 있게 되었다면, 다음 질문은 보통 이 파이프라인 컴포넌트에 들어가는 코드를 애초에 어디서 개발하느냐입니다. Part 3: Kubeflow Notebooks에서는 팀이 파이프라인 컴포넌트로 패키징할 코드를 작성하고 반복 개발하는 데 쓰는 사용자별 노트북 환경을 다룹니다. 그리고 이 시리즈 뒷부분의 Part 6: KServe — Kubernetes 기반 모델 서빙에서는 그 파이프라인이 최종적으로 만들어낸 모델을 서빙하는 방법을 다룹니다.
퀴즈
이 장에서 배운 내용을 확인하려면 주제 퀴즈를 풀어보세요.