Part 6: KServe — Kubernetes 위에서의 모델 서빙
검토 기준: KServe 0.18.0 / Models Web Application 0.18.0 / Community Distribution 26.03.1 마지막 업데이트: 2026년 10월 12일
실습 환경 준비
선택한 KServe 릴리스와 호환되는 Kubernetes, 컨트롤러·CRD, ServingRuntime, 저장소 접근과 인증된 네트워크 경로가 필요합니다. 전체 Kubeflow는 필수가 아니며 웹앱은 선택적 UI입니다. Knative 모드는 Knative Serving과 networking 계층, Standard의 KEDA 경로는 KEDA와 메트릭 provider가 필요합니다. GPU도 워크로드에 따라 선택합니다.
KServe와 Kubeflow의 관계
KServe는 KFServing에서 발전한 독립 서빙 프로젝트입니다. 이 장은 Community Distribution 26.03.1에 포함된 KServe와 Models Web Application 0.18.0을 기준으로 검토했습니다.
2026년 10월 12일 기준 확인한 최신 KServe 공개 릴리스는 **0.21.0(2026년 9월 25일)**입니다. 0.20.0(2026년 8월 6일)이 그보다 앞서 공개됐습니다. 두 릴리스 모두 배포판의 0.18.0 기준과 다릅니다.
컨트롤러·CRD·웹앱은 별도 산출물이므로 호환성을 확인해야 합니다. 숫자가 항상 같아야 하는 것도, 반드시 달라야 하는 것도 아닙니다. 실제 이미지·CRD 스키마·웹앱 리비전을 기록하세요.
InferenceService는 이 장에서 다루는 서빙 API입니다. KServe 전체가 이 객체 하나만으로 구성되는 것은 아닙니다. ServingRuntime/ClusterServingRuntime, ModelMesh 경로와 별도 LLMInferenceService API 등은 서로 다른 의존성과 운영 모델을 가집니다.
InferenceService: Predictor, Transformer, Explainer
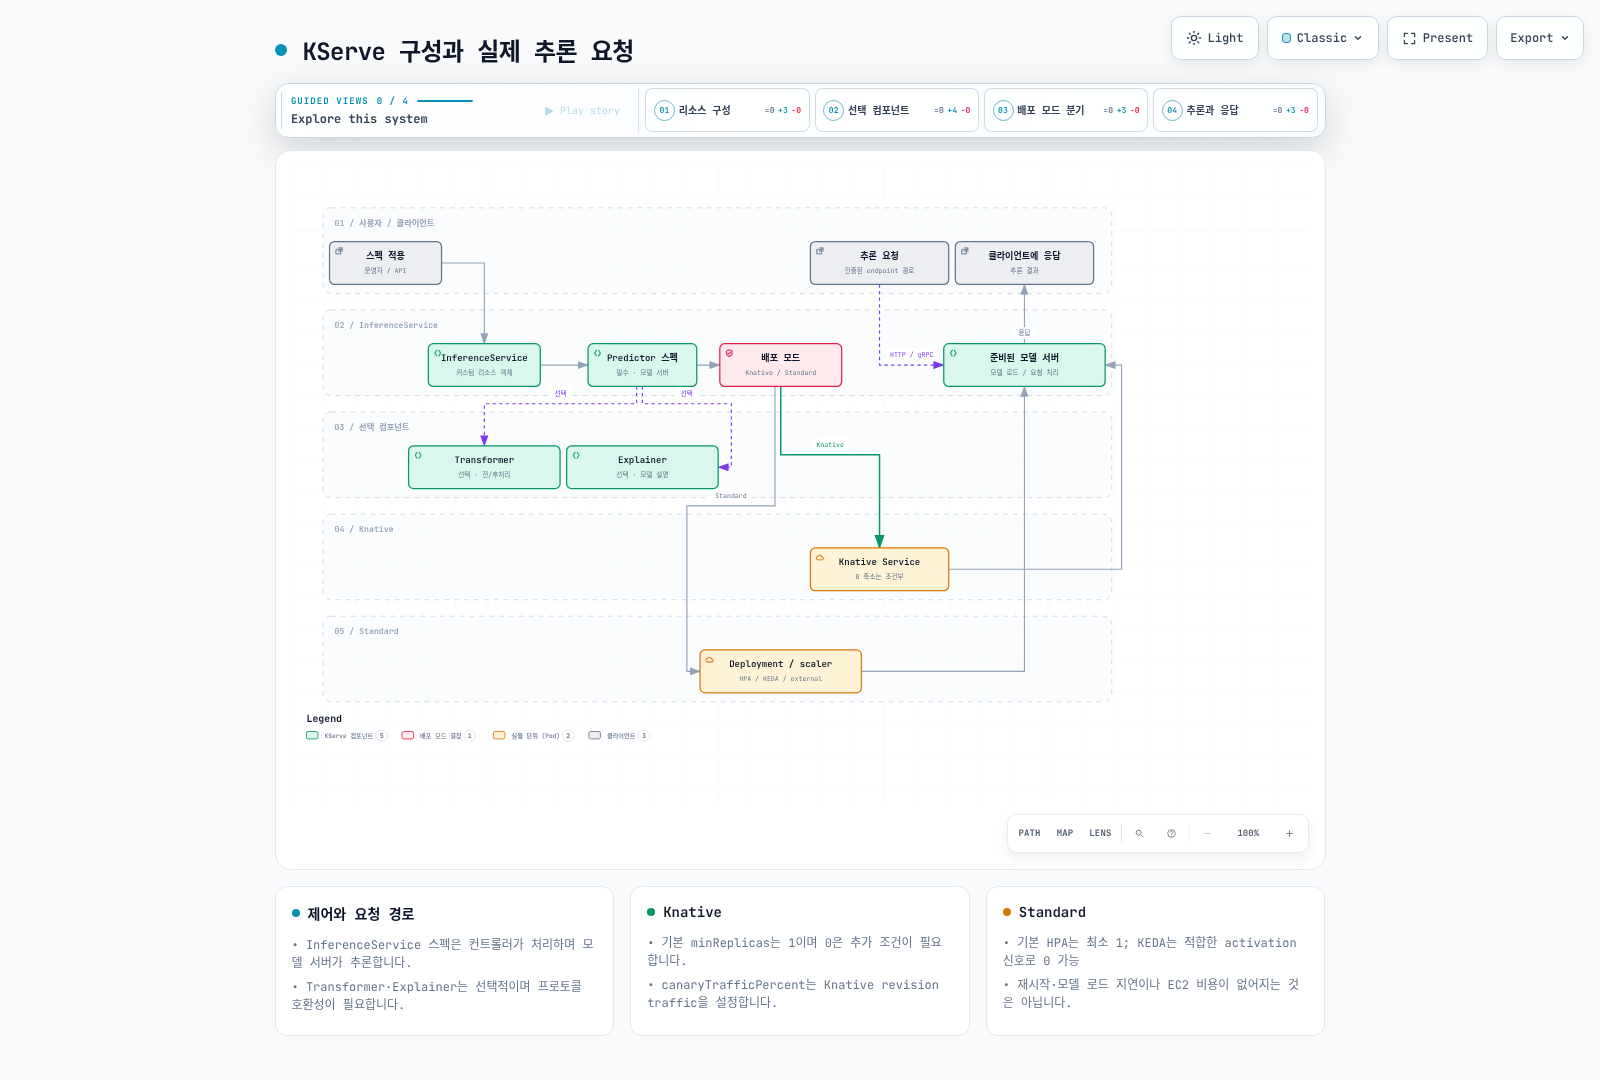
InferenceService는 필수 predictor와 선택적 transformer·explainer를 가집니다. Predictor는 실제 모델 서버를 구성하고 transformer는 전·후처리, explainer는 설명 요청을 처리합니다. explainer가 모든 예측에 자동으로 덧붙는 것은 아니며, 선택한 runtime과 프로토콜이 해당 동작을 지원해야 합니다.
modelFormat, 선택한 ServingRuntime, 모델 파일 구조·라이브러리 버전, URI·자격 증명, 포트·프로브와 요청 프로토콜이 맞아야 합니다. URI만 지정한다고 어떤 모델이든 바로 서빙되는 것은 아닙니다. 커스텀 컨테이너도 실제 클라이언트 계약과 KServe 라우팅·상태 검사 조건을 맞춰야 합니다.
공식 runtime-config 차트는 기본 설정에서 리소스를 생성하지 않았습니다. kserve.servingruntime.enabled=true로 렌더링하면 ClusterServingRuntime 12개가 생성됩니다. 목록에 있다는 사실만으로 이미지의 최신성·보안 지원이나 모델 호환성이 검증되는 것은 아닙니다.
TorchServe는 프로젝트 공지에 신규 기능·버그 수정·보안 패치를 계획하지 않는다고 명시되어 있습니다. 기존 KServe runtime 목록에 남아 있어도 신규 운영의 유지보수되는 기본 선택으로 소개해서는 안 됩니다. 모델 형식과 GPU 요구에 맞는 현재 유지보수 runtime을 별도로 검증하세요.
배포 모드: Knative와 Standard
0.18.0의 이름은 Knative와 Standard입니다. Serverless와 RawDeployment annotation 값은 deprecated 별칭이며 각각 새 이름으로 정규화됩니다. serving.kserve.io/deploymentMode와 설치된 inferenceservice-config를 확인하세요. 코드의 fallback은 Standard이지만 이번에 내려받은 OCI 리소스 차트의 기본 설정은 Knative였습니다. 이름만으로 실제 설치 기본값을 추정하지 마세요.
| 항목 | Knative | Standard |
|---|---|---|
| 실행 리소스 | Knative Service·Revision을 통한 실행 | Deployment·Service와 선택한 autoscaler |
| 축소 | KPA와 관련 정책, minReplicas=0 등 조건을 충족하면 0 가능 | 기본 HPA 경로는 최소 1; KEDA 경로는 적합한 외부 activation 신호로 0 구성 가능 |
| 기본 minReplicas | KServe 기본 1. Knative 선택만으로 0이 되지 않음 | HPA는 0을 지정해도 최소 1로 보정 |
| 의존성 | Knative Serving·networking·선택 autoscaler | 선택한 ingress/gateway, HPA metrics 또는 KEDA 등 |
| 지연 | 0에서 시작하면 스케줄링·이미지·모델 로드 지연 | 웜 replica를 유지해도 재시작·롤아웃·확장 때 시작 지연 가능 |
두 모드 모두 가용 replica 수나 지연 SLA를 자동 보장하지 않습니다. 모델 로드 시간, readiness, 용량, timeout과 실패 복구를 검증하세요. KEDA로 0을 구성할 때는 Pod가 없어도 관측 가능한 신호와 재활성화 경로가 필요하며, CPU·메모리 신호만으로 요청을 받아 자동 활성화한다고 가정하면 안 됩니다.
오토스케일링과 메트릭
Knative의 KPA는 동시성/RPS 기반 동작을 제공하지만 Knative HPA class도 별도 경로입니다. Standard는 serving.kserve.io/autoscalerClass에 따라 hpa, keda, external/none 경로를 선택할 수 있습니다. 모든 Standard 배포가 HPA를 자동 생성하는 것은 아닙니다.
HPA/KEDA가 CPU, 외부 메트릭, 지원되는 Pod 메트릭을 관측하려면 metrics-server·adapter·provider 같은 실제 의존성이 필요합니다. GPU 메트릭은 GPU 요청에서 자동 생성되지 않습니다. 신호별 응답 속도는 관측 주기·안정화 설정·모델 특성에 따라 달라지므로 동시성 신호가 언제나 더 빠르다고 단정할 수 없습니다.
점진적 모델 업데이트와 캐너리
이 버전의 canaryTrafficPercent는 Knative Revision 트래픽 분할 경로에서 확인했습니다. KServe는 마지막 rollout revision과 새 revision을 Knative Service traffic 대상으로 설정하며 실제 요청 분배는 Knative의 networking 계층이 처리합니다. KServe 컨트롤러 자체가 모든 추론 요청을 중계하는 것은 아닙니다.
Standard Deployment의 rolling update를 동일한 revision 퍼센트 라우팅으로 해석하지 마세요. 그 모드에서 가중치 라우팅이 필요하면 별도 서비스·gateway/mesh 또는 rollout 도구와 소유권을 설계해야 합니다. Istio 트래픽 관리와 Argo Rollouts를 사용할 때도 KServe가 관리하는 객체와 충돌하지 않도록 해야 합니다.
비율만으로 품질 검증이나 자동 승격·롤백이 보장되지 않습니다. 비교 메트릭, 오류율·지연, 이전 revision과 모델 아티팩트 보존, route readiness를 확인하세요.
EKS에서의 GPU 추론
Pod의 nvidia.com/gpu 요청은 스케줄링·장치 할당 조건입니다. 실제 GPU 추론에는 CUDA/드라이버·서버 이미지·모델 backend·device 설정이 맞아야 합니다. Triton model configuration이나 프레임워크의 장치 선택 등도 검토해야 하며 GPU 요청만으로 CPU 모델이 GPU로 자동 전환되지는 않습니다.
Karpenter는 적합한 Pending Pod, NodePool, 할당량과 가용 용량 조건에서 노드를 공급할 수 있습니다. KServe/Knative/HPA/KEDA의 Pod 수 결정과 EC2 노드 공급·회수는 별도 제어 루프입니다. Pod가 0이 되어도 다른 워크로드나 중단 정책 때문에 노드와 비용이 남을 수 있습니다.
검증과 근거
공식 0.18.0 OCI의 CRD·리소스·runtime-config 차트를 내려받아 로컬 렌더링하고 schema/config를 확인했습니다. 컨트롤러의 모드 별칭, HPA 최소값, KEDA ScaledObject, Knative 트래픽 분할 코드를 검토했습니다. 모델 다운로드·서빙·GPU·클러스터 autoscaling이나 실제 캐너리 요청은 실행하지 않았습니다.
- 0.18.0 모드 이름과 기본값
- HPA 최소 replica 처리
- KEDA ScaledObject 처리
- Knative traffic 처리
- 0.20.0 릴리스
- 0.21.0 릴리스 (확인한 최신)
다음 단계
Kubeflow 시리즈의 아키텍처·Pipelines·Notebooks·Katib·Trainer와 연결하되, 모델 아티팩트 배포와 검증은 별도 단계로 관리하세요.
퀴즈
이 장에서 배운 내용을 확인하려면 주제 퀴즈를 풀어보세요.