Part 2: Helm 배포와 Executor 선택
검토 기준: chart 1.22.0 / Airflow 3.3.1 / KEDA 2.20 최신 upstream patch 확인: Airflow 3.3.2; chart 예제는 3.3.1 기준 · 2026년 10월 12일
1. Chart와 실제 기본값
이 문서는 Apache Airflow 저장소의 공식 chart를 사용합니다. 저장소 alias를 apache-airflow로 등록하므로 Helm 명령의 chart 이름은 apache-airflow/airflow입니다. airflow-helm/charts 같은 별도 커뮤니티 chart의 values를 혼용하지 않습니다. 두 가지 외에 다른 chart가 전혀 없다는 뜻은 아닙니다.
Chart 1.22.0은 기본적으로 Airflow 3.2.2 + CeleryExecutor를 선택합니다. 기본 KubernetesExecutor 설치라는 기존 설명은 잘못되었습니다. 아래에서는 image tag와 airflowVersion을 3.3.1로 맞추고 executor를 명시합니다. 두 필드나 digest override가 실제 이미지와 어긋나면 chart의 버전별 설정도 달라질 수 있습니다.
Helm 3.19.0 이상을 사용합니다. Chart의 현재 릴리스 변경 기록은 이 최소값을 명시하지만 일부 패키지 README에는 오래된 Helm 3.0+ 문구가 남아 있습니다. Kubernetes 요구와 별개로 Airflow 3.3.1의 테스트 목록은 1.30–1.35입니다. Chart 1.16.0 README는 1.29+였으므로 “1.16부터 1.30+”라는 이력도 정정합니다. Chart.yaml이 모든 최소 버전을 강제하여 반드시 설치를 거부한다고 가정하지 않습니다. 실제 1.29 대상으로도 템플릿은 렌더링됐지만 지원을 증명하지는 않습니다.
2. 설치 전 연결과 Secret 준비
실습은 기존 namespace 권한, 준비된 외부 PostgreSQL, EKS 네트워크·용량을 전제로 합니다. DB schema/user와 migration 권한, 연결 URI·TLS·백업/보존 정책을 확인합니다. KEDA는 Celery scaling을 사용할 때만 필요합니다.
다음 값은 Helm values에 비밀번호를 넣는 대신 기존 Secret을 참조합니다. DB URI는 보호된 파일에 한 줄로 저장하고, password 등의 예약 문자는 URI 규칙에 맞게 인코딩합니다. RDS 등은 검증되는 TLS 연결을 사용합니다. sslrootcert 경로를 지정한다면 실제 DB client container에서 읽을 수 있어야 합니다. KEDA도 DB client 이므로 CA 파일·DNS·네트워크·DB 접근을 Airflow Pod에만 준비하면 충분하지 않습니다. Chart가 CA를 KEDA에 자동 복사하지 않습니다.
아래는 최초 설치용입니다. 이미 존재하는 Secret은 덮어쓰지 않으며 일반 upgrade 때 Fernet/API/JWT key를 새로 생성하지 않습니다. 백업·회전은 별도의 절차로 관리합니다.
set -euo pipefail
# Fresh installation only. Keep existing Fernet/API/JWT keys during an ordinary upgrade.
# AIRFLOW_DB_URI_FILE contains the tested, single-line PostgreSQL URI; do not commit it.
: "${AIRFLOW_DB_URI_FILE:?Set the path to your protected database connection file}"
kubectl create namespace airflow --dry-run=client -o yaml | kubectl apply -f -
kubectl -n airflow create secret generic airflow-metadata \
  --from-file="connection=$AIRFLOW_DB_URI_FILE"

umask 077
AIRFLOW_SECRET_TMP_DIR="$(mktemp -d)"
trap 'rm -rf "$AIRFLOW_SECRET_TMP_DIR"' EXIT
python3 - "$AIRFLOW_SECRET_TMP_DIR" <<'PY'
import base64
from pathlib import Path
import secrets
import sys
folder = Path(sys.argv[1])
(folder / "fernet-key").write_text(base64.urlsafe_b64encode(secrets.token_bytes(32)).decode())
(folder / "api-secret-key").write_text(secrets.token_urlsafe(48))
(folder / "jwt-secret").write_text(secrets.token_urlsafe(48))
PY
kubectl -n airflow create secret generic airflow-fernet \
  --from-file="fernet-key=$AIRFLOW_SECRET_TMP_DIR/fernet-key"
kubectl -n airflow create secret generic airflow-api-secret \
  --from-file="api-secret-key=$AIRFLOW_SECRET_TMP_DIR/api-secret-key"
kubectl -n airflow create secret generic airflow-jwt \
  --from-file="jwt-secret=$AIRFLOW_SECRET_TMP_DIR/jwt-secret"
metadataSecretName이 있으면 metadataConnection은 연결 정보의 우선 출처가 아닙니다. PostgreSQL을 비활성화하는 것만으로 외부 DB 주소·인증이 구성되지 않습니다. URI를 Airflow와 KEDA가 함께 사용하는 PostgreSQL profile에서는 양쪽이 해석할 수 있는 postgresql:// 형식을 확인합니다. SQLAlchemy 전용 +driver scheme을 그대로 KEDA에 전달하면 호환되지 않을 수 있습니다.
3. 명시적인 KubernetesExecutor 설치
kubernetes-values.yaml로 저장합니다. Triggerer persistence를 끈 실습 profile이므로 임시 로컬 로그를 영속 로그로 간주하지 않습니다. DAG 전달은 Part 3, 원격 로그·운영 저장은 Part 5에서 준비하며 production 전 실제 task의 사후 로그 조회까지 확인합니다.
airflowVersion: 3.3.1
defaultAirflowTag: 3.3.1
executor: KubernetesExecutor
postgresql:
  enabled: false
redis:
  enabled: false
data:
  metadataSecretName: airflow-metadata
  metadataConnection:
    protocol: postgresql
fernetKeySecretName: airflow-fernet
apiSecretKeySecretName: airflow-api-secret
jwtSecretName: airflow-jwt
createUserJob:
  enabled: false
triggerer:
  persistence:
    enabled: false
config:
  core:
auth_manager: airflow.providers.fab.auth_manager.fab_auth_manager.FabAuthManagerhelm repo add apache-airflow https://airflow.apache.org
helm repo update apache-airflow
helm install airflow apache-airflow/airflow \
--namespace airflow --version 1.22.0 \
--values kubernetes-values.yaml --wait --timeout 10m
kubectl -n airflow get deployments,statefulsets,pods,jobs
helm list -n airflow--wait 성공과 Running Pod만으로 DAG 실행 성공을 판단하지 않습니다. Migration Job은 성공 상태인지, 장기 실행 컴포넌트는 Ready인지 확인하고 Part 3의 smoke DAG로 실제 worker 시작·Execution API 통신·결과·로그를 검증합니다.
초기 사용자
기본 createUserJob은 admin/admin을 생성할 수 있어 위 profile에서는 비활성화했습니다. 현재 설정 위치는 createUserJob.defaultUser이며 옛 webserver.defaultUser는 호환 경로입니다. 비밀번호를 values.yaml이나 Helm --set에 넣는 대신, 이 profile이 선택한 FAB auth manager에서 다음 대화형 명령을 사용합니다. 다른 auth manager/SSO에는 그 방식의 사용자 관리 절차를 따릅니다.
# FAB auth manager, as selected in these values. Password is prompted twice.
kubectl -n airflow exec -it deployment/airflow-api-server -c api-server -- \
  airflow users create --username airflow-admin --role Admin \
  --email admin@example.com --firstname Airflow --lastname Admin
kubectl -n airflow port-forward --address 127.0.0.1 service/airflow-api-server 8080:8080
Port-forward가 실행 중인 동안 로컬 8080에서 UI를 확인합니다. 운영 UI에는 적절한 인증·인가·TLS 경로가 필요하며 이 명령이 공개 endpoint를 만드는 것은 아닙니다. API secret과 task JWT secret은 역할이 다르고 안정적으로 유지해야 합니다. Fernet key를 잃거나 무작정 바꾸면 기존 암호화된 connection/variable을 읽지 못할 수 있습니다.
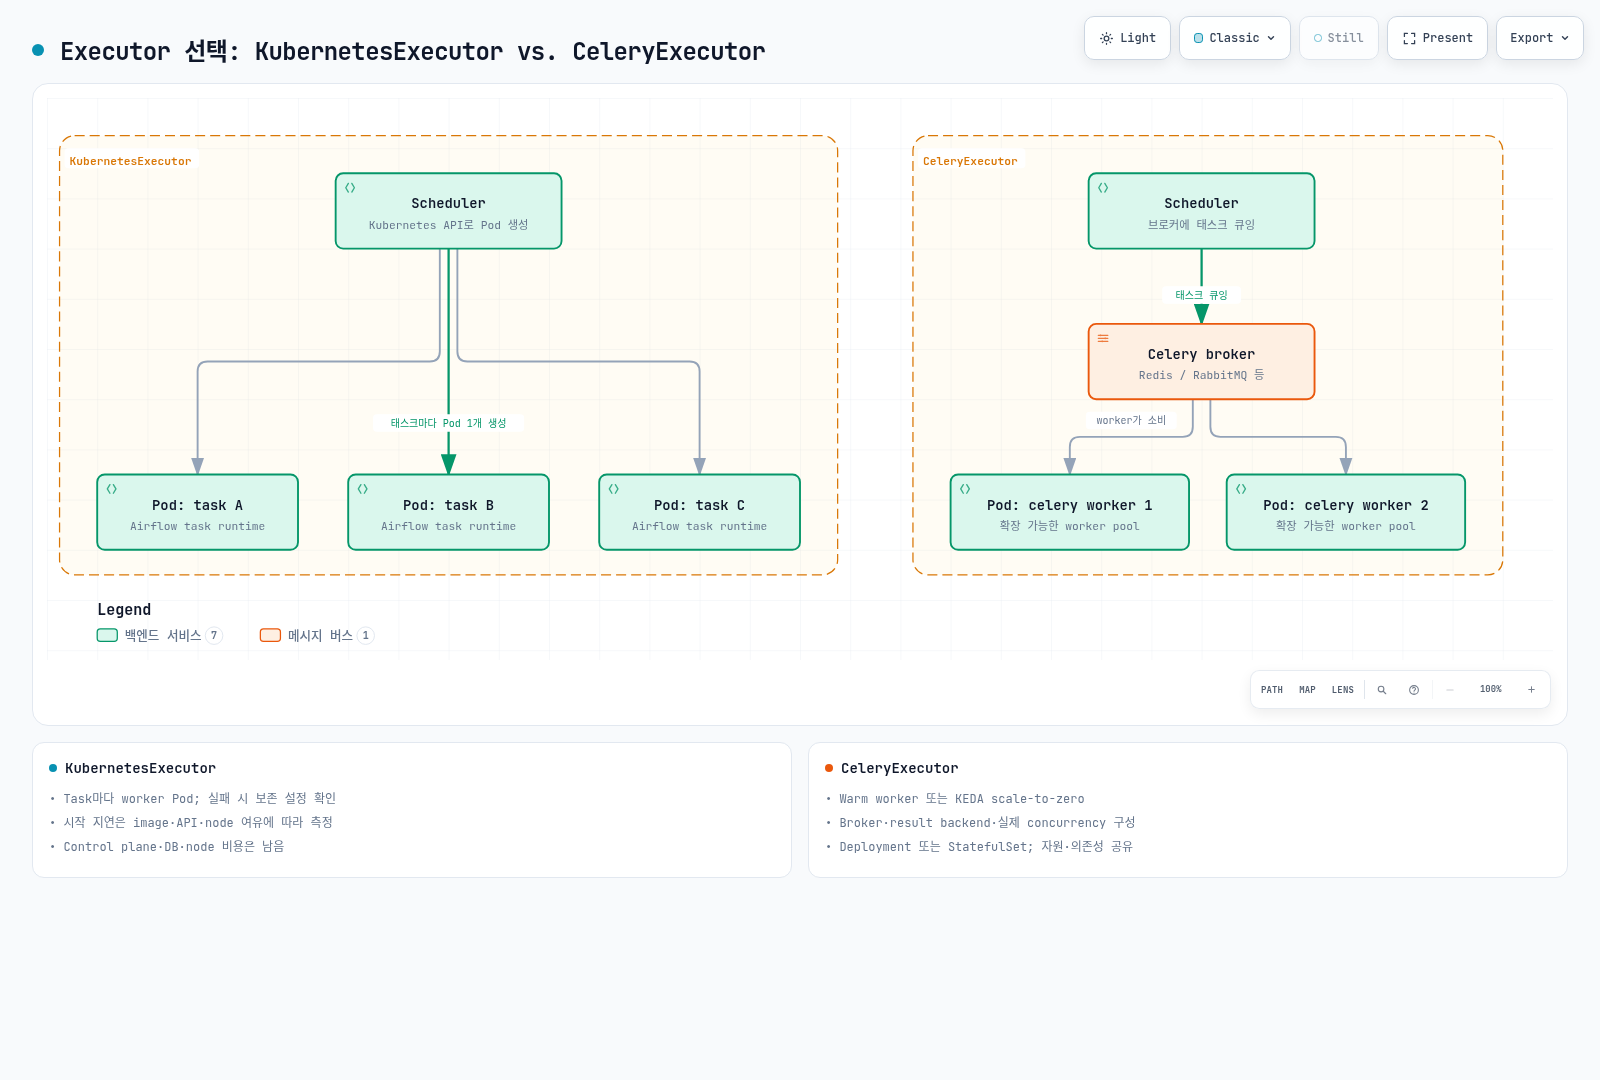
4. Executor를 성능·운영 조건으로 선택
| 항목 | KubernetesExecutor | CeleryExecutor |
|---|---|---|
| Worker 단위 | Task instance별 Pod | Broker에서 작업을 받는 pool |
| 시작 시간 | 이미지 cache·API·scheduler·node 여유에 따라 측정 | Warm pool은 시작 비용을 줄일 수 있음; scale-to-zero 후 cold start |
| 유휴 비용 | Task Pod 외 control plane·DB·노드·로그 비용 유지 | Worker 수 외 broker·DB·노드 비용 유지 |
| 자원·격리 | Pod spec·quota·SA·네트워크·노드 경계에 달림 | Worker 안의 동시 task가 자원·의존성을 공유 |
| 추가 요구 | Task image/runtime·DAG 전달·Kubernetes API 권한 | Broker, result backend, worker lifecycle·queue·동시성 관리 |
고정된 1–2분 지연이나 특정 executor의 보편적인 대규모 우위를 가정하지 않습니다. KubernetesExecutor의 worker image는 호환 Airflow task runtime과 DAG 의존성이 필요합니다. 임의 GPU/CLI 이미지를 그대로 넣는 기능과는 다릅니다. KubernetesPodOperator는 별도 child Pod에 임의 작업 이미지를 실행하는 다른 경로입니다. 작업 실패 시 Pod 보존·삭제도 provider 설정에 따라 달라집니다.
여러 executor를 구성할 수 있지만 대부분의 배포가 반드시 혼합형이어야 하는 것은 아닙니다. 단일 executor의 단순성과 혼합 운영의 이득·추가 정책을 실제 workload로 비교합니다.
5. Celery worker scaling
외부 broker와 result backend를 먼저 준비합니다. 다음 Secret은 Celery profile에만 필요하며 protocol·TLS·권한은 실제 서비스를 기준으로 검증합니다. Celery의 SQLAlchemy DB result backend URI는 db+postgresql:// 같은 형식을 사용하므로 metadata URI를 무조건 그대로 복사하지 않습니다.
# Use protected URI files for the chosen external broker and result backend.
: "${AIRFLOW_BROKER_URI_FILE:?Set the protected broker URI file}"
: "${AIRFLOW_RESULT_URI_FILE:?Set the protected Celery result-backend URI file}"
kubectl -n airflow create secret generic airflow-broker \
  --from-file="connection=$AIRFLOW_BROKER_URI_FILE"
kubectl -n airflow create secret generic airflow-result-backend \
  --from-file="connection=$AIRFLOW_RESULT_URI_FILE"
celery-values.yaml은 독립적인 전체 profile입니다. 신규 설치에서는 앞의 install 명령에 이 파일을 선택합니다. 실행 중 배포의 executor 변경은 drain·이행·복구 계획 후 수행합니다.
airflowVersion: 3.3.1
defaultAirflowTag: 3.3.1
executor: CeleryExecutor
postgresql:
  enabled: false
redis:
  enabled: false
data:
  metadataSecretName: airflow-metadata
  metadataConnection:
    protocol: postgresql
  brokerUrlSecretName: airflow-broker
  resultBackendSecretName: airflow-result-backend
fernetKeySecretName: airflow-fernet
apiSecretKeySecretName: airflow-api-secret
jwtSecretName: airflow-jwt
createUserJob:
  enabled: false
triggerer:
  persistence:
    enabled: false
config:
  core:
    auth_manager: airflow.providers.fab.auth_manager.fab_auth_manager.FabAuthManager
  celery:
    worker_concurrency: 4
workers:
  celery:
    persistence:
      enabled: false
    keda:
      enabled: true
      minReplicaCount: 0
      maxReplicaCount: 20
      pollingInterval: 10
      cooldownPeriod: 300
      advanced:
        horizontalPodAutoscalerConfig:
          behavior:
            scaleDown:
              stabilizationWindowSeconds: 300
Worker concurrency=4와 maxReplicaCount=20은 예시 상한이며 처리량·비용 보장이 아닙니다. Worker 자원 크기·task 메모리·DB/broker 부하·node 한도와 함께 조정합니다. 이 profile은 worker persistence=false라 Deployment를 대상으로 합니다. Persistence=true이면 chart는 StatefulSet을 대상으로 할 수 있으며 KEDA도 이를 지원합니다.
Chart의 실제 기본값은 pollingInterval=5s, cooldownPeriod=30s입니다. 예제는 의도를 명확히 하려고 10s/300s를 직접 지정했습니다. Cooldown은 0으로 줄이는 경로이며 1개 이상에서의 조정은 HPA의 polling·stabilization 설정과 구분합니다. 실제 DB 조회 주기는 KEDA 활성 상태·HPA 요청·metric caching 등에도 영향을 받으므로 항상 정확히 10초 간격이라고 단정하지 않습니다.
이 profile에서 렌더링된 PostgreSQL 쿼리는 다음과 같습니다.
SELECT ceil(COUNT(*)::decimal / 4) FROM task_instance WHERE (state='running' OR state='queued') AND queue IN ('default')worker_concurrency는 DB column이 아니라 chart가 넣는 숫자 4입니다. running/queued 상태를 해당 worker queue 범위로 세어 필요한 worker 수를 계산합니다. 결과가 25여도 maxReplicaCount=20이면 그 이상으로 늘지 않으므로 backlog가 남을 수 있습니다. 쿼리 오류·인증 실패를 0개 작업으로 해석하지 말고 ScaledObject와 HPA 상태를 확인합니다.
혼합 executor와 alias의 함정
KubernetesExecutor와 함께 쓰면 Celery가 처리하지 않을 작업을 제외해야 합니다. Chart 기본 쿼리는 문자열 KubernetesExecutor를 제외하지만 task가 k8s 같은 alias를 저장하면 그대로 집계될 수 있습니다. 실제 TaskInstance는 task.executor 값을 보존합니다.
아래는 CeleryExecutor를 기본으로 하고 KubernetesExecutor를 함께 설정한 경우의 예시 query override입니다. Queue·alias·전체 클래스 이름을 바꾸면 실제 저장 값을 확인해 필터도 수정합니다. NULL은 이 예제에서 기본 Celery executor를 쓰는 task입니다.
executor: CeleryExecutor,KubernetesExecutor
workers:
  celery:
    keda:
      query: >-
        SELECT ceil(COUNT(*)::decimal / {{ .Values.config.celery.worker_concurrency }})
        FROM task_instance
        WHERE state IN ('running', 'queued')
        AND queue = 'default'
        AND (executor IS NULL OR executor = 'CeleryExecutor')
이 부분 설정은 Celery 전체 profile에 합칩니다. 변경 전에 helm template로 실제 SQL과 대상 worker를 검토합니다. KubernetesExecutor의 task Pod 자체는 KEDA가 같은 방식으로 replica를 조절하는 pool이 아닙니다. Karpenter/Cluster Autoscaler 등의 node 용량과 Airflow의 parallelism·pool·DAG 동시성·API 처리량은 여전히 별도 제한입니다. KEDA가 Deployment만 지원하거나 KubernetesExecutor 환경에서 다른 용도로 쓸 수 없다는 뜻은 아닙니다.
6. 검증과 리소스 수명주기
kubectl -n airflow rollout status deployment/airflow-api-server --timeout=180s
kubectl -n airflow rollout status deployment/airflow-scheduler --timeout=180s
kubectl -n airflow rollout status deployment/airflow-dag-processor --timeout=180s
kubectl -n airflow get jobs
kubectl -n airflow logs deployment/airflow-scheduler -c scheduler --tail=100
kubectl -n airflow logs deployment/airflow-dag-processor -c dag-processor --tail=100
# Celery/KEDA profile only:
kubectl -n airflow get scaledobjects,hpa
kubectl -n airflow describe scaledobject airflow-worker
kubectl -n airflow get deployments,statefulsets -l component=worker
한 번의 UI 접속이나 healthy Deployment만으로 DB migration·DAG 전달·task 실행· 원격 로그·KEDA scale-to-zero가 모두 검증되지는 않습니다. 예상한 task를 넣고 worker 수·실행 결과·로그를 확인한 후 idle 복귀와 복구를 시험합니다.
내장 PostgreSQL은 이 profile에서 사용하지 않습니다. 기본 chart는 오래된 bitnamilegacy PostgreSQL 이미지를 사용하므로 단순 기본 설치를 production 기준으로 삼지 않습니다. Helm uninstall로 DB Pod가 사라져도 PVC/PV 데이터까지 즉시 삭제되는 것은 아닙니다. PVC 보존 정책·StorageClass reclaim policy·외부 DB의 삭제/백업 정책을 각각 확인하고 namespace·Secret·DB를 일괄 삭제하는 정리 명령으로 대체하지 않습니다.
이번 검토에서는 chart와 KEDA 리소스 형식, 공개 image manifest, 실제 PostgreSQL 엔진의 SQL 24개 사례를 확인했습니다. 실제 EKS/DB 연결·이미지 실행·사용자 생성이나 KEDA controller scaling을 수행한 것은 아닙니다.