모던 데이터 파이프라인 해부 — 5개 역할
마지막 업데이트: 2026년 9월 12일
이 문서의 위치
Kafka·Spark·Airflow·Flink가 파이프라인에서 맡는 역할과 계층 사이의 계약을 설명합니다.
소스·수집·저장·처리·소비는 설계를 설명하는 개념적 역할입니다. 제품마다 정확히 하나의 역할만 맡거나, 반드시 저장 후 처리하는 직선 순서를 따라야 한다는 뜻은 아닙니다. 스트림은 처리 후 저장할 수도 있고 웨어하우스 안에서 변환할 수도 있습니다. 스키마, 데이터 신선도, 보존, 재처리와 출력 중복 처리의 계약을 먼저 정합니다.
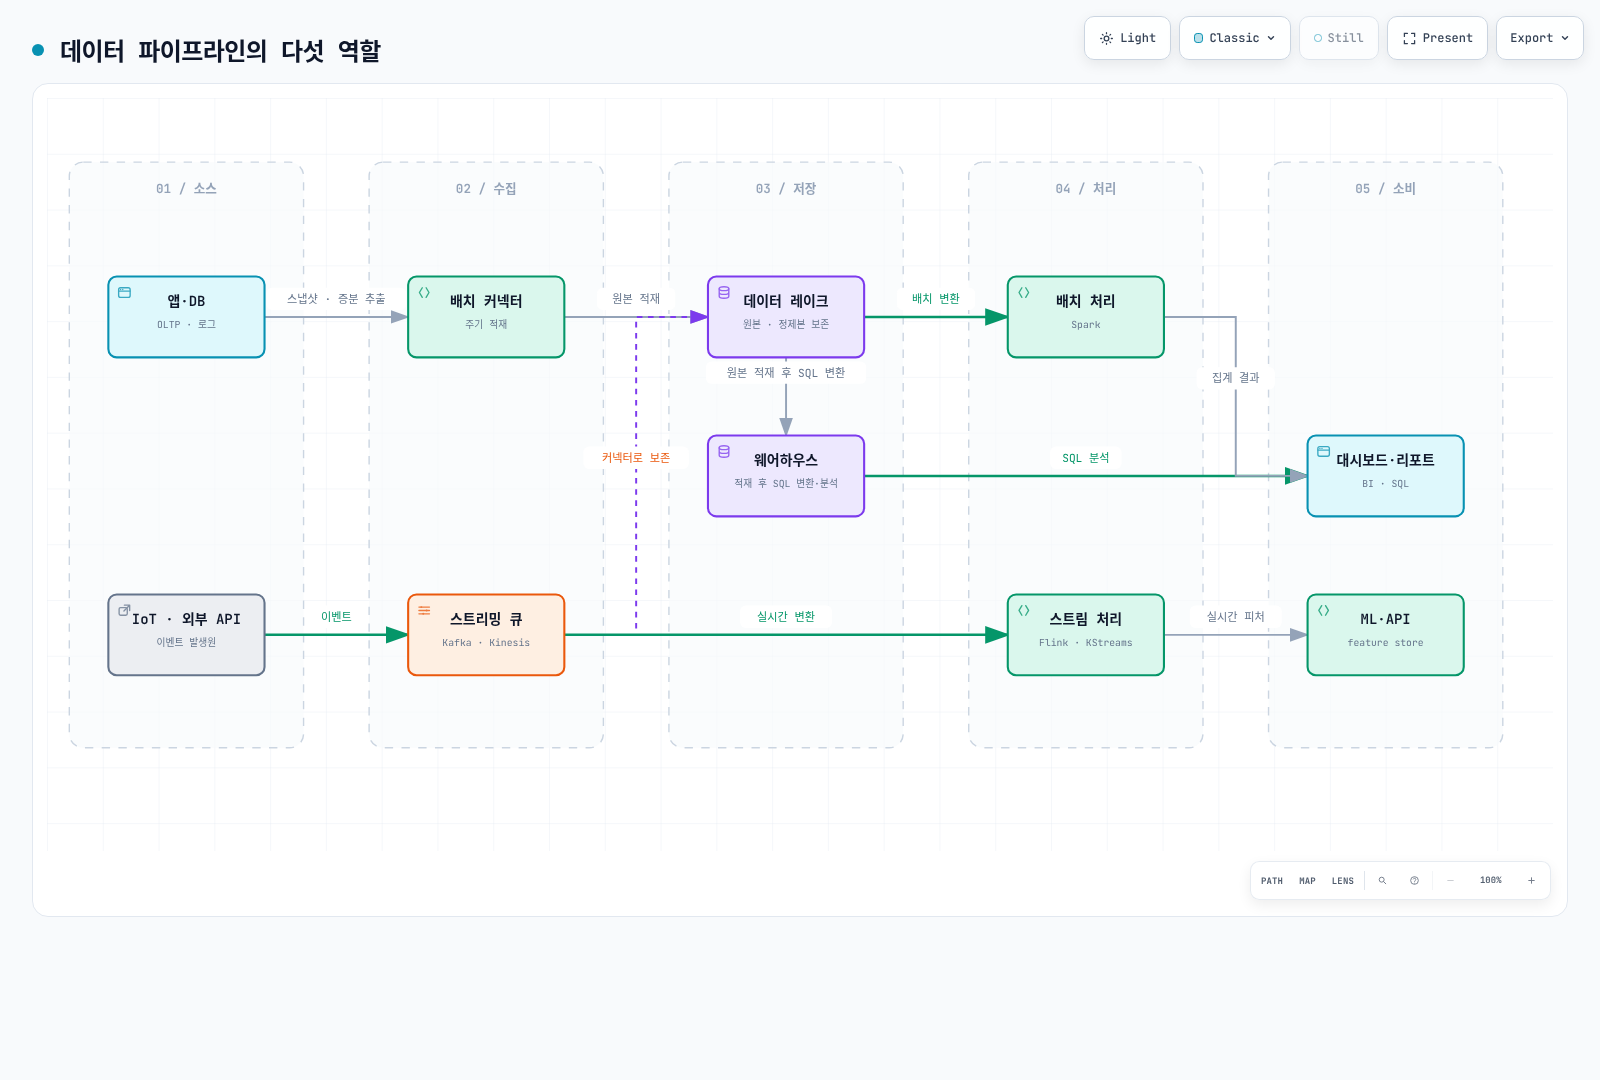
1. 소스 — 변경과 부하
소스에는 애플리케이션 DB, 로그, IoT 장치와 외부 API가 있습니다. 전체 스냅샷, 증분 질의, 로그 기반 CDC 중 필요한 방식을 선택합니다. 로그 기반 CDC는 해당 DB의 복제 로그와 보존·권한 설정에 의존하며, 스키마 변경의 지원 범위는 connector와 데이터 형식별로 다릅니다.
읽기 복제본과 로그 기반 추출은 운영 DB 부하를 줄이는 선택지입니다. 모든 DB·connector 조합에서 지원되는 것은 아니므로 초기 snapshot 부하, 복제 지연, 로그 누락 시 복구 방법을 함께 확인합니다.
2. 수집 — 배치와 이벤트
| 방식 | 동작 | 예시 | 지연을 결정하는 요소 |
|---|---|---|---|
| 배치 수집 | 일정 또는 조건에 따라 묶어서 추출·적재 | Airbyte, JDBC 배치 작업 | 실행 주기·데이터량·적재 대상 |
| 이벤트 수집 | 변경·이벤트를 지속적으로 발행·소비 | Kafka, Kinesis, Pulsar | 생산·전송·소비·sink의 지연 |
Apache Sqoop은 2021년 6월 은퇴했으므로 신규 도입 도구 예시에 사용하지 않습니다. 배치와 스트리밍은 필요에 따라 단독 또는 함께 사용합니다.
Kafka에서 실제로 남아 있는 레코드는 offset을 조정해 다시 소비할 수 있습니다. 시간·용량 기반 삭제와 log compaction, tombstone 정책에 따라 과거 이벤트가 사라질 수 있으므로 보존 기간 숫자만으로 전체 이력 재생을 보장하지 않습니다.
재생 가능성만으로 end-to-end exactly-once가 완성되지는 않습니다. 소스 위치와 처리 상태를 일관되게 복구하고, sink의 트랜잭션·멱등성·외부 부작용 처리까지 맞춰야 합니다. 장애 후 같은 레코드를 다시 실행하는 것과 최종 결과를 중복 반영하는 것은 구분합니다.
Kafka 운영 8개 장과 Part 9 벤치마크에서 EKS 운영 선택을 이어서 다룹니다.
3. 저장 — 원본과 조회 모델
| 선택 | 예시 | 설계 관점 |
|---|---|---|
| 데이터 레이크 | S3 파일·오브젝트 | 원본과 정제본, 보존·권한·품질·쿼리 비용 |
| 웨어하우스 | Redshift, Snowflake, BigQuery | 적재와 SQL 변환, 테이블·성능·거버넌스 |
| 레이크하우스 | Iceberg, Delta Lake, Hudi | 테이블 포맷과 engine 호환성, 동시성·유지 관리 |
원본을 레이크에 보존하는 방식은 재처리에 유용하지만 유일한 표준 경로는 아닙니다. 재생에는 실제 데이터 보존과 접근 권한도 필요합니다.
ETL은 추출 → 변환 → 대상 적재, ELT는 추출 → 대상 적재 → 대상 안에서 변환입니다. 이미 정제한 결과를 웨어하우스로 옮기는 작업을 그 이유만으로 ELT라고 부르지 않습니다. 레이크와 웨어하우스를 함께 쓴다는 사실만으로 ETL/ELT가 결정되지 않습니다.
4. 처리 — 유한 입력과 지속 입력
Spark는 배치 처리와 Structured Streaming을 지원합니다. Flink도 스트림과 bounded 입력 처리를 지원합니다. 배치/스트림은 도구를 서로 배타적으로 나누는 분류가 아닙니다.
스트림으로 빠른 잠정 결과를 내고 지연 도착 데이터를 반영해 나중에 확정하는 설계, 배치로 정산을 재계산하는 설계 등이 가능합니다. 스트림이 본질적으로 근사이고 배치가 항상 정확한 것은 아닙니다. event time, watermark, 허용 지연, 중복 제거, 상태·checkpoint와 출력 계약에 따라 결정됩니다.
Spark와 Flink 문서에서 처리 엔진별 운영을 다룹니다.
5. 소비 — 결과 계약
BI, 보고서, ML 학습·추론용 feature store와 데이터 API가 결과를 소비합니다. “대시보드 5분 지연 허용”, “정산은 마감 이후 수정 규칙 필요”, “추천 피처는 1초 목표”처럼 소비자별 요구를 측정 가능한 계약으로 바꿉니다. 이 숫자는 예시이며 제품의 성능 보장이 아닙니다.
공통 운영 기능
- 오케스트레이션: Airflow 등으로 batch-oriented 작업의 의존성·일정·재시도를 관리합니다. 모든 이벤트를 직접 처리하는 엔진이 아니며, 파이프라인이 두 개라는 이유만으로 반드시 Airflow가 필요한 것도 아닙니다.
- 스키마 계약: Registry 호환성 검사는 적용한 schema 등록·serialization·CI 경로에서 강제됩니다. 소스 DB의 임의 DDL이나 업무 의미 변경을 자동으로 모두 차단하지 않으므로 호환성 정책과 실제 소비자 테스트를 연결합니다.
- 관측성: 리니지, 신선도, 누락·중복·품질 지표와 장애 재처리 이력을 확인합니다.
EKS 관점
Kafka·Spark·Flink는 해당 Operator/배포 방식을, Airflow는 Helm chart와 executor 및 KubernetesPodOperator 같은 task 방식을 사용합니다. Airflow의 “Operator”와 Kubernetes controller 패턴은 같은 용어 사용이 아닙니다. 저장·분석 서비스와 관리형 작업 공간은 클러스터 밖의 AWS 서비스와 연결할 수 있습니다. 운영 책임과 관리형 선택지를 비교하십시오.
참고
계층 설명은 Abhishek Agrawal의 “Anatomy of a Modern Data Pipeline” 인포그래픽에서 출발했으며, 본문의 계약·운영 설명은 별도로 검토했습니다.