네트워크 기초 Part 1 — 계층 모델과 링크·라우팅 계층
마지막 업데이트: 2026년 9월 14일
4부작 시리즈입니다
Part 1: 계층 모델과 링크·라우팅 (현재 문서) · Part 2: 전송 계층과 TLS · Part 3: 애플리케이션 프로토콜 · Part 4: 요청의 여정과 클라우드
브라우저 요청에는 여러 프로토콜이 협력합니다. 실제 순서는 캐시, 연결 재사용, IP 및 HTTP 버전에 따라 달라지므로 장애 분석에서는 HTTP뿐 아니라 관련 계층도 확인해야 합니다.
이 시리즈에서는 인터넷을 실제로 굴러가게 만드는 네트워크 프로토콜과 메커니즘 25개를 계층 순서대로 아래에서 위로 정리합니다. 계층을 아래에서부터 쌓는 이유는 단순합니다. 상위 계층은 하위 계층이 이미 동작한다고 가정하고 설계되어 있기 때문에, 위에서부터 읽으면 "그건 어떻게 되는 건데?"가 계속 남습니다.
각 항목은 한 줄 정의 → 동작 방식 → 실무에서 걸리는 지점 순으로 씁니다.
0. 계층 지도 한 장
| 계층 | 하는 일 | 이 글에서 다루는 프로토콜 |
|---|---|---|
| 애플리케이션 | 실제 서비스 의미론 | HTTP/3, WebSocket, WebRTC, gRPC, DNS, DoH, DHCP, MQTT, SSH, SMTP |
| 보안 | 암호화·인증 (전송 계층에 얹힘) | TLS |
| 전송 | 종단 간(end-to-end) 데이터 전달 | TCP, UDP, QUIC |
| 인터넷 / 라우팅 | 네트워크 간 경로 결정 | IPv4, IPv6, ICMP, BGP, OSPF, NAT |
| 링크 | 같은 물리 구간 내 전달 | Ethernet, Wi-Fi, VLAN, PPP, ARP |
계층 경계가 깔끔하게 지켜지지 않는 항목이 몇 개 있습니다. TLS는 전송과 애플리케이션 사이에 끼어 있고, QUIC은 UDP 위에 얹혀서 전송 계층 역할을 하며, ARP는 IP와 링크 사이를 잇습니다. NAT는 아예 프로토콜이라기보다 기능입니다. 이런 "예외"들이 실무 트러블슈팅의 대부분을 차지합니다.
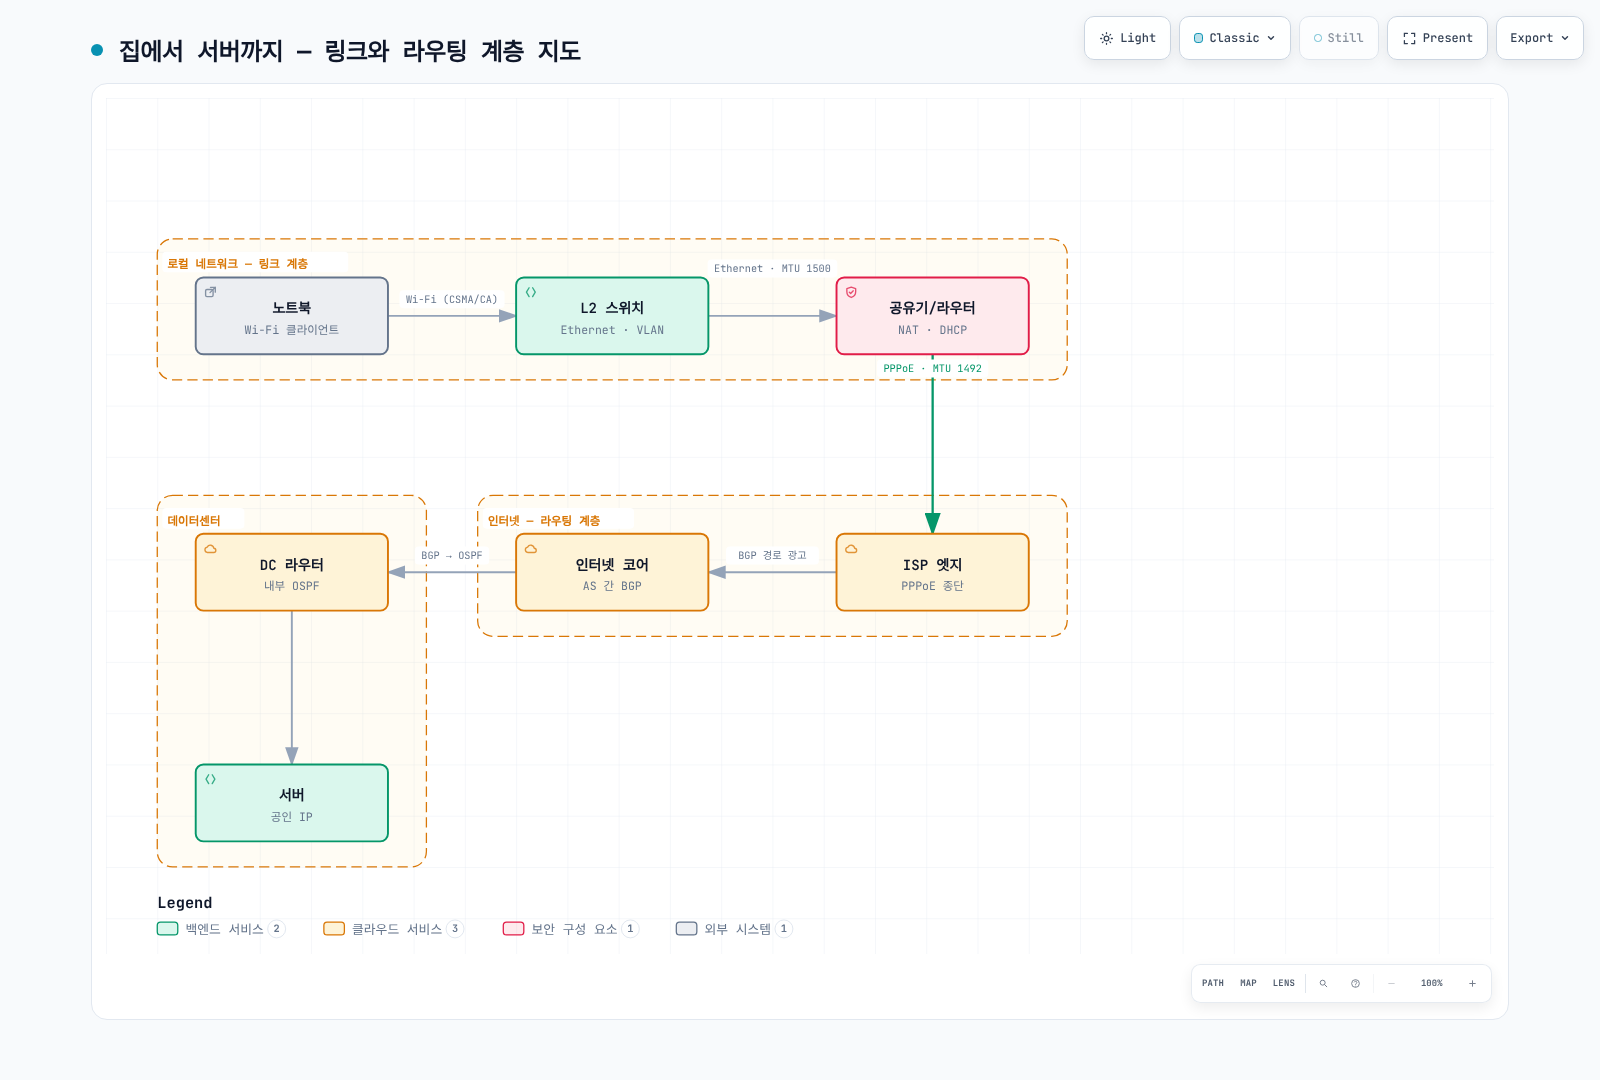
1. 링크 계층 — 같은 구간 안에서 옮기기
링크 계층의 관심사는 딱 하나입니다. 바로 옆에 붙어 있는 장비에게 어떻게 비트를 넘기는가. 목적지가 지구 반대편이든 옆 서버든, 이 계층은 "다음 홉(next hop)"까지만 책임집니다.
Ethernet
정의: 유선 로컬 네트워크에서 프레임을 실어 나르는 링크 계층 표준.
동작: 데이터를 프레임 단위로 감싸고, 앞에 목적지·출처 MAC 주소를 붙입니다. 알려진 유니캐스트는 MAC 테이블에 따라 포트로 전달합니다. 브로드캐스트와 미학습 유니캐스트는 보통 VLAN 안에서 flooding하며 멀티캐스트 처리는 설정에 따라 다릅니다. 초기 이더넷은 충돌 감지(CSMA/CD)에 의존했지만, 현대의 스위치 기반 풀듀플렉스 환경에서는 충돌 자체가 거의 사라졌습니다.
실무 포인트: Ethernet IP 트래픽에서 MTU 1500은 프레임 내부 IP 패킷 1500바이트를 뜻하며 Ethernet 헤더/FCS는 제외합니다. 점보 MTU는 장비/경로별로 다르고 9001은 EC2 지원 값이지 보편적인 Ethernet 크기가 아닙니다. 클라우드에서 VPN이나 오버레이 네트워크를 얹으면 캡슐화 헤더 때문에 실효 MTU가 줄어들고, MTU 탐색까지 실패하면 생길 수 있는 블랙홀은 "핑은 되는데 큰 응답만 멈춘다"는 형태로 나타납니다. 원인 파악이 유독 오래 걸리는 유형의 장애입니다.
MTU와 MSS의 관계: MSS는 프레임 전체가 아닌 TCP 데이터 바이트 수를 제한합니다. MTU 1500에서 기본 헤더만 고려하면 IPv4는 1460(1500−20−20), IPv6는 1440(1500−40−20)입니다. 송신자는 실제 패킷에 포함하는 IP/TCP 옵션만큼 데이터 길이를 추가로 줄입니다. TCP는 핸드셰이크에서 MSS를 교환하므로, 터널 구간에서 MTU 문제가 반복될 때는 라우터에서 MSS 클램핑(TCP MSS를 강제로 낮추는 설정)으로 우회하는 방법이 널리 쓰입니다.
Wi-Fi
정의: 무선 구간에서 LAN 프레임을 실어 나르는 링크 계층 표준(IEEE 802.11).
동작: 공기라는 공유 매체를 쓰기 때문에 이더넷과 근본적으로 다릅니다. 송신 중 충돌 감지에 의존하지 않고 CSMA/CA로 매체 접근을 조정합니다. 프레임을 보내기 전에 채널이 비었는지 확인하고, 일반 유니캐스트는 ACK/재시도를 사용하며 브로드캐스트/멀티캐스트 처리는 다릅니다. 즉 링크 계층에 이미 재전송이 들어 있습니다.
실무 포인트: 링크 계층 재전송과 TCP 재전송이 겹치면서 지연 변동(jitter)이 커집니다. 실시간 통신 품질 문제가 "서버 탓"으로 보고되지만 실제로는 클라이언트의 무선 구간인 경우가 많습니다. 서버 RTT만으로 원인을 특정할 수 없으며 애플리케이션 처리 시간, 클라이언트/AP 재시도, 신호 및 큐 지표를 함께 확인합니다.
VLAN
정의: 공유 스위치 인프라를 논리적 L2 네트워크로 나누는 기술(IEEE 802.1Q).
동작: 802.1Q 태그 프레임은 4바이트 VLAN 태그를 담습니다. 액세스 포트에서는 태그 없는 프레임을 스위치가 해당 VLAN에 연결할 수도 있습니다. 같은 VLAN끼리만 브로드캐스트가 도달하므로, 물리 배선을 바꾸지 않고 네트워크를 분리할 수 있습니다. VLAN 간 통신은 반드시 L3 장비(라우터 또는 L3 스위치)를 거쳐야 합니다.
실무 포인트: VLAN은 논리적 L2 분리이며 물리적 분리나 암호화를 제공하지 않습니다. 구간 간 허용 트래픽은 라우팅과 방화벽으로 제어합니다. VPC·서브넷·보안 그룹은 서로 다른 클라우드 네트워크 역할을 하며 VLAN의 일대일 대체물이 아닙니다.
📎 EKS의 VPC 구성은 EKS 네트워킹 기초 참고.
PPP
정의: 두 노드를 직접 연결하는 점대점 링크에서 패킷을 실어 나르는 프로토콜.
동작: 이더넷과 달리 주소 지정이 필요 없습니다. 링크 양 끝에 노드가 하나씩만 있으니까요. 대신 링크 수립·선택적 인증·상위 프로토콜 협상 절차(LCP/NCP)를 갖추고 있습니다.
실무 포인트: 다이얼업 시대의 유물처럼 보이지만, PPPoE 형태로 여전히 상당수의 가정용 인터넷 회선에서 살아 있습니다. 그리고 표준 1500바이트 Ethernet payload에서는 일반적인 PPPoE 헤더 6바이트와 PPP protocol 필드 2바이트를 빼 IP에 1492바이트가 남습니다. 더 큰 하위 링크와 협상 지원이 있으면 1500을 유지할 수 있습니다. 앞서 말한 MTU 문제의 대표적 원인입니다.
ARP
정의: 같은 링크의 IPv4 다음 홉 주소를 MAC 주소로 확인하는 프로토콜.
동작: IP 계층은 "10.0.1.5로 보내라"고 지시하지만, 이더넷은 MAC 주소만 이해합니다. 그래서 호스트는 브로드캐스트로 "10.0.1.5의 MAC 주소를 가진 분?"이라고 묻고, 해당 호스트가 응답합니다. 결과는 OS별 상태/시간 제한에 따라 캐시됩니다. 다른 링크의 목적지로 보낼 때는 원격 호스트가 아닌 게이트웨이의 MAC을 확인합니다.
실무 포인트: ARP는 인증이 없습니다. 아무나 "그 IP는 제 겁니다"라고 응답할 수 있어서 ARP 스푸핑이 성립합니다. 반대로 이 성질을 이용하는 정상 기법도 있습니다. 페일오버 시 새 액티브 노드가 Gratuitous ARP로 이웃의 VIP-to-MAC 정보를 갱신하고 스위치도 프레임의 source MAC 위치를 학습하게 하는 방식이 대표적입니다. VIP 기반 HA 구성에서 전환이 느릴 때는 이 갱신이 지연되는 경우를 의심해볼 수 있습니다.
📎 Cilium이 L2/라우팅 동작을 eBPF와 어떻게 통합하는지는 Cilium 네트워킹 참고.
2. 인터넷·라우팅 계층 — 네트워크를 건너가기
링크 계층이 "옆집까지"라면, 이 계층은 "지구 반대편까지"를 담당합니다. 핵심 질문은 어디로 보낼 것인가입니다.
IPv4
정의: 32비트 주소 체계 기반의 인터넷 계층 프로토콜.
동작: 각 패킷에 출발지·목적지 IP를 붙이고, 라우터는 라우팅 테이블에서 가장 구체적인(longest prefix match) 경로를 찾아 다음 홉으로 넘깁니다. 배달을 보장하지 않는 최선 노력(best-effort) 방식이며, 순서 보장도 없습니다. 그 보장은 위층(TCP)의 일입니다.
실무 포인트: IPv4 주소 공간은 약 43억 개이며 가용 주소 부족으로 NAT가 널리 사용되고, 사설 주소 대역(10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16)이 내부망 표준이 됐습니다. 대규모 조직에서 클라우드 마이그레이션할 때 가장 먼저 부딪히는 문제가 이 사설 대역의 중복입니다. 온프레미스와 VPC CIDR이 겹치면 단순 라우팅으로는 구분할 수 없으므로 주소 재설계·변환·프록시 같은 별도 해결책을 설계해야 합니다. IP 주소 설계는 프로젝트 시작 시점에 확정해야 하는 항목입니다.
IPv4와 CIDR: 서브넷 계산 예제
IPv4는 8비트 옥텟 네 개로 구성됩니다. CIDR 표기에서 /26은 앞의 26비트를 네트워크 프리픽스로 고정하고 32 − 26 = 6비트를 호스트 부분으로 남깁니다. 아래 주소들은 RFC 5737의 문서용 예제이며 공개 테스트 서버 주소가 아닙니다.
인터페이스 주소가 **192.0.2.130/26**이라면 다음과 같이 계산합니다.
| 단계 | 계산 또는 결과 |
|---|---|
| 서브넷 마스크 | 255.255.255.192; 마지막 옥텟의 이진수는 11000000 |
| 블록당 주소 수 | 2^6 = 64; 마지막 옥텟의 블록 시작점은 0, 64, 128, 192 |
| 네트워크 주소 | 130 AND 192 = 128 (10000010 AND 11000000 = 10000000), 따라서 192.0.2.128/26 |
| 브로드캐스트 주소 | 호스트 6비트를 모두 1로 설정: 192.0.2.191 |
| 일반 호스트 범위 | 192.0.2.129–192.0.2.190: 62개 |
인터페이스가 사용하는 주소는 .130이고 .128/26은 서브넷을 나타냅니다. 일반적인 브로드캐스트 서브넷에서는 호스트 부분이 모두 0인 주소와 모두 1인 주소를 네트워크·브로드캐스트 주소로 구분합니다. 게이트웨이도 설정한다면 호스트 범위의 주소 하나를 사용하며, CIDR 자체가 첫 호스트 주소를 게이트웨이로 강제하지는 않습니다.
모든 프리픽스에서 “주소 두 개 빼기”를 적용하면 안 됩니다. RFC 3021은 지원되는 점대점 링크에서 /31의 두 주소를 모두 사용하도록 합니다. /32는 주소 하나를 가리키며 호스트 경로 등에 쓰이지만, Ethernet에 직접 연결된 이웃이라는 뜻은 아닙니다. 클라우드 할당 규칙도 별개입니다. 일반적인 AWS VPC IPv4 서브넷은 처음 네 주소와 마지막 주소를 예약하므로 /26에서 할당 가능한 주소는 59개이며 BYOIP 같은 예외도 있습니다. 할당 방식별 VPC 서브넷 규칙을 확인하세요.
최장 프리픽스와 다음 홉, ARP
라우팅 조회가 이웃 주소 확인보다 먼저입니다. eth0에 192.0.2.130/26이 있는 Linux 호스트의 예시 라우팅 테이블을 보겠습니다.
| 목적지 프리픽스 | 다음 홉 / 인터페이스 |
|---|---|
192.0.2.128/26 | eth0에 직접 연결(on-link) |
198.51.100.0/24 | eth0의 192.0.2.129 경유 |
198.51.100.128/25 | eth0의 192.0.2.190 경유 |
0.0.0.0/0 | 기본 경로: eth0의 192.0.2.129 경유 |
선택된 테이블 안에서 목적지와 일치하는 가장 긴 프리픽스를 고릅니다(RFC 1812 §5.2.4.3).
192.0.2.150은/26경로로 직접 연결됩니다. 이웃 항목이 없다면 ARP로.150자체의 MAC을 확인합니다.198.51.100.140은/24,/25,/0에 모두 해당하므로/25가 선택됩니다. ARP 대상은 원격 목적지가 아니라 게이트웨이 **192.0.2.190**입니다.203.0.113.10은/0에만 해당하므로 게이트웨이 **192.0.2.129**를 사용합니다.
라우팅되는 패킷의 Ethernet 목적지는 게이트웨이 MAC이지만, NAT가 없다면 IP 목적지는 원격 호스트 그대로입니다. 기본 경로의 metric이 더 낮아도 일치하는 /25보다 우선하지 않습니다. Linux 정책 규칙은 다른 테이블을 선택할 수 있으므로 ip-route(8) 매뉴얼에 따라 해당 네트워크 네임스페이스에서 ip route get으로 실제 조회 결과를 확인하세요. 호스트와 컨테이너의 경로·이웃 테이블은 다를 수 있습니다.
IPv6
정의: 128비트 주소 체계의 차세대 인터넷 계층 프로토콜.
동작: 주소가 128비트로 늘어나 고갈 문제가 사라집니다. 기본 헤더는 고정 40바이트이며 헤더 체크섬이 없고 라우터가 IPv6 패킷을 단편화하지 않습니다. SLAAC를 통해 DHCP 없이도 주소를 자동 설정할 수 있고, ARP는 NDP(Neighbor Discovery Protocol)로 대체됩니다.
실무 포인트: IPv4와 하위 호환되지 않습니다. 그래서 현실에서는 듀얼 스택으로 운영하며, 이는 방화벽 규칙과 보안 정책을 두 벌 관리해야 한다는 뜻입니다. IPv6 경로에 대한 규칙 누락은 흔한 보안 공백입니다. 글로벌 IPv6 주소만으로 워크로드가 인터넷에서 접근 가능해지는 것은 아닙니다. AWS에서도 라우팅과 보안 그룹/NACL 허용이 필요하며 egress-only internet gateway로 외부의 새 연결을 막고 아웃바운드를 제공할 수 있습니다.
전환 메커니즘: IPv4와 공존하는 현실적 방법은 세 갈래입니다. 듀얼 스택(두 프로토콜을 나란히 운영 — 가장 흔하지만 정책 이중화 비용), 터널링(IPv6 패킷을 IPv4로 감싸 통과), 그리고 NAT64/DNS64(IPv6 전용 클라이언트가 IPv4 서버에 접근하도록 변환 — 모바일 통신망이 464XLAT 형태로 대규모로 사용). 쿠버네티스도 듀얼 스택 Service를 지원하므로, 클러스터 CIDR 설계 시 IPv6 대역을 함께 고려할 수 있습니다.
ICMP
정의: 네트워크 오류와 상태를 보고하는 제어 프로토콜.
동작: 제어 정보를 전달하며 Echo payload나 원본 패킷의 일부 데이터도 포함할 수 있습니다. 목적지 도달 불가, TTL 초과, 단편화 필요 등을 알립니다. ping은 Echo Request/Reply를, traceroute는 TTL(IPv6는 Hop Limit)을 1씩 늘려가며 돌아오는 Time Exceeded를 이용합니다.
실무 포인트: "보안상" ICMP를 전면 차단하는 정책이 흔한데, 이게 앞서 언급한 MTU 블랙홀의 직접적 원인입니다. 전통적인 IPv4 PMTUD는 ICMP Type 3 Code 4, IPv6는 ICMPv6 Packet Too Big Type 2를 사용합니다. 필요한 메시지를 막으면 블랙홀이 생길 수 있지만 PLPMTUD는 ICMP에 의존하지 않고 패킷 크기를 탐색할 수도 있습니다. IP 버전과 정책에 맞는 오류/탐색 트래픽을 허용합니다.
📎 EKS에서 이 문제가 실제로 나타나는 형태는 EKS 네트워킹 심화 참고.
ICMP와 traceroute 결과 해석
IPv4 패킷을 전달하는 라우터는 TTL을 줄입니다. TTL이 만료되면 해당 탐색 패킷(probe)을 폐기하고 보통 **ICMP Time Exceeded(Type 11, Code 0)**를 반환합니다. 이는 의도적으로 TTL을 작게 설정한 탐색에서 기대하는 동작이며, 일반 애플리케이션 패킷도 실패한다는 증거가 아닙니다. 오류 메시지는 원본 패킷 일부를 포함하므로 송신자는 어느 probe에 대한 응답인지 연결할 수 있습니다(RFC 792).
내보낸 probe와 돌아온 응답을 구분하세요. 아래 traceroute 방식은 모두 중간 라우터에서 ICMP Time Exceeded를 받을 수 있습니다.
| 송신 probe | 목적지에 도착했을 때의 일반적인 응답 |
|---|---|
| 사용하지 않는 목적지 포트로 UDP 전송 | ICMP Destination Unreachable의 Port Unreachable(IPv4 Type 3, Code 3) |
| ICMP Echo Request | ICMP Echo Reply |
| 선택한 포트로 TCP SYN 전송 | 수신 대기 포트는 TCP SYN/ACK, 닫힌 포트는 RST |
기본값과 옵션은 구현마다 다릅니다. Linux traceroute(8) 매뉴얼은 UDP·ICMP·TCP 방식을 설명합니다. TCP probe는 해당 포트의 처리를 확인하지만 SYN/ACK을 받아도 TLS나 HTTP 동작까지 증명하지는 않습니다.
*는 대기 시간 안에 대응하는 응답을 받지 못했다는 뜻입니다. probe가 필터링되었거나, 라우터가 응답을 생략·속도 제한했거나, 반환 경로에서 응답이 유실되었을 수 있습니다. 한 홉이 조용해도 뒤 홉들이 응답한다면 그것만으로 종단 간 손실을 확정할 수 없습니다. 표시된 RTT에는 순방향과 다를 수 있는 반환 경로도 포함되고, 로드밸런싱 때문에 probe마다 다른 라우터가 보일 수도 있습니다. 반복 관측을 목적지·애플리케이션 결과와 대조한 뒤 장애 위치를 판단하세요.
traceroute는 주로 홉을 탐색하므로 작은 probe의 성공이 경로 MTU를 검증하지는 않습니다. DF가 설정된 더 큰 IPv4 패킷에서는 작은 MTU를 알리기 위한 **Fragmentation Needed(Type 3, Code 4)**가 여전히 필요할 수 있습니다. 이를 Time Exceeded·Port Unreachable과 구분하고 위에서 설명한 IPv6·PLPMTUD 차이도 함께 고려하세요.
📎 Linux 라우팅·ICMP 실습에서 경로와 probe 해석을 적용하고 컨테이너·쿠버네티스 진단으로 이어가세요.
OSPF
정의: 하나의 자율 시스템 내부에서 최적 경로를 계산하는 링크 상태 라우팅 프로토콜.
동작: 각 라우터가 자신의 링크 상태를 영역 전체에 전파하고, 같은 영역의 라우터는 수렴 후 일관된 링크 상태 정보를 갖습니다. 그 위에서 다익스트라 알고리즘으로 최단 경로를 계산합니다. 인터페이스 코스트를 구성하며(보통 대역폭을 기준으로 산정), 규모 확장을 위해 영역(Area)으로 나눕니다.
실무 포인트: 내부망(IGP)용입니다. 수렴이 빠르고 자동으로 최적 경로를 찾지만, 라우터마다 자신이 속한 영역의 링크 상태 정보를 유지하므로 대규모에서는 영역 설계가 성능을 좌우합니다.
BGP
정의: 자율 시스템(AS) 간에 경로 정보를 교환하는 경로 벡터 라우팅 프로토콜.
동작: OSPF와 목적이 다릅니다. "가장 빠른 길"이 아니라 "정책적으로 원하는 길"을 고릅니다. 각 AS는 자신이 도달 가능한 프리픽스와 AS 경로를 이웃에게 광고하고, 수신 측은 AS_PATH 길이, Local Preference, MED 등의 속성으로 우선순위를 결정합니다. 인터넷 전체의 라우팅이 이 위에서 성립합니다.
실무 포인트: BGP는 광고를 기본적으로 신뢰합니다. 그래서 잘못된 프리픽스 광고 하나가 대륙 단위 장애로 번지는 사고가 반복적으로 발생했습니다. RPKI origin validation은 프리픽스 origin AS 권한을 검증하지만 전체 AS 경로나 모든 경로 유출을 검증하는 것은 아닙니다. 클라우드 관점에서는 Direct Connect는 BGP를 사용하며 Site-to-Site VPN은 BGP 또는 지원되는 정적 라우팅을 사용하므로, AS 번호와 광고 프리픽스 설계, 그리고 이중화 시 경로 우선순위 조정(AS_PATH prepending 등)이 실제 설계 항목으로 들어옵니다.
📎 Calico가 BGP를 클러스터 내부에서 어떻게 쓰는지는 Calico BGP 심화 참고.
NAT
정의: IP 주소를 변환하고 NAPT/PAT에서는 전송 포트도 변환하는 네트워크 기능.
동작: 흔한 용도는 여러 사설 호스트가 PAT/NAPT로 공인 주소 하나를 공유하는 것입니다. 사설 주소 간 변환도 가능하므로 항상 공인 인터넷 주소 공유만을 뜻하지는 않습니다. 변환 테이블에 세션별 매핑을 유지해 응답 패킷을 올바른 내부 호스트로 되돌립니다.
실무 포인트: 계층 모델을 위반하는 대표적 존재입니다. L3 장비인데 L4 포트를 건드리고, 종단 간 연결성이라는 인터넷의 원래 전제를 깨뜨립니다. 그 결과 P2P 통신이 어려워지고, STUN/TURN 같은 우회 기법이 필요해집니다(뒤의 WebRTC 참고). 클라우드에서는 NAT Gateway의 포트 고갈과 데이터 처리 비용이 실무 이슈입니다. 아웃바운드 트래픽이 많은 워크로드라면 지원되는 AWS 서비스의 VPC 엔드포인트로 NAT 처리를 줄일 수 있지만 엔드포인트 시간/데이터 요금과 트래픽 경로를 비교해야 합니다.
검증 참고 자료
- https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/network_mtu.html
- https://www.rfc-editor.org/rfc/rfc894
- https://www.rfc-editor.org/rfc/rfc6691
- https://www.rfc-editor.org/rfc/rfc4638
- https://www.rfc-editor.org/rfc/rfc5227
- https://www.rfc-editor.org/rfc/rfc792
- https://www.rfc-editor.org/rfc/rfc8899
- https://www.rfc-editor.org/rfc/rfc2328
- https://www.rfc-editor.org/rfc/rfc6811
- https://docs.kernel.org/networking/bridge.html
- https://docs.aws.amazon.com/vpc/latest/userguide/VPC_Internet_Gateway.html
- https://docs.aws.amazon.com/vpc/latest/userguide/egress-only-internet-gateway.html
- https://docs.aws.amazon.com/vpn/latest/s2svpn/VPNRoutingTypes.html
- https://docs.aws.amazon.com/vpc/latest/userguide/nat-gateway-scenarios.html
- https://docs.aws.amazon.com/vpc/latest/userguide/nat-gateway-pricing.html