Kubernetes 스케줄링, 선점 및 축출
지원 버전: Kubernetes 1.34 - 1.36 (Descheduler v0.36 예시) 마지막 업데이트: 2026년 9월 17일
Kubernetes에서 스케줄링은 포드를 적절한 노드에 배치하는 과정입니다. 선점은 우선순위가 높은 포드를 위해 우선순위가 낮은 포드를 제거하는 과정이며, 축출은 파드를 종료하며 워크로드 컨트롤러가 생성한 대체 파드를 스케줄러가 별도로 배치할 수 있습니다. 이 장에서는 Kubernetes의 스케줄링 메커니즘, 노드 선택, 선점, 축출 등의 개념과 Amazon EKS에서의 스케줄링 최적화 방법에 대해 알아보겠습니다.
실습 환경 설정
이 문서의 예제를 따라하기 위해서는 다음과 같은 도구와 환경이 필요합니다:
필수 도구
- API 서버와 마이너 버전 차이가 1 이내인 kubectl
- 작동하는 Kubernetes 클러스터 (EKS, minikube, kind 등)
- 여러 노드가 있는 클러스터 (스케줄링 테스트용)
스케줄링 예제 설정
# 네임스페이스 생성
kubectl create namespace scheduling-demo

# 노드에 레이블 추가 (여러 노드가 있는 경우)
kubectl label nodes <node-name> disktype=ssd
kubectl label nodes <node-name> gpu=true

# 노드 어피니티를 사용하는 파드 생성
kubectl -n scheduling-demo apply -f - <<EOF
apiVersion: v1
kind: Pod
metadata:
  name: nginx-ssd
  labels:
    app: nginx
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: disktype
            operator: In
            values:
            - ssd
  containers:
  - name: nginx
    image: nginx
EOF

# 우선순위 클래스 생성
kubectl apply -f - <<EOF
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical service pods only."
EOF

# 포드 중단 예산(PDB) 생성
kubectl -n scheduling-demo apply -f - <<EOF
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: nginx-pdb
spec:
  minAvailable: 1
  selector:
    matchLabels:
      app: nginx
EOF
Kubernetes 스케줄링 아키텍처
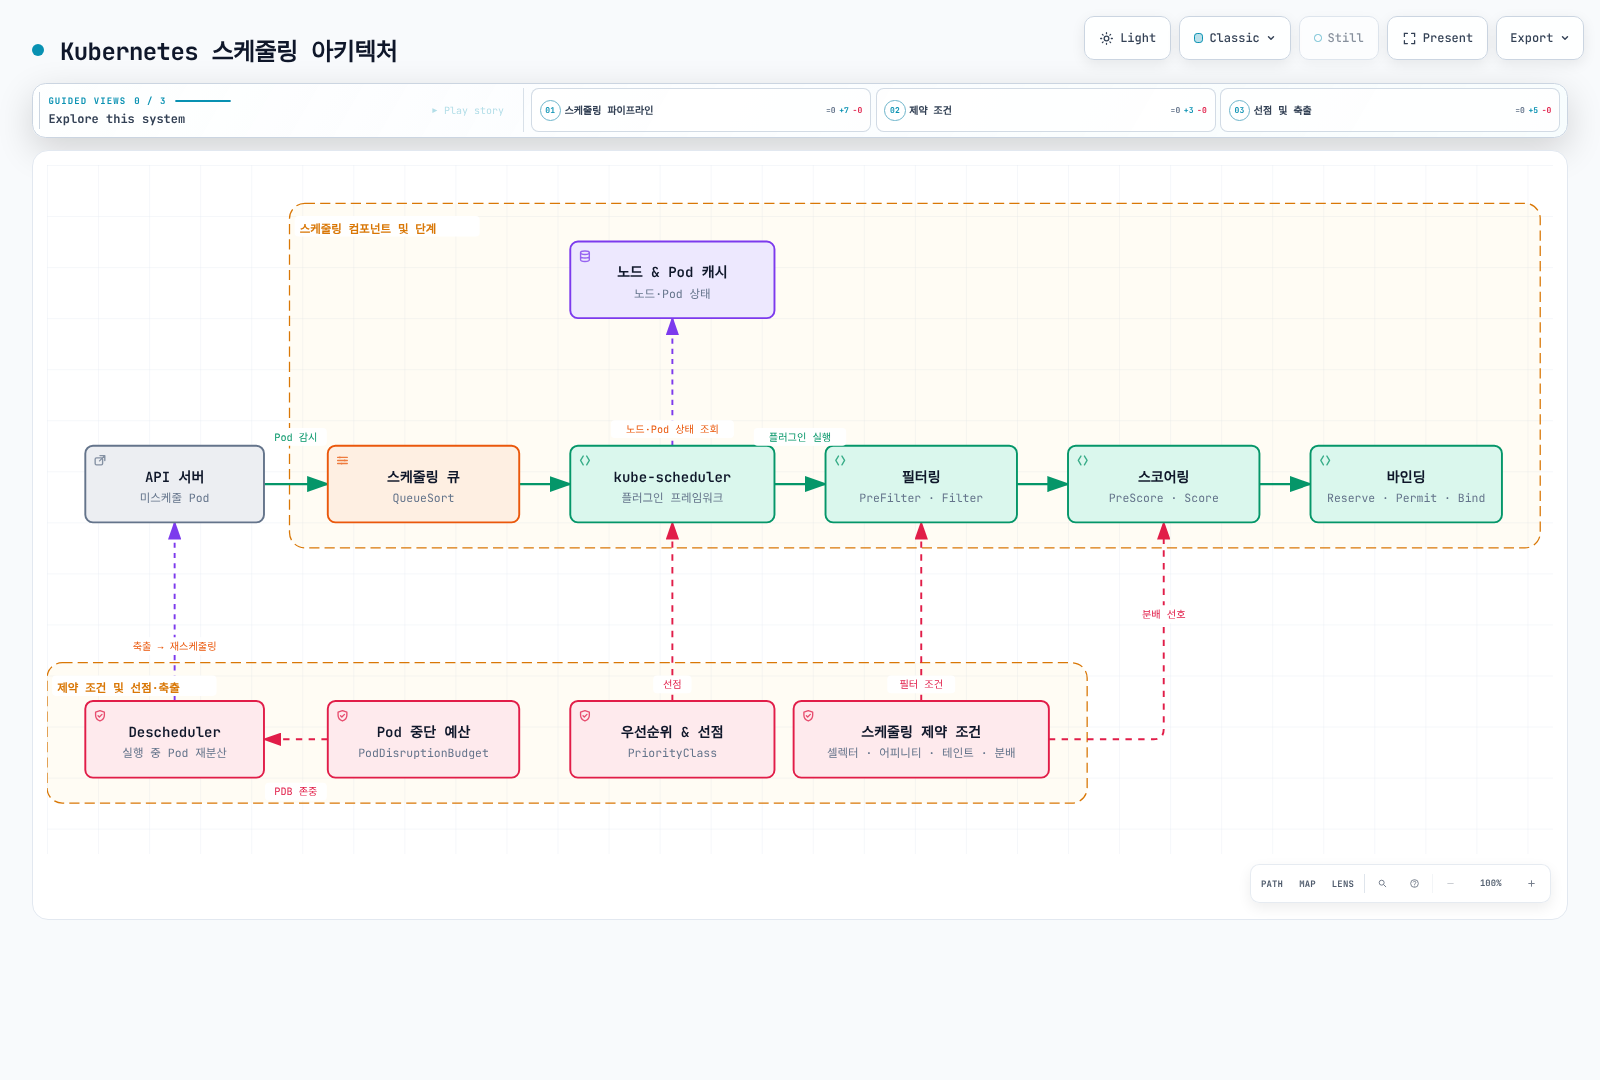
스케줄링 개념 비교
| 개념 | 목적 | 사용 사례 | Kubernetes 버전 |
|---|---|---|---|
| 노드 셀렉터 | 특정 레이블이 있는 노드에 포드 배치 | 간단한 노드 선택 | 모든 버전 |
| 노드 어피니티 | 복잡한 노드 선택 규칙 정의 | 고급 노드 선택 | 1.6+ |
| 포드 어피니티 | 다른 포드와 가까이 배치 | 관련 서비스 공동 배치 | 1.6+ |
| 포드 안티-어피니티 | 다른 포드와 멀리 배치 | 고가용성 보장 | 1.6+ |
| 테인트와 톨러레이션 | 특정 포드만 노드에 배치 허용 | 전용 노드, 노드 격리 | 1.6+ |
| 토폴로지 분배 제약 | 토폴로지 도메인 간 포드 분산 | 가용 영역 간 분산 | 1.16+ (1.19에서 GA) |
| 우선순위 및 선점 | 중요 워크로드 우선 배치 | 중요 서비스 보장 | 1.8+ (1.11에서 GA) |
| 포드 중단 예산 | 동시에 중단되는 포드 수 제한 | 고가용성 보장 | 1.4+ (1.21에서 GA) |
스케줄링 기본 개념
핵심 개념: Kubernetes 스케줄러는 포드를 실행할 최적의 노드를 선택하는 컨트롤 플레인 컴포넌트로, 필터링과 스코어링 두 단계로 작동합니다.
스케줄링 프로세스
필터링 단계 (Predicates)
- 포드를 실행할 수 있는 적합한 노드 집합 식별
- 리소스 요구사항, 노드 셀렉터, 어피니티 규칙, 테인트/톨러레이션 등 고려
- 하나의 조건이라도 충족하지 못하면 노드 제외
스코어링 단계 (Priorities)
- 필터링을 통과한 노드에 점수 부여
- 리소스 사용률, 포드 간 분산, 어피니티 선호도 등 고려
- 가장 높은 점수를 받은 노드 선택
바인딩 단계
- 선택된 노드에 포드 할당
- API 서버에 바인딩 정보 업데이트
목차
- 스케줄링 개요
- 스케줄러 작동 방식
- 노드 선택
- 포드 어피니티와 안티-어피니티
- 테인트와 톨러레이션
- 노드 어피니티
- 포드 우선순위와 선점
- 포드 축출
- 포드 중단 예산(PDB)
- 노드 압력 축출
- 토폴로지 분배 제약 조건(TopologySpreadConstraints)
- Pod Deletion Cost
- Descheduler
- Amazon EKS에서의 스케줄링 최적화
- 스케줄링 모범 사례
- 결론
스케줄링 개요
Kubernetes 스케줄러는 포드를 적절한 노드에 배치하는 컨트롤 플레인 컴포넌트입니다. 스케줄러는 다양한 요소를 고려하여 포드를 배치할 최적의 노드를 결정합니다:
- 리소스 요구 사항: 포드가 요청한 CPU, 메모리 등의 리소스
- 하드웨어/소프트웨어/정책 제약 조건: 노드 셀렉터, 노드 어피니티, 테인트 등
- 어피니티/안티-어피니티 명세: 다른 포드와의 배치 관계
- 데이터 지역성: 데이터에 가까운 곳에 포드 배치
- 워크로드 간 간섭: 다양한 워크로드 간의 간섭 최소화
- 사용자 정의 목표: 앱 데드라인·워크로드 간 간섭을 인식하는 배치는 별도 로직이 필요하며 기본 스케줄러가 앱 데드라인을 추론하지는 않음
스케줄링 프로세스
스케줄링 프로세스는 크게 두 단계로 나뉩니다:
필터링(Filtering): 포드를 실행할 수 있는 노드 집합을 식별
- 리소스 요구 사항 충족 여부 확인
- 노드 셀렉터, 어피니티, 테인트 등의 제약 조건 확인
스코어링(Scoring): 필터링된 노드에 점수를 매겨 최적의 노드 선택
- 리소스 사용률 균형
- 포드 간 어피니티/안티-어피니티
- 데이터 지역성
- 테인트/톨러레이션
스케줄러 작동 방식
Kubernetes 스케줄러는 다음과 같은 과정으로 작동합니다:
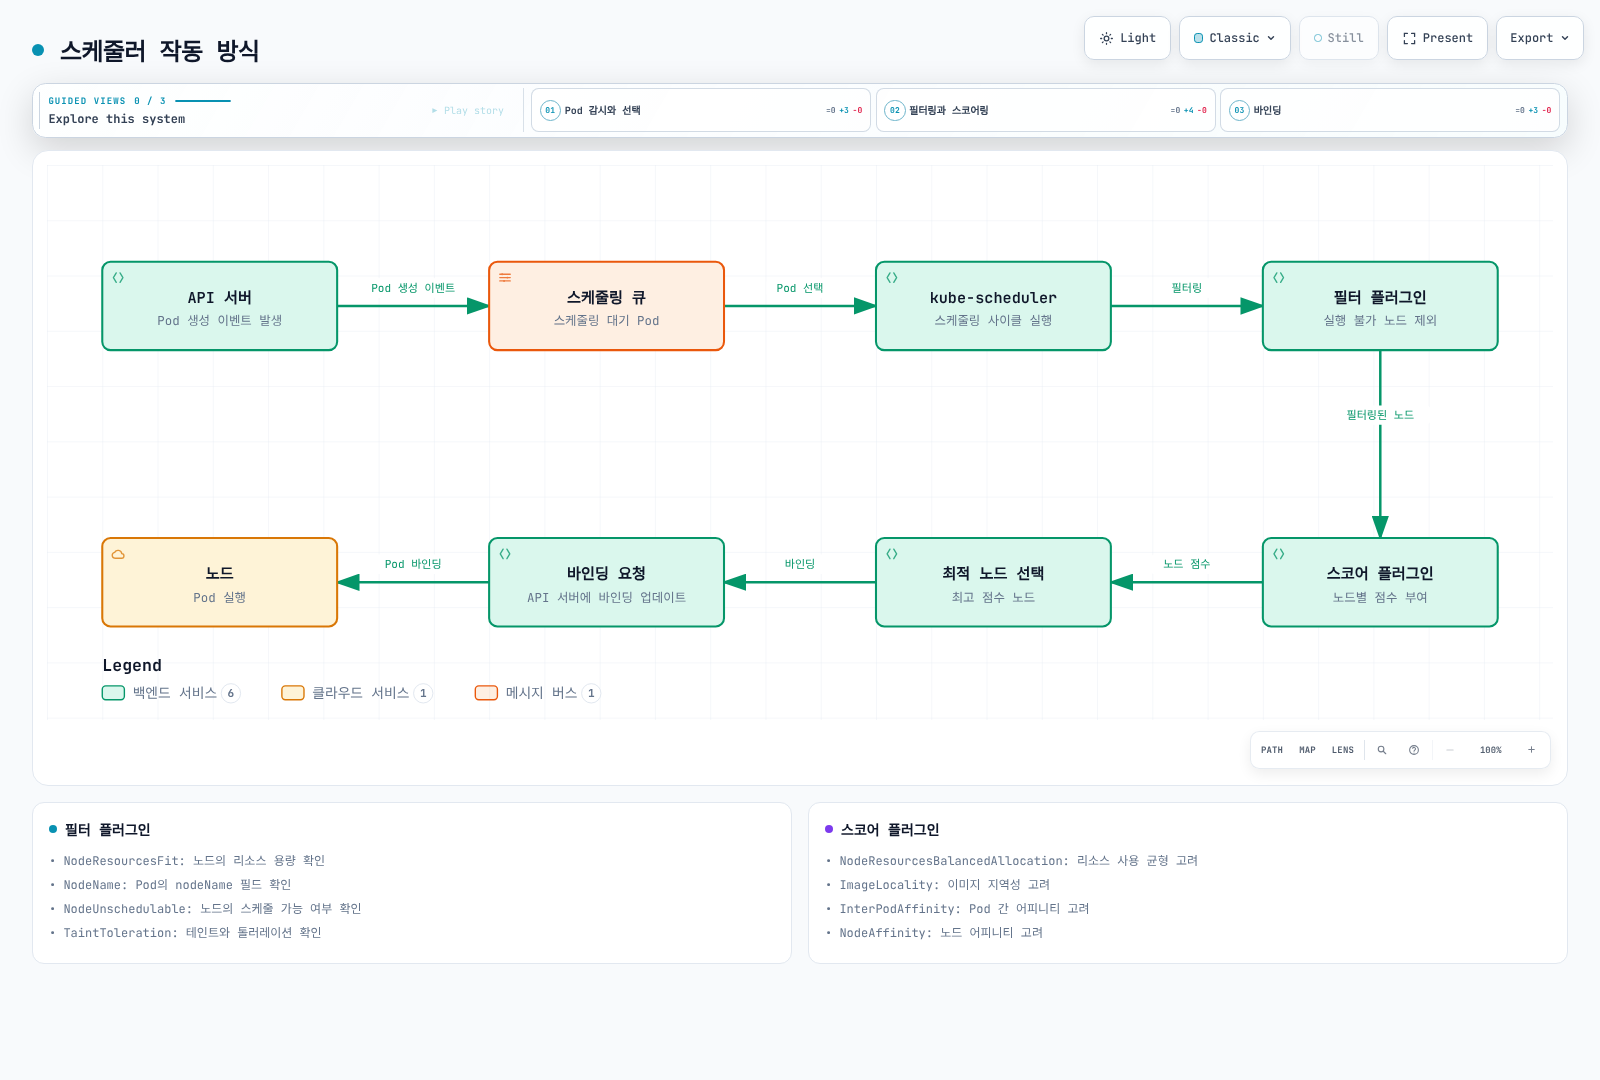
- 포드 큐 감시: 스케줄러는 API 서버를 감시하여 스케줄링되지 않은 포드를 찾습니다.
- 노드 필터링: 포드를 실행할 수 있는 노드 집합을 식별합니다.
- 노드 스코어링: 필터링된 노드에 점수를 매깁니다.
- 노드 선택: 가장 높은 점수를 받은 노드를 선택합니다.
- 바인딩: 선택된 노드에 포드를 바인딩합니다.
스케줄링 플러그인
Kubernetes 스케줄러는 플러그인 아키텍처를 사용하여 확장 가능하게 설계되었습니다. 다양한 플러그인이 스케줄링 프로세스의 여러 단계에서 작동합니다:
필터 플러그인: 포드를 실행할 수 없는 노드를 필터링
- NodeResourcesFit: 노드의 리소스 용량 확인
- NodeName: 포드의 nodeName 필드 확인
- NodeUnschedulable: 노드의 스케줄 가능 여부 확인
- TaintToleration: 테인트와 톨러레이션 확인
스코어 플러그인: 노드에 점수 부여
- NodeResourcesBalancedAllocation: 리소스 사용 균형 고려
- ImageLocality: 이미지 지역성 고려
- InterPodAffinity: 포드 간 어피니티 고려
- NodeAffinity: 노드 어피니티 고려
NodeResourcesFit 스코어링 전략: LeastAllocated vs. MostAllocated
NodeResourcesFit은 필터 플러그인(노드에 포드가 요청한 CPU/메모리를 수용할 여력이 있는지 확인)이자 스코어 플러그인입니다. 스코어 플러그인으로서의 동작은 KubeSchedulerConfiguration의 scoringStrategy.type으로 제어합니다.
LeastAllocated(기본값): 이미 적게 할당된 노드일수록 높은 점수를 줍니다. 새 포드는 가장 비어 있는 노드로 유도되어 부하가 고르게 분산됩니다.MostAllocated: 포드가 들어갈 여력이 있는 한, 이미 많이 할당된 노드일수록 높은 점수를 줍니다. 새 포드는 가장 바쁜 노드부터 채워지고 다른 노드는 비워둔 채로 남습니다.RequestedToCapacityRatio: 두 전략 사이를 원하는 곡선으로 설정할 수 있는 구성형 전략으로, GPU 같은 확장 리소스에 단순 최소/최대가 아닌 커스텀 형태가 필요할 때 유용합니다.
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
- schedulerName: most-allocated-scheduler
  pluginConfig:
  - name: NodeResourcesFit
    args:
      scoringStrategy:
        type: MostAllocated
        resources:
        - name: cpu
          weight: 1
        - name: memory
          weight: 1
Amazon EKS는 컨트롤 플레인이 완전관리형이므로 기본 kube-scheduler의 KubeSchedulerConfiguration을 직접 수정할 수 없습니다. MostAllocated를 쓰려면 해당 설정을 가진 kube-scheduler 바이너리를 두 번째 스케줄러(전용 ServiceAccount를 system:kube-scheduler/system:volume-scheduler에 바인딩한 Deployment)로 띄우고, 아래 다중 스케줄러에서 설명하는 것처럼 특정 포드에서 spec.schedulerName으로 지정해야 합니다. 이는 커스텀 스케줄러 만들기에서 사용한 것과 같은 패턴입니다.
실제 검증 테스트 — 분산 vs. 빈패킹 동작. 실제 차이를 확인하기 위해 워커 노드 3개짜리 임시 kind 클러스터(kubectl version v1.37.0, 완전히 격리되어 있으며 테스트 후 즉시 삭제 — 공유 인프라에는 영향 없음)를 만들고, nodeName으로 고정한 필러(filler) 포드로 노드별 사전 부하를 불균등하게 만들었습니다(노드당 할당 가능 CPU 16코어): worker=12개 포드(75%), worker2=6개 포드(37%), worker3=0개 포드(0%). 이 상태에서 동일한 1코어 포드 6개를 두 번 스케줄링했습니다 — 한 번은 기본 스케줄러(LeastAllocated)로, 한 번은 MostAllocated로 설정한 두 번째 스케줄러로.
| 스케줄러 / 전략 | 새 포드 6개가 배치된 곳 | 최종 CPU 사용률 (worker / worker2 / worker3) |
|---|---|---|
기본값 (LeastAllocated) | 가장 비어 있던 worker3에 6개 전부 배치 | 75% / 37% / 37% — 세 노드 모두 사용 중 |
MostAllocated | 가장 바쁜 두 노드에 분산: worker에 3개, worker2에 3개 | 93% / 56% / 0% — worker3는 완전히 그대로 유지 |
LeastAllocated는 worker3의 사용률을 worker2와 같아질 때까지 끌어올려서 결국 세 노드 모두 일부라도 사용 중인 상태가 되어, 어느 노드도 안전하게 스케일 다운할 수 없게 됩니다. 반면 MostAllocated는 이미 바쁜 노드에 계속 부하를 집중시켜 worker3를 완전히 비워둔 채로 남겼습니다 — 이는 클러스터 오토스케일러나 Karpenter의 통합(consolidation) 로직이 바로 종료 대상으로 삼을 노드입니다.
이런 이유로 Karpenter나 Cluster Autoscaler와 함께 실행되는 배치/단명 Job 워크로드에는 MostAllocated가 흔히 권장됩니다. Job을 적은 수의 노드에 빈패킹하면 완전히 비게 되는 노드 수가 늘어나 통합(consolidation) 대상이 되기 쉬워지고, 이는 곧바로 컴퓨팅 비용 절감으로 이어집니다. 반면 장시간 실행되는 지연 민감형 서비스에는 여전히 LeastAllocated가 더 나은 기본값입니다 — 부하를 분산해 두면 모든 노드에 여유 공간이 남아 트래픽 급증이나 kubectl drain 시 한 노드에만 부하가 쏠려 연쇄적인 압박이 생기는 것을 막을 수 있습니다.
이 비교를 직접 단계별로 재현해 보려면 스케줄러 스코어링 전략 실습을 참고하세요.
다중 스케줄러
Kubernetes는 여러 스케줄러를 동시에 실행할 수 있습니다. 이를 통해 특정 워크로드에 대해 사용자 정의 스케줄링 로직을 구현할 수 있습니다.
apiVersion: v1
kind: Pod
metadata:
  name: custom-scheduled-pod
spec:
  schedulerName: my-custom-scheduler
  containers:
  - name: container
    image: nginx
위 예시에서 schedulerName 필드를 사용하여 포드를 스케줄링할 스케줄러를 지정합니다.
노드 선택
Kubernetes는 포드를 특정 노드에 배치하기 위한 여러 메커니즘을 제공합니다.
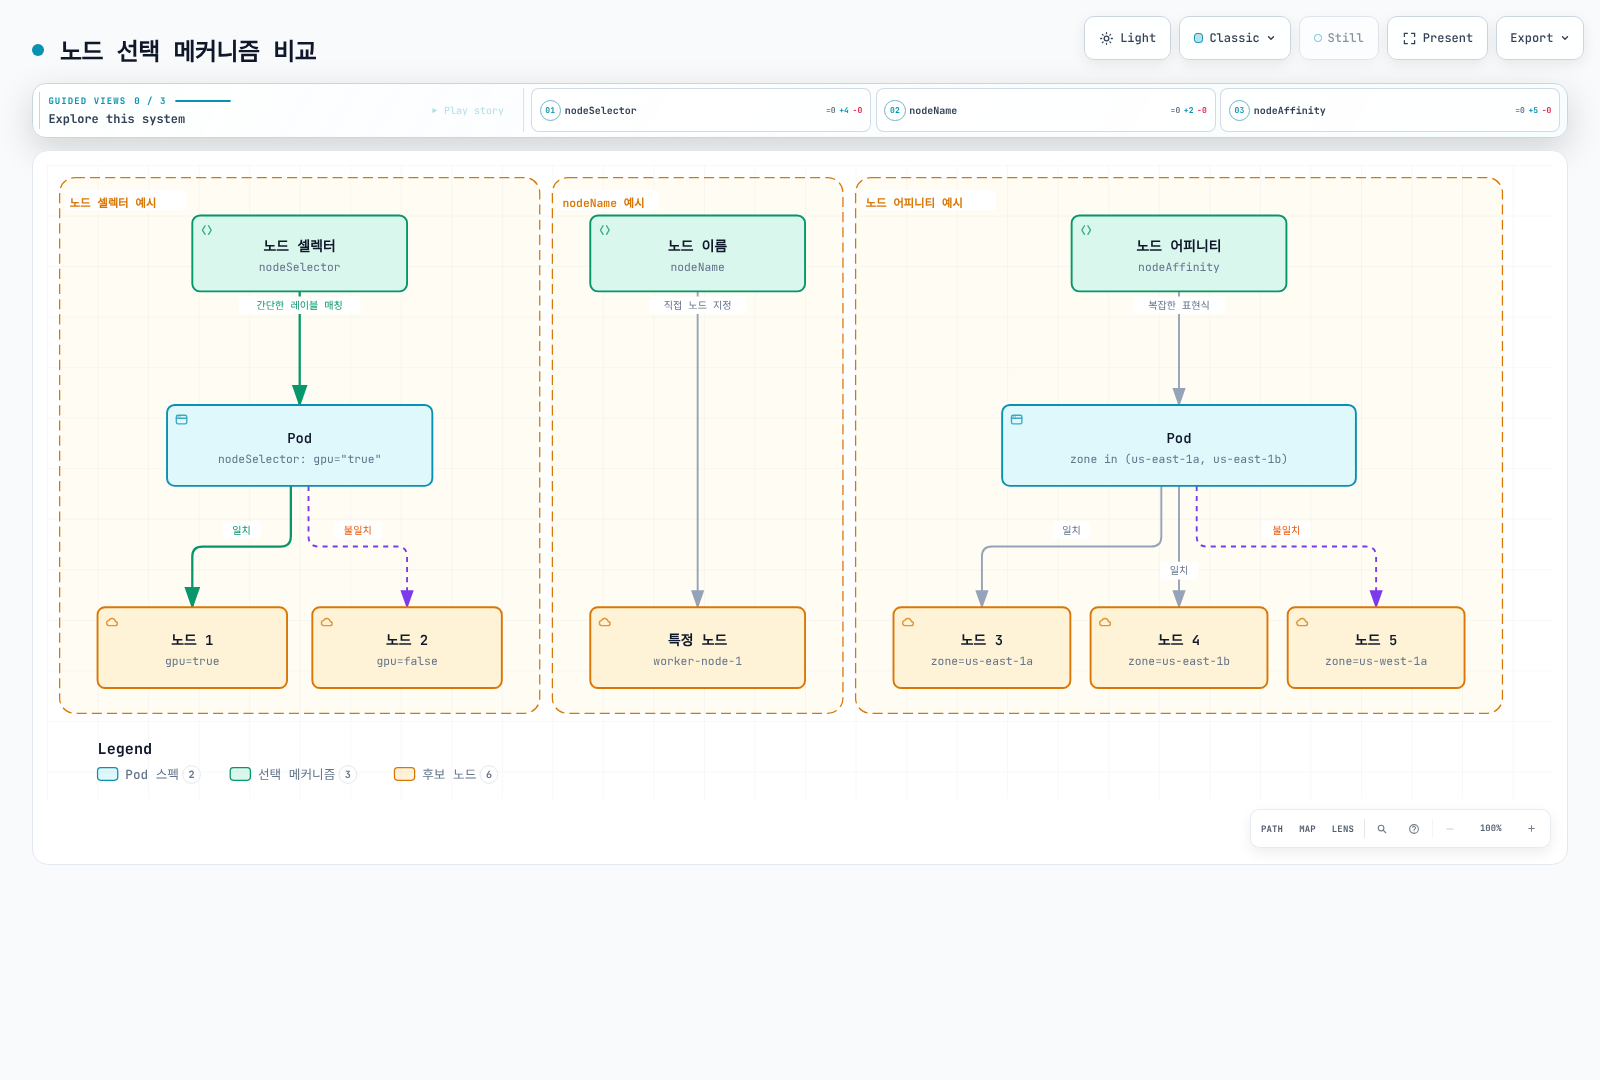
노드 셀렉터(Node Selector)
노드 셀렉터는 포드를 특정 레이블이 있는 노드에만 배치하도록 제한하는 가장 간단한 방법입니다.
apiVersion: v1
kind: Pod
metadata:
  name: gpu-pod
spec:
  nodeSelector:
    gpu: "true"
  containers:
  - name: gpu-container
    image: busybox:1.36
    command: ["sh", "-c", "sleep 3600"]
    resources:
      limits:
        nvidia.com/gpu: 1
위 예시에서 포드는 gpu=true 레이블이 있는 노드에만 배치됩니다.
GPU 예시는 스케줄링 확인용입니다. 실제 GPU와 nvidia.com/gpu를 광고하는 동작 중인 장치 플러그인이 필요하며 gpu=true 레이블만으로 GPU를 할당하지는 않습니다.
nodeName
nodeName 필드를 사용하여 포드를 특정 노드에 직접 배치할 수 있습니다. 이 방법은 스케줄러를 우회하므로 일반적으로 권장되지 않습니다.
apiVersion: v1
kind: Pod
metadata:
  name: specific-node-pod
spec:
  nodeName: worker-node-1
  containers:
  - name: container
    image: nginx
위 예시에서 포드는 worker-node-1이라는 이름의 노드에 직접 배치됩니다.
포드 어피니티와 안티-어피니티
포드 어피니티와 안티-어피니티는 포드 간의 관계를 기반으로 포드를 배치하는 방법을 제공합니다.
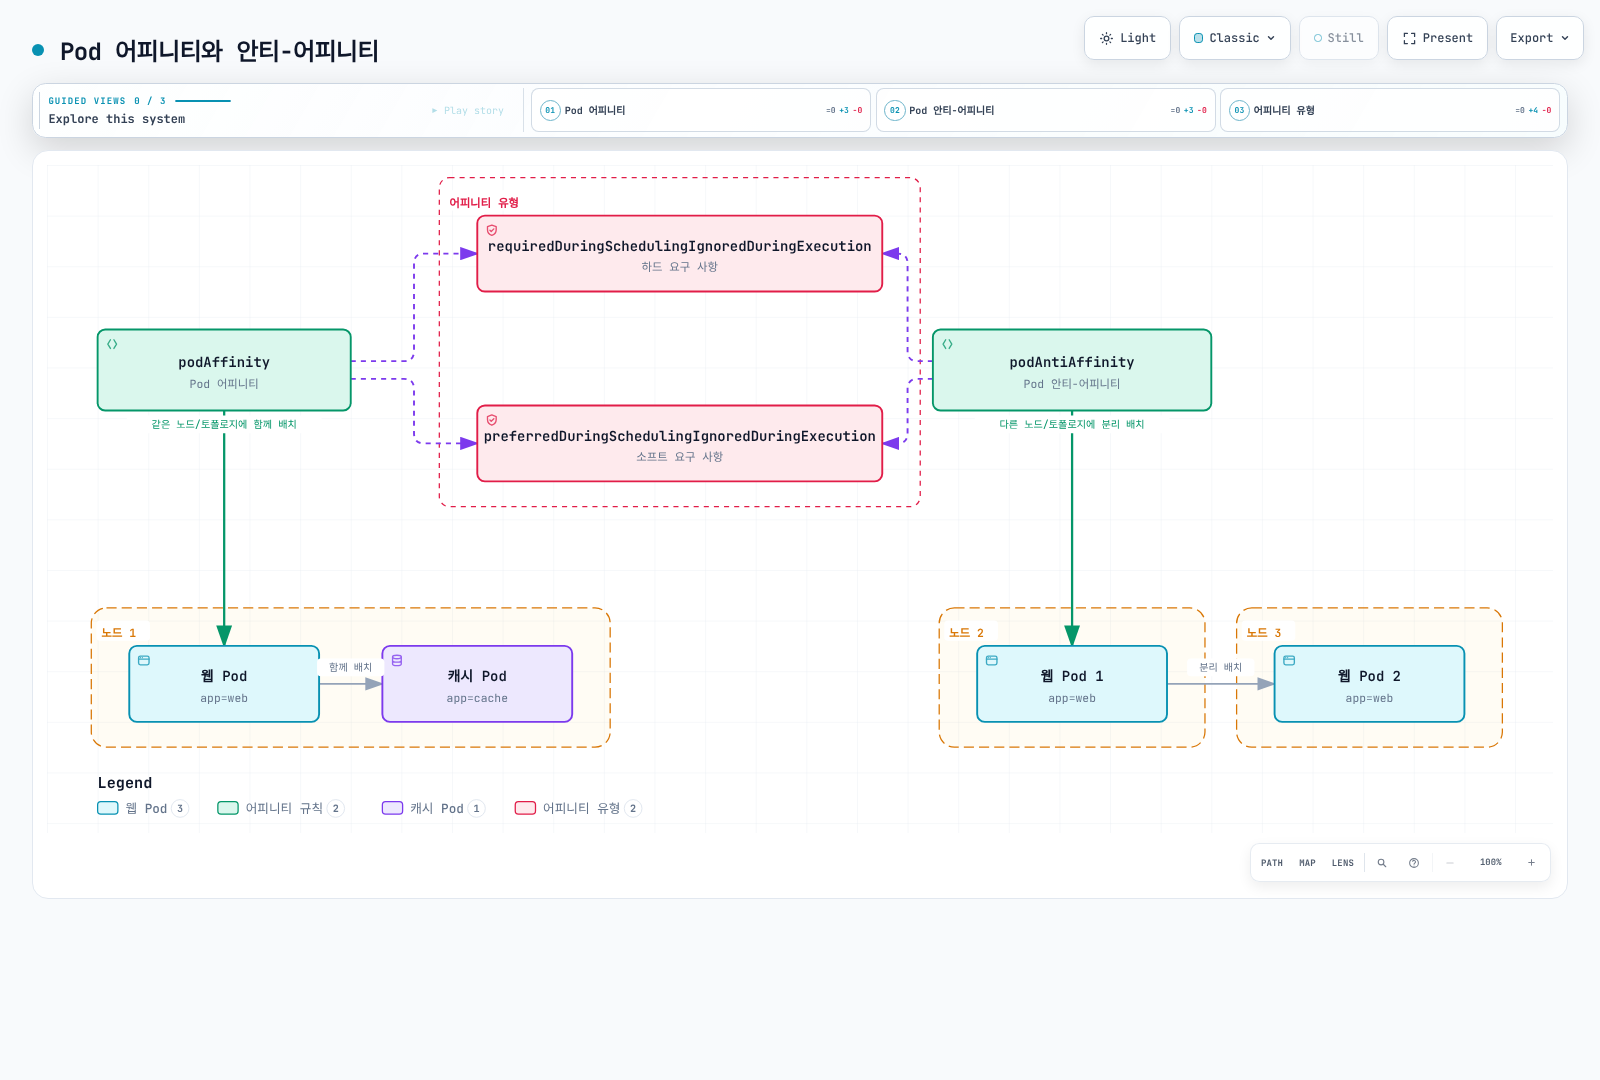
포드 어피니티(Pod Affinity)
포드 어피니티는 특정 레이블을 가진 포드와 같은 노드 또는 토폴로지 도메인에 포드를 배치하도록 합니다.
apiVersion: v1
kind: Pod
metadata:
  name: frontend
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: kubernetes.io/hostname
  containers:
  - name: frontend
    image: nginx
위 예시에서 frontend 포드는 app=cache 레이블이 있는 포드와 같은 호스트에 배치됩니다.
포드 안티-어피니티(Pod Anti-Affinity)
포드 안티-어피니티는 특정 레이블을 가진 포드와 다른 노드 또는 토폴로지 도메인에 포드를 배치하도록 합니다.
apiVersion: v1
kind: Pod
metadata:
  name: frontend
  labels:
    app: frontend
spec:
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - frontend
        topologyKey: kubernetes.io/hostname
  containers:
  - name: frontend
    image: nginx
위 예시에서 frontend 포드는 다른 app=frontend 레이블이 있는 포드와 다른 호스트에 배치됩니다. 이는 고가용성을 위해 같은 애플리케이션의 인스턴스를 여러 노드에 분산시키는 데 유용합니다.
어피니티 유형
포드 어피니티와 안티-어피니티는 두 가지 유형이 있습니다:
- requiredDuringSchedulingIgnoredDuringExecution: 스케줄링 시 반드시 충족해야 하는 하드 요구 사항
- preferredDuringSchedulingIgnoredDuringExecution: 가능하면 충족하는 것이 좋지만, 필수는 아닌 소프트 요구 사항
# preferredDuringSchedulingIgnoredDuringExecution 예시
affinity:
  podAffinity:
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 100
      podAffinityTerm:
        labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: kubernetes.io/hostname
위 예시에서 weight 필드는 이 선호도의 가중치를 나타냅니다. 여러 선호도가 있을 경우 가중치가 높은 선호도가 더 중요하게 고려됩니다.
테인트와 톨러레이션
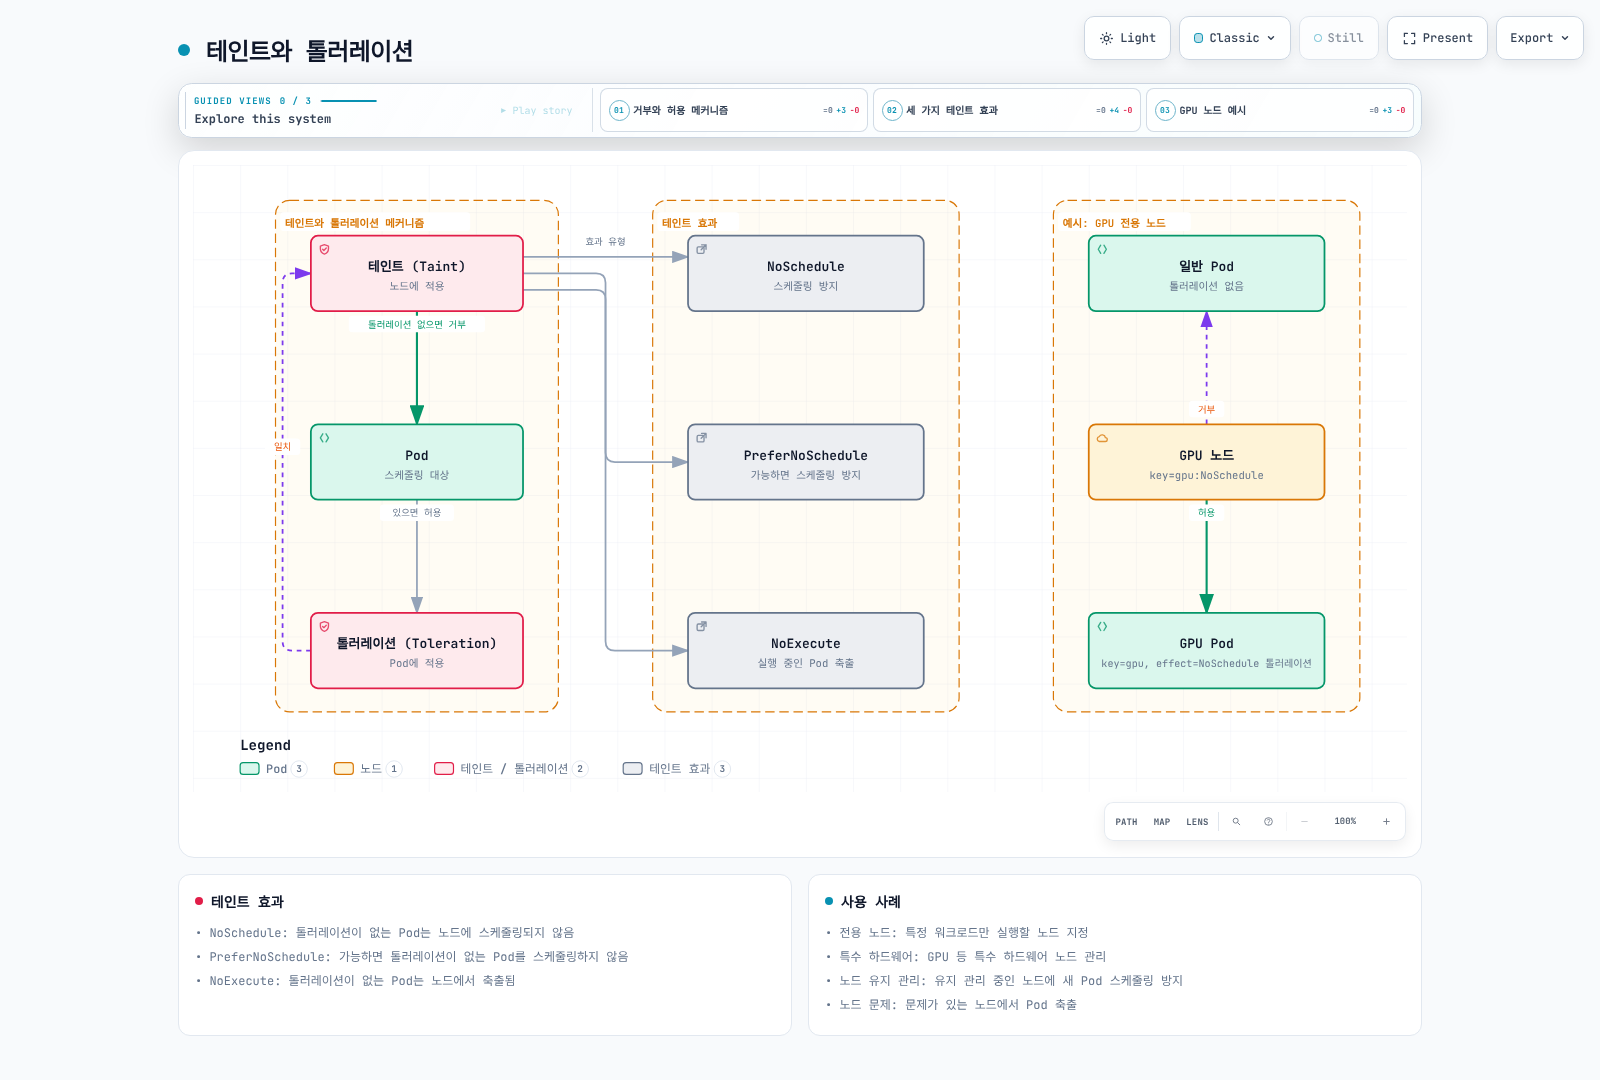
테인트(Taint)와 톨러레이션(Toleration)은 노드가 특정 포드를 거부할 수 있게 하는 메커니즘입니다.
테인트(Taint)
테인트는 노드에 적용되어 포드가 해당 노드에 스케줄링되는 것을 제한합니다.
# 노드에 테인트 추가
kubectl taint nodes node1 key=value:NoSchedule
테인트 효과(Effect)는 세 가지가 있습니다:
- NoSchedule: 톨러레이션이 없는 포드는 노드에 스케줄링되지 않음
- PreferNoSchedule: 가능하면 톨러레이션이 없는 포드를 노드에 스케줄링하지 않음
- NoExecute: 톨러레이션이 없는 포드는 노드에서 축출됨
톨러레이션(Toleration)
톨러레이션은 포드에 적용되어 테인트가 있는 노드에 스케줄링될 수 있게 합니다.
apiVersion: v1
kind: Pod
metadata:
  name: nginx
spec:
  tolerations:
  - key: "key"
    operator: "Equal"
    value: "value"
    effect: "NoSchedule"
  containers:
  - name: nginx
    image: nginx
위 예시에서 포드는 key=value:NoSchedule 테인트가 있는 노드에 스케줄링될 수 있습니다.
사용 사례
테인트와 톨러레이션의 일반적인 사용 사례는 다음과 같습니다:
- 전용 노드: 특정 워크로드만 실행할 노드 지정
- 특수 하드웨어: GPU와 같은 특수 하드웨어가 있는 노드 관리
- 노드 유지 관리: 유지 관리 중인 노드에서 새 포드 스케줄링 방지
- 노드 문제: 문제가 있는 노드에서 포드 축출
기본 테인트
Kubernetes는 일부 노드에 기본 테인트를 적용합니다:
- node.kubernetes.io/not-ready: 노드가 준비되지 않음
- node.kubernetes.io/unreachable: 노드에 도달할 수 없음
- node.kubernetes.io/memory-pressure: 노드에 메모리 압력이 있음
- node.kubernetes.io/disk-pressure: 노드에 디스크 압력이 있음
- node.kubernetes.io/pid-pressure: 노드에 PID 압력이 있음
- node.kubernetes.io/network-unavailable: 노드의 네트워크가 사용 불가능함
- node.kubernetes.io/unschedulable: 노드가 스케줄 불가능함
노드 어피니티
노드 어피니티는 포드를 특정 노드 집합에 배치하는 보다 표현력이 풍부한 방법을 제공합니다. 노드 셀렉터보다 더 복잡한 조건을 지정할 수 있습니다.
노드 어피니티 유형
노드 어피니티는 두 가지 유형이 있습니다:
- requiredDuringSchedulingIgnoredDuringExecution: 스케줄링 시 반드시 충족해야 하는 하드 요구 사항
- preferredDuringSchedulingIgnoredDuringExecution: 가능하면 충족하는 것이 좋지만, 필수는 아닌 소프트 요구 사항
apiVersion: v1
kind: Pod
metadata:
  name: with-node-affinity
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: topology.kubernetes.io/zone
            operator: In
            values:
            - us-west-2a
            - us-west-2b
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        preference:
          matchExpressions:
          - key: another-node-label-key
            operator: In
            values:
            - another-node-label-value
  containers:
  - name: with-node-affinity
    image: nginx
위 예시에서 포드는 topology.kubernetes.io/zone 레이블이 us-west-2a 또는 us-west-2b인 노드에만 배치됩니다. 또한 가능하면 another-node-label-key=another-node-label-value 레이블이 있는 노드에 배치됩니다.
연산자
노드 어피니티는 다양한 연산자를 지원합니다:
- In: 레이블 값이 지정된 값 중 하나와 일치
- NotIn: 레이블 값이 지정된 값과 일치하지 않음
- Exists: 지정된 키를 가진 레이블이 존재
- DoesNotExist: 지정된 키를 가진 레이블이 존재하지 않음
- Gt: 레이블 값이 지정된 값보다 큼
- Lt: 레이블 값이 지정된 값보다 작음
포드 우선순위와 선점
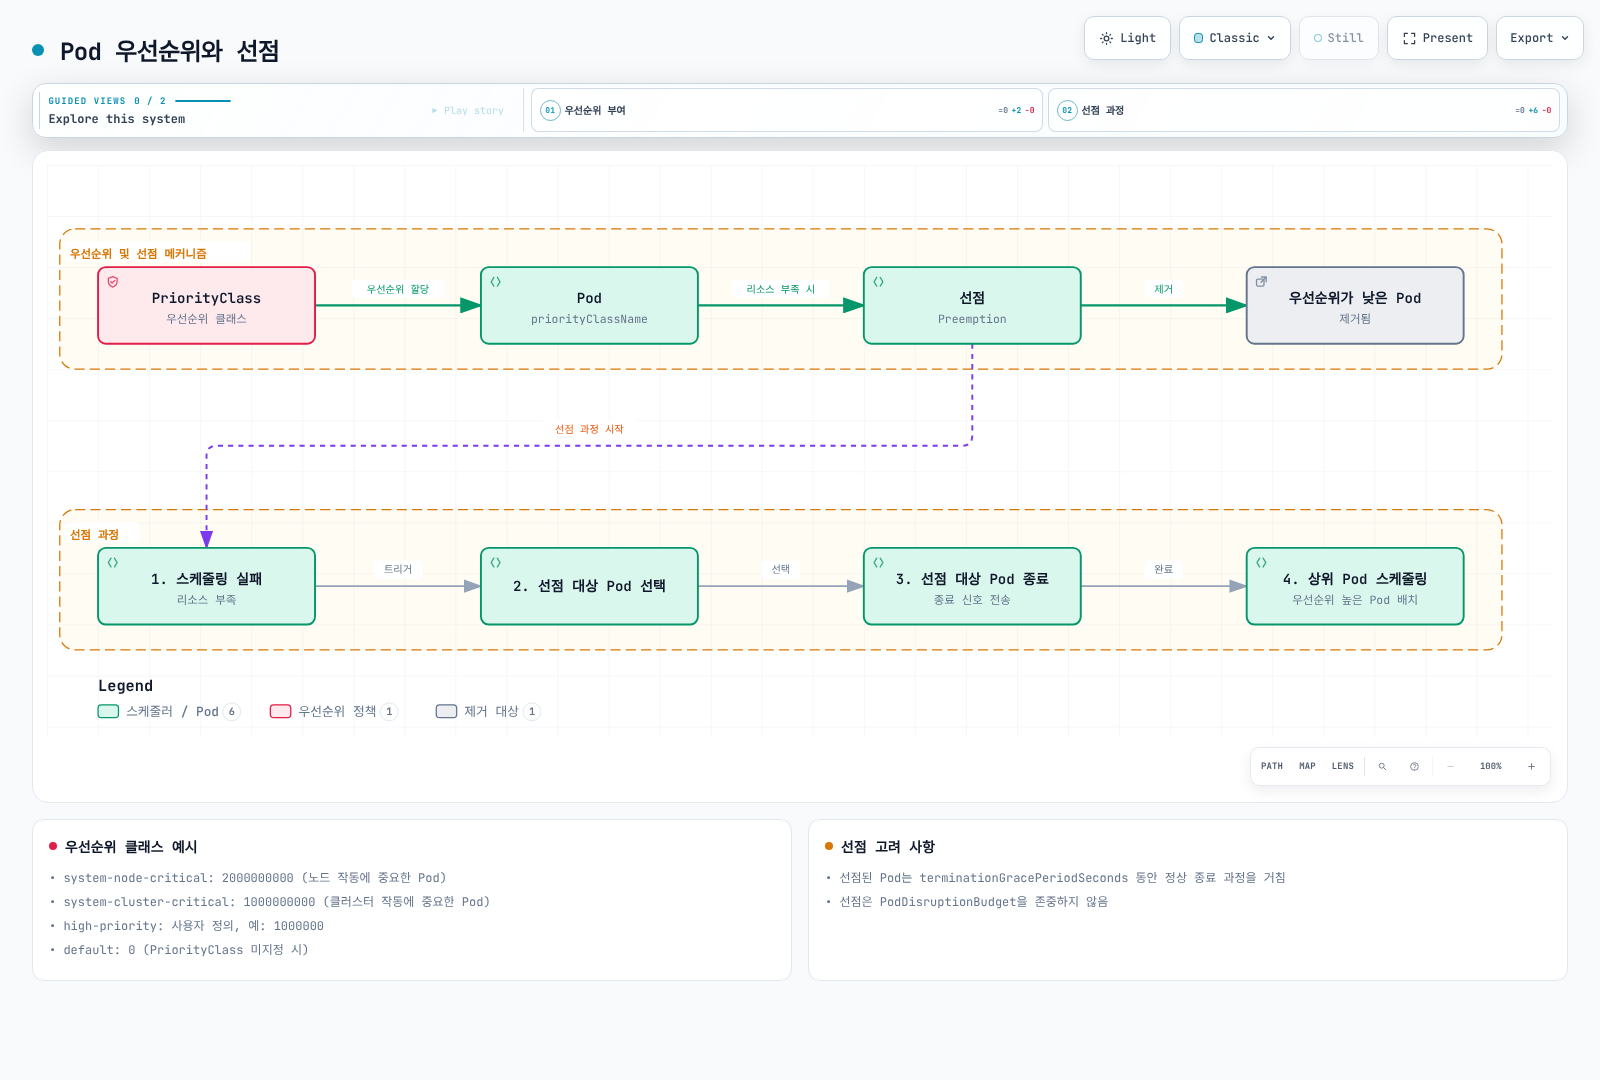
Kubernetes는 포드 우선순위와 선점(Preemption) 기능을 통해 중요한 워크로드가 클러스터 리소스를 확보할 수 있도록 합니다.
우선순위 클래스(PriorityClass)
우선순위 클래스는 포드의 상대적 중요도를 정의합니다. 우선순위 값이 높을수록 포드의 중요도가 높습니다.
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "이 우선순위 클래스는 중요한 워크로드에 사용해야 합니다."
위 예시에서 value 필드는 우선순위 값을 나타냅니다. 값이 클수록 우선순위가 높습니다. globalDefault 필드가 true로 설정되면, 우선순위 클래스가 지정되지 않은 포드에 이 우선순위 클래스가 적용됩니다.
포드에 우선순위 클래스 적용
포드에 우선순위 클래스를 적용하려면 priorityClassName 필드를 사용합니다.
apiVersion: v1
kind: Pod
metadata:
  name: high-priority-pod
spec:
  priorityClassName: high-priority
  containers:
  - name: container
    image: nginx
선점(Preemption)
선점은 우선순위가 높은 포드를 스케줄링하기 위해 우선순위가 낮은 포드를 제거하는 과정입니다. 스케줄러가 우선순위가 높은 포드를 스케줄링할 노드를 찾지 못하면, 우선순위가 낮은 포드를 선점하여 리소스를 확보합니다.
선점 과정:
- 스케줄러가 우선순위가 높은 포드를 스케줄링할 노드를 찾지 못함
- 스케줄러가 우선순위가 낮은 포드를 선점하여 제거할 노드를 선택
- API를 통해 선택한 낮은 우선순위 파드 삭제를 요청하며 실제 종료는 kubelet·런타임이 수행
- 포드가 정상적으로 종료되면 우선순위가 높은 포드를 해당 노드에 스케줄링
선점 고려 사항
선점을 사용할 때 고려해야 할 사항:
- 그레이스풀 종료 기간: 선점된 포드는
terminationGracePeriodSeconds에 지정된 시간 동안 정상 종료 과정을 거침 - PodDisruptionBudget: 스케줄러가 위반을 피하려고 하지만 적절한 대상을 찾지 못하면 PDB를 위반하며 선점할 수 있음
- 시스템 우선순위 클래스: Kubernetes는 시스템 컴포넌트를 위한 우선순위 클래스를 제공
system-cluster-critical: 클러스터 작동에 중요한 포드system-node-critical: 노드 작동에 중요한 포드
포드 축출
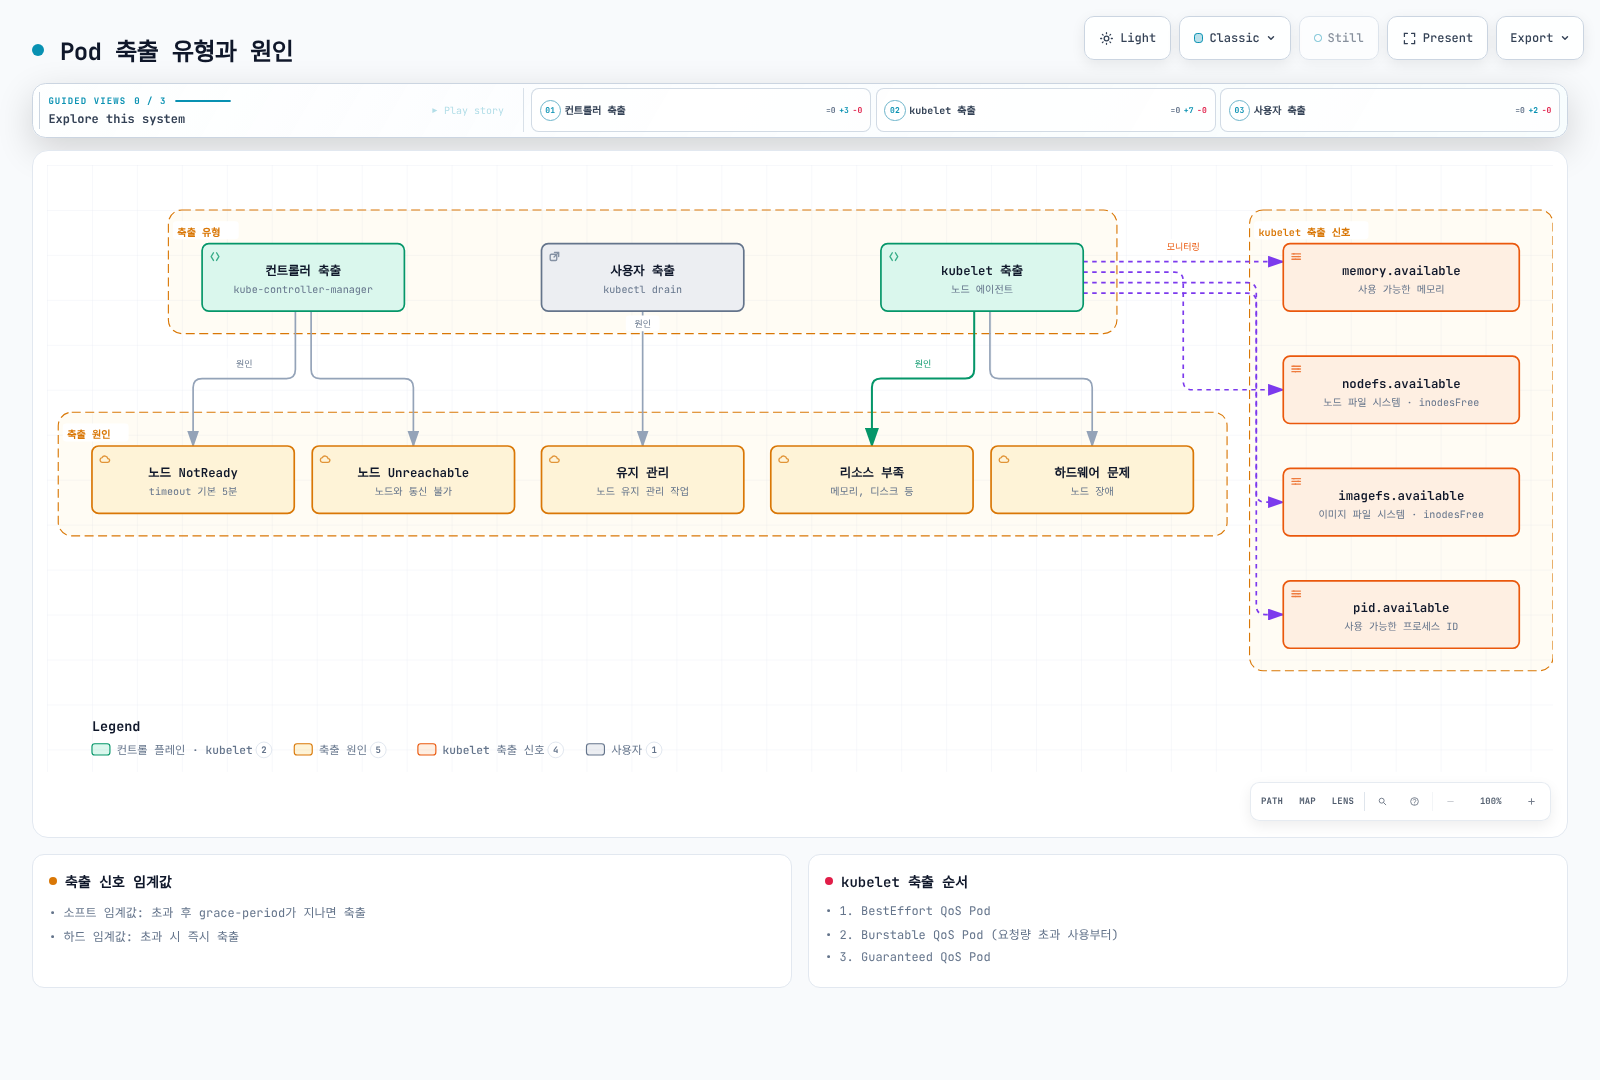
축출은 같은 파드를 이동시키는 것이 아니라 종료하는 작업입니다. 대체 여부는 컨트롤러, 용량, 스케줄링·스토리지 제약에 따라 달라집니다. 축출은 다양한 이유로 발생할 수 있습니다.
축출 유형
kube-controller-manager에 의한 축출:
- taint-eviction-controller가 NoExecute 테인트를 처리하며 일반 파드는 기본 not-ready/unreachable 톨러레이션 300초를 받음. 실제 축출 시점은 톨러레이션 설정에 따름
- 노드가 Unreachable 상태일 때
kubelet에 의한 축출:
- 노드 리소스 부족(메모리, 디스크 등)
- 하드웨어 장애는 노드 사용 불가로 이어질 수 있지만 일반적인 kubelet 압력 축출 신호는 아님
사용자에 의한 축출:
kubectl drain명령 실행- 노드 유지 관리 작업
kubelet 축출 신호
kubelet은 다음과 같은 축출 신호를 모니터링합니다:
- memory.available: 사용 가능한 메모리
- nodefs.available: 노드 파일 시스템의 사용 가능한 공간
- nodefs.inodesFree: 노드 파일 시스템의 사용 가능한 inode
- imagefs.available: 이미지 파일 시스템의 사용 가능한 공간
- imagefs.inodesFree: 이미지 파일 시스템의 사용 가능한 inode
- pid.available: 사용 가능한 프로세스 ID
각 신호에 대해 소프트 임계값과 하드 임계값을 설정할 수 있습니다:
- 소프트 임계값: 임계값을 초과하면
grace-period후에 포드 축출 - 하드 임계값: 임계값을 초과하면 즉시 포드 축출
# kubelet 구성 예시
evictionHard:
  memory.available: "100Mi"
  nodefs.available: "10%"
  nodefs.inodesFree: "5%"
  imagefs.available: "15%"
  imagefs.inodesFree: "5%"
evictionSoft:
  memory.available: "200Mi"
  nodefs.available: "15%"
evictionSoftGracePeriod:
  memory.available: "1m"
  nodefs.available: "2m"
evictionMaxPodGracePeriod: 30
evictionPressureTransitionPeriod: "30s"
축출 우선순위
kubelet은 요청 초과 사용 여부, 파드 우선순위, 요청 대비 사용량을 기준으로 대상을 정합니다. 모든 BestEffort → 모든 Burstable → 모든 Guaranteed라는 고정 순서는 아닙니다. 디스크·PID 압력은 리소스 계산도 다르므로 QoS를 보편적인 축출 순서로 해석하면 안 됩니다.
포드 중단 예산(PDB)
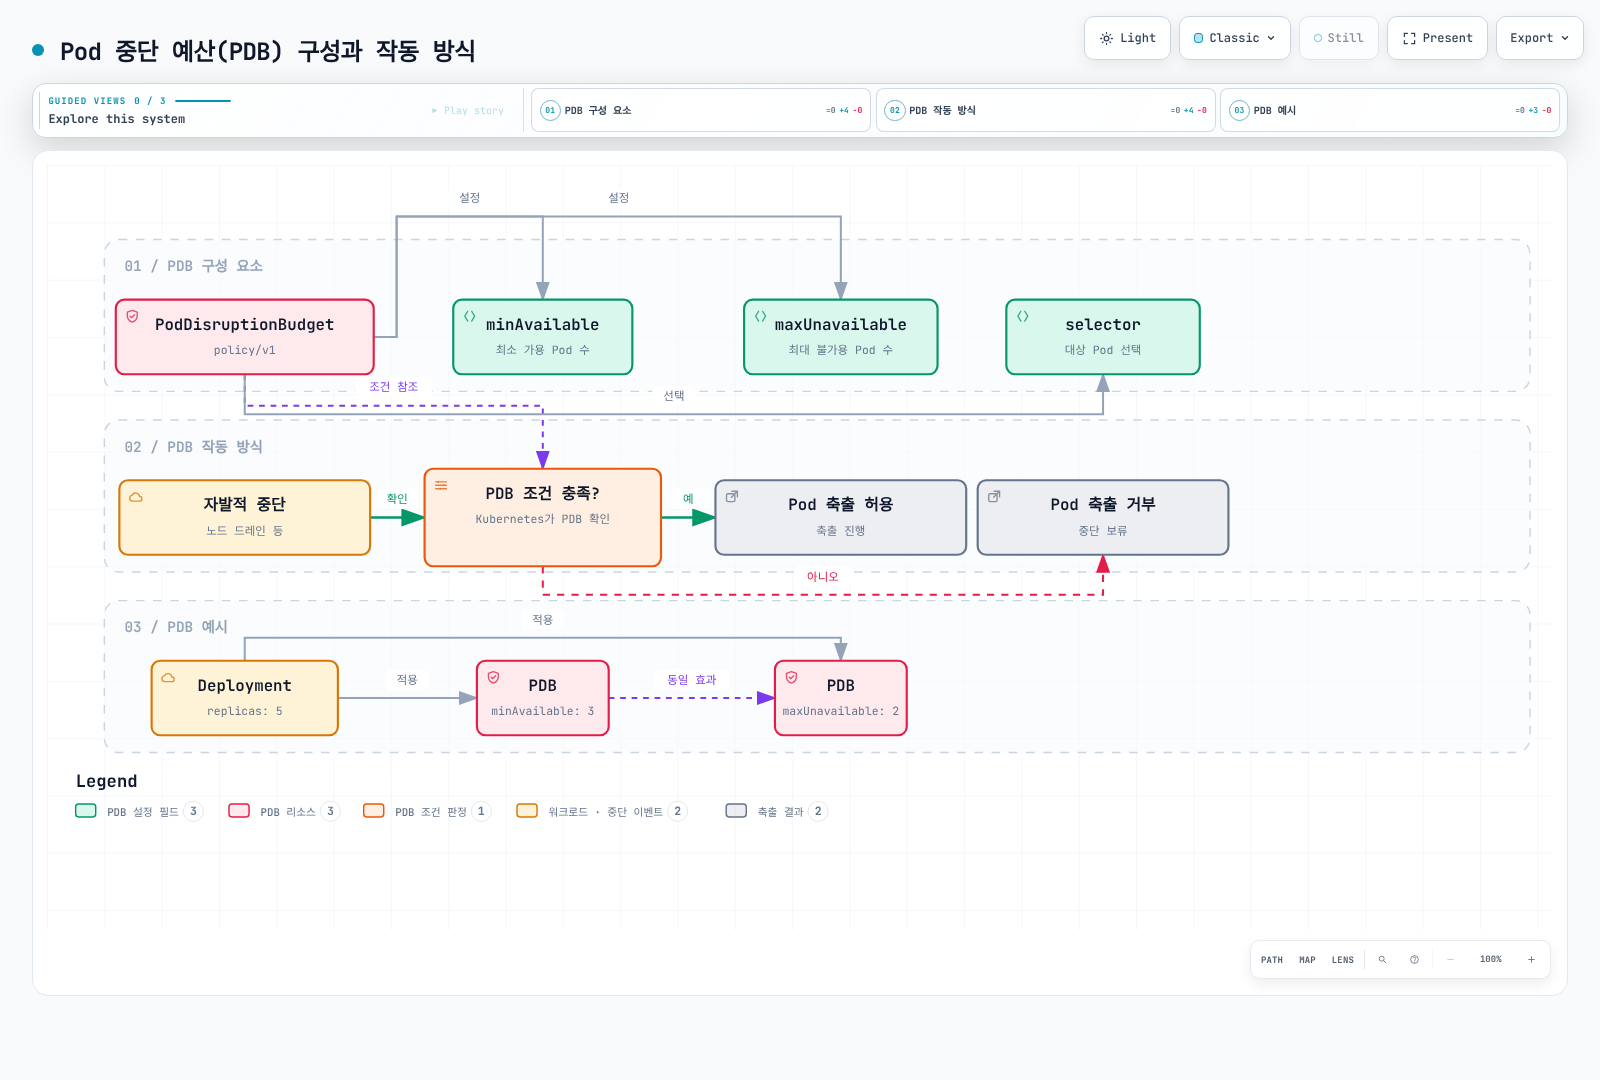
포드 중단 예산(Pod Disruption Budget, PDB)은 자발적 중단 중에도 애플리케이션의 가용성을 유지하기 위한 방법입니다. PDB는 동시에 중단될 수 있는 포드의 수를 제한합니다.
PDB 정의
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: frontend-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: frontend
또는
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: frontend-pdb
spec:
  maxUnavailable: 1
  selector:
    matchLabels:
      app: frontend
위 예시에서:
minAvailable: 항상 사용 가능해야 하는 최소 포드 수maxUnavailable: 동시에 사용 불가능할 수 있는 최대 포드 수selector: PDB가 적용될 포드를 선택하는 레이블 셀렉터
PDB 작동 방식
- 노드 드레인과 같은 자발적 중단이 발생하면, Kubernetes는 PDB를 확인
- PDB 조건을 충족하면 포드 축출 진행
- PDB 조건을 충족하지 않으면 포드 축출 거부
PDB는 일반 drain·descheduler 등의 Eviction API 요청을 제한합니다. 직접 파드 삭제, 컨트롤러 롤아웃, 노드 압력 축출은 이 검사를 우회합니다. minAvailable: 2와 maxUnavailable: 1은 원하는 복제본이 3개인 경우에만 같은 의미이며 대체 용량을 생성하지는 않습니다.
PDB 모범 사례
- 모든 중요한 워크로드에 PDB 설정: 고가용성이 필요한 모든 워크로드에 PDB 설정
- 적절한 값 선택: 워크로드 특성에 맞는
minAvailable또는maxUnavailable값 선택 - 레플리카 수 고려:
minAvailable을 복제본 수와 같게 설정해 자발적 축출을 막을 수 있지만 유지 관리가 정체될 수 있으므로 허용 중단 수를 의도적으로 정함 - 정기적인 테스트: 노드 드레인 등의 작업으로 PDB 작동 테스트
노드 압력 축출
노드 압력 축출(Node Pressure Eviction)은 노드의 리소스 부족으로 인해 포드가 축출되는 메커니즘입니다.
노드 상태 조건
kubelet은 다음과 같은 노드 상태 조건을 보고합니다:
- MemoryPressure: 노드의 메모리가 부족함
- DiskPressure: 노드의 디스크 공간이 부족함
- PIDPressure: 노드의 프로세스 ID가 부족함
이러한 조건이 발생하면 kubelet은 포드를 축출하여 리소스를 확보합니다.
축출 정책 구성
kubelet 구성에서 축출 정책을 설정할 수 있습니다:
# kubelet 구성 예시
evictionHard:
  memory.available: "100Mi"
  nodefs.available: "10%"
  nodefs.inodesFree: "5%"
  imagefs.available: "15%"
  imagefs.inodesFree: "5%"
evictionSoft:
  memory.available: "200Mi"
  nodefs.available: "15%"
evictionSoftGracePeriod:
  memory.available: "1m"
  nodefs.available: "2m"
evictionMinimumReclaim:
  memory.available: "50Mi"
  nodefs.available: "5%"
evictionMaxPodGracePeriod: 30
evictionPressureTransitionPeriod: "30s"
위 예시에서:
evictionMinimumReclaim: 축출 후 최소한으로 확보해야 할 리소스 양evictionPressureTransitionPeriod: 압력 상태 전환 사이의 대기 시간
토폴로지 분배 제약 조건(TopologySpreadConstraints)
토폴로지 분배 제약 조건은 포드를 클러스터의 여러 토폴로지 도메인(노드, 영역, 리전 등)에 균등하게 분산시키는 기능입니다. 이는 고가용성을 보장하고 장애 도메인의 영향을 최소화하는 데 유용합니다.
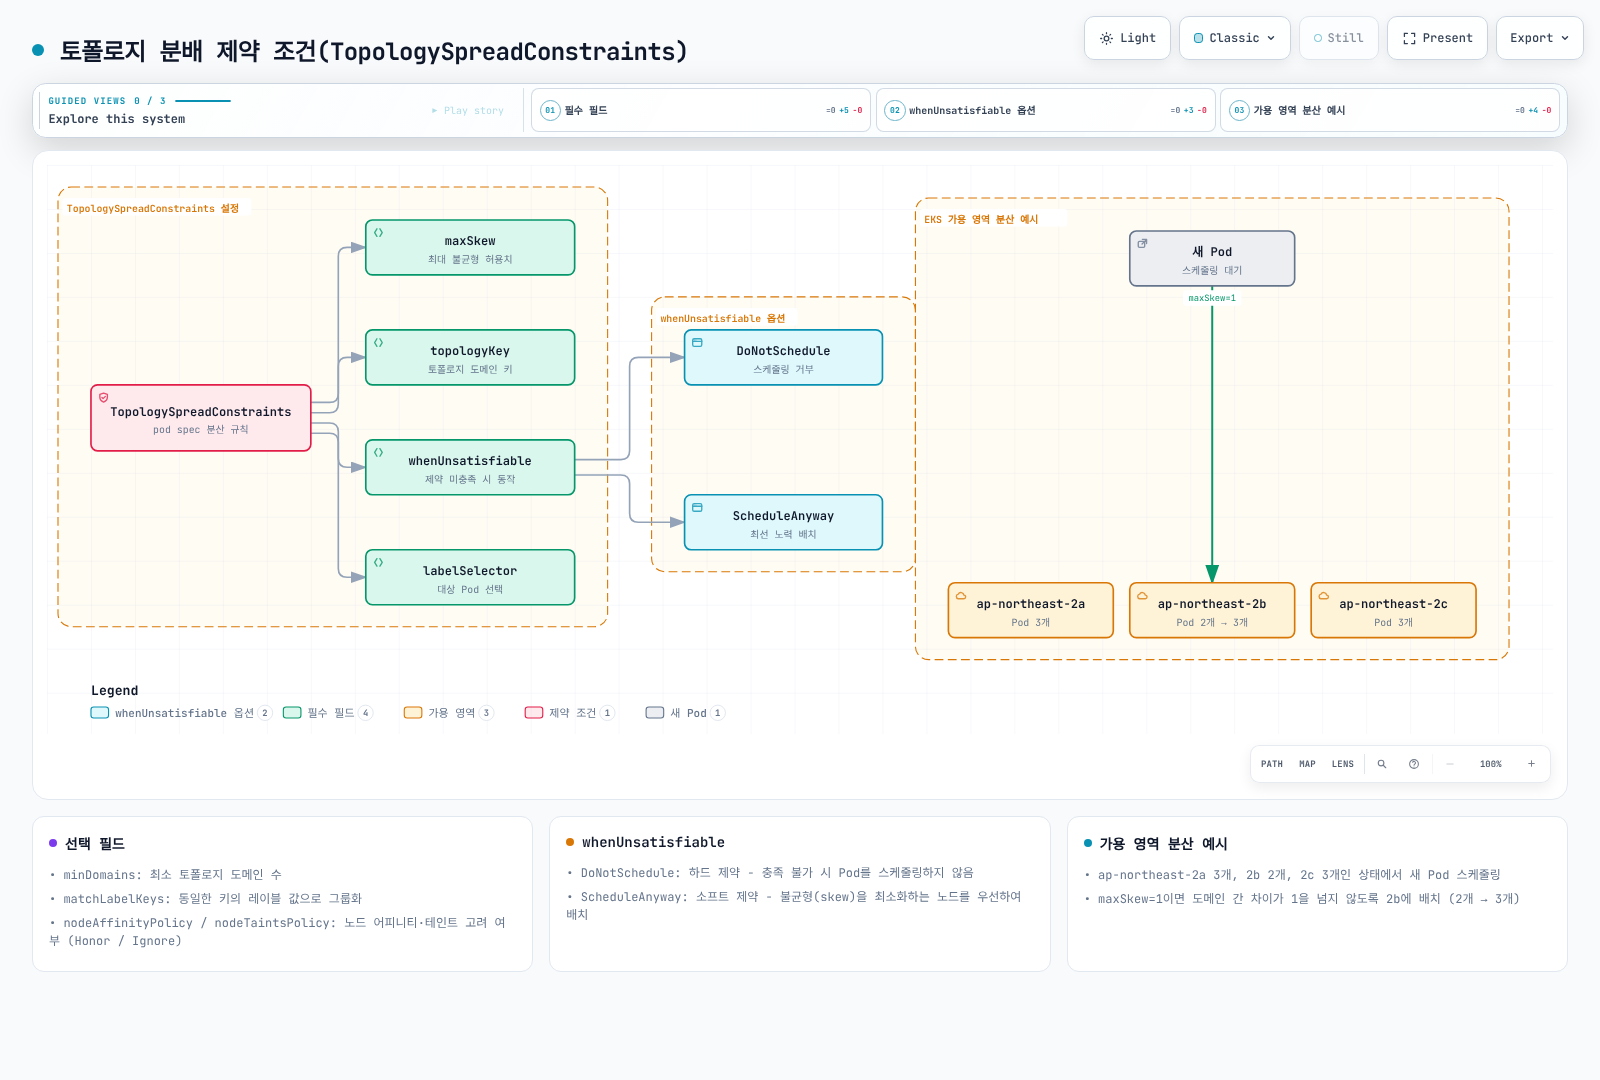
주요 필드 설명
| 필드 | 설명 | 필수 여부 |
|---|---|---|
| maxSkew | DoNotSchedule은 대상 도메인과 전역 최소값의 차이를 제한; ScheduleAnyway는 편차를 선호 점수에 반영 | 필수 |
| topologyKey | 토폴로지 도메인을 정의하는 노드 레이블 키 | 필수 |
| whenUnsatisfiable | 제약 조건을 충족할 수 없을 때 동작 (DoNotSchedule 또는 ScheduleAnyway) | 필수 |
| labelSelector | 계산할 파드 선택; 보통 자기 파드와 일치하도록 지정 | 선택 (null은 아무 파드도 선택하지 않음) |
| minDomains | 편차 계산을 위한 최소 적격 도메인 수 (v1.30부터 Stable) | 선택 |
| matchLabelKeys | 동일한 키의 레이블 값으로 그룹화 (Kubernetes 1.27+) | 선택 |
| nodeAffinityPolicy | 노드 어피니티/노드 셀렉터 고려 여부 (Kubernetes 1.26+) | 선택 |
| nodeTaintsPolicy | 노드 테인트 고려 여부 (Kubernetes 1.26+) | 선택 |
EKS 가용 영역 분산 예제
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
  namespace: production
spec:
  replicas: 6
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      topologySpreadConstraints:
      # 가용 영역 간 균등 분산 (하드 제약)
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: web
      # 노드 간 균등 분산 (소프트 제약)
      - maxSkew: 2
        topologyKey: kubernetes.io/hostname
        whenUnsatisfiable: ScheduleAnyway
        labelSelector:
          matchLabels:
            app: web
      containers:
      - name: web
        image: nginx:1.30.4
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
minDomains 사용 (v1.30부터 Stable)
minDomains보다 적격 도메인이 적으면 전역 최소값을 0으로 계산합니다. maxSkew: 1일 때도 적격 도메인별 첫 파드는 배치할 수 있으며 추가 파드가 Pending이 될 수 있습니다. 모든 파드를 즉시 차단하는 설정은 아닙니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: zone-spread-app
spec:
  replicas: 3
  selector:
    matchLabels:
      app: zone-spread
  template:
    metadata:
      labels:
        app: zone-spread
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        minDomains: 3  # 적격 도메인이 3개 미만이면 전역 최소값을 0으로 계산
        labelSelector:
          matchLabels:
            app: zone-spread
      containers:
      - name: app
        image: nginx
matchLabelKeys 사용 (Kubernetes 1.27+)
matchLabelKeys는 동일한 키의 레이블 값을 공유하는 포드끼리만 분산을 계산합니다. 이는 롤링 업데이트 시 새 버전과 이전 버전의 포드를 별도로 분산시키는 데 유용합니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: rolling-update-app
spec:
  replicas: 6
  selector:
    matchLabels:
      app: myapp
  template:
    metadata:
      labels:
        app: myapp
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: myapp
        matchLabelKeys:
        - pod-template-hash  # 같은 ReplicaSet의 포드끼리만 분산 계산
      containers:
      - name: app
        image: myapp:v2
Pod Anti-Affinity 대비 장점
| 특성 | TopologySpreadConstraints | Pod Anti-Affinity |
|---|---|---|
| 분산 수준 | 균등 분산 (maxSkew로 제어) | 완전 분리 또는 없음 |
| 유연성 | 높음 (허용 편차 지정 가능) | 낮음 (all-or-nothing) |
| 스케일링 | 확장 시에도 균등 분산 유지 | 노드 수에 제한됨 |
| 성능 | 효율적 | 포드 수 증가 시 성능 저하 |
| 권장 사용 | 일반적인 고가용성 배포 | 동일 노드 배치 완전 금지 시 |
# Anti-Affinity: 동일 노드에 절대 배치 불가 (레플리카 수 = 노드 수로 제한)
affinity:
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
    - labelSelector:
        matchLabels:
          app: web
      topologyKey: kubernetes.io/hostname

# TopologySpreadConstraints: 균등 분산 (더 유연함)
topologySpreadConstraints:
- maxSkew: 1
  topologyKey: kubernetes.io/hostname
  whenUnsatisfiable: DoNotSchedule
  labelSelector:
    matchLabels:
      app: web
Pod Deletion Cost
Pod Deletion Cost는 ReplicaSet 컨트롤러가 축소 시 사용하는 best-effort 선호값입니다. HPA는 원하는 복제본 수를 바꾸며 개별 삭제 파드를 직접 선택하지 않습니다. 이 어노테이션은 Job·StatefulSet을 보호하거나 축출을 막지 않으며 삭제 순서를 보장하지도 않습니다.
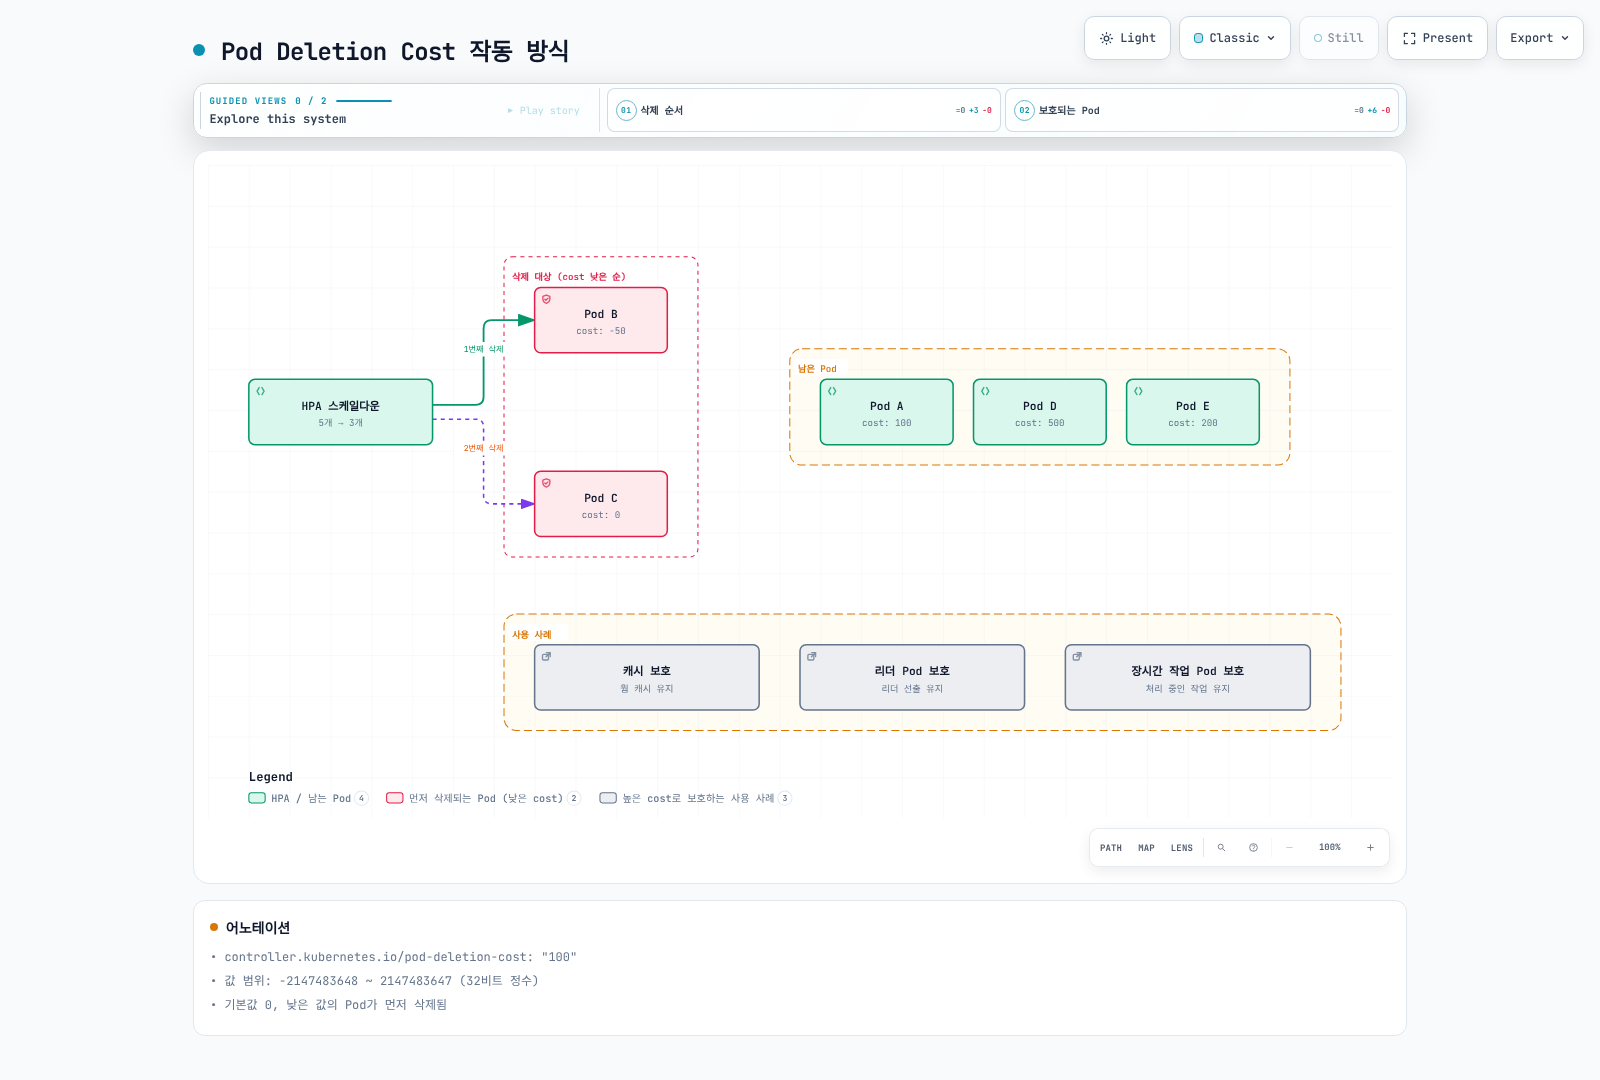
어노테이션 형식
metadata:
  annotations:
controller.kubernetes.io/pod-deletion-cost: "100"- 값 범위: -2147483648 ~ 2147483647 (32비트 정수)
- 기본값: 0 (어노테이션이 없는 경우)
- 동작: 낮은 값의 포드가 먼저 삭제됨
캐시 보호 패턴
CPU 사용률 HPA를 사용할 캐시는 명시적인 CPU 요청이 필요합니다. 아래는 스케줄링 예시이며 완전한 Redis 운영 구성이 아닙니다:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cache-service
spec:
  replicas: 3
  selector:
    matchLabels:
      app: cache
  template:
    metadata:
      labels:
        app: cache
    spec:
      automountServiceAccountToken: false
      containers:
      - name: cache
        image: redis:7
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
실제 캐시 상태를 측정한 뒤 권한 있는 운영자·컨트롤러가 축소 전에 선택한 ReplicaSet 소유 파드에 한 번 어노테이션을 설정할 수 있습니다:
kubectl -n default annotate pod "$CACHE_POD" \
controller.kubernetes.io/pod-deletion-cost="1000" --overwriteCACHE_POD는 실제 캐시 파드 이름으로 설정합니다. 잦은 어노테이션 변경은 API 부하를 만듭니다. 사용자 정의 갱신기는 Redis·Kubernetes 클라이언트와 좁은 Pod patch 권한이 필요하며 단순 시간 경과는 캐시 워밍업의 증거가 아닙니다. 이 예시는 갱신기를 설치하지 않습니다.
Job에는 적용되지 않음
Job 파드에 deletion-cost를 넣어도 보호되지 않습니다. 장시간 작업은 체크포인트, 재시도·멱등성, 정상 종료 처리를 설계하고 작업 특성에 맞게 중단 정책을 정하세요.
HPA와 함께 사용
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: cache-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: cache-service
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300
      policies:
      - type: Pods
        value: 1
        periodSeconds: 60
      # HPA가 복제본 수를 줄이면 ReplicaSet이 deletion cost를 선호값으로 고려
Descheduler
Descheduler는 실행 중인 클러스터에서 포드를 재분산시키는 도구입니다. 스케줄러는 새 포드를 배치할 때만 동작하지만, Descheduler는 이미 실행 중인 포드를 축출하여 더 나은 분산을 달성할 수 있습니다.
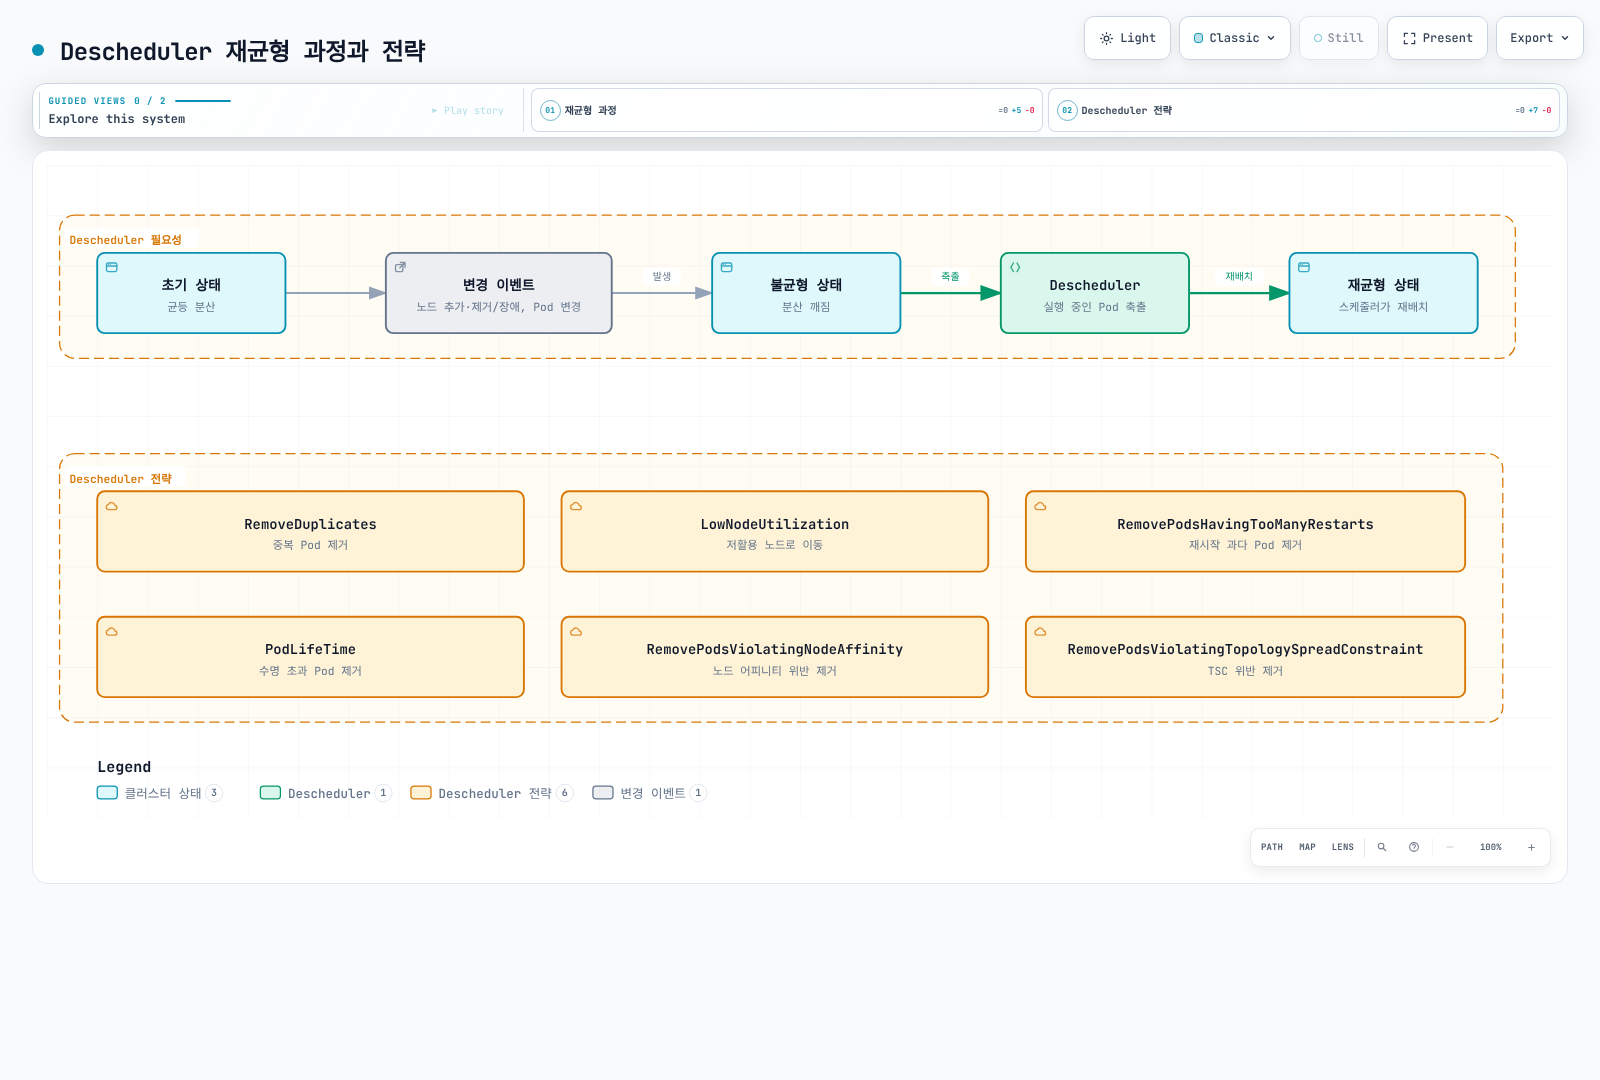
Helm을 사용한 설치
검증한 예시 릴리스는 Descheduler v0.36.0이며 Kubernetes v1.36과 이전 두 마이너 버전이 테스트 범위입니다. 다른 릴리스에는 호환성 표를 확인하세요. 검토한 schedule과 아래 정책의 profiles를 deschedulerPolicy.profiles 아래 넣어 descheduler-values.yaml로 저장합니다. 이전 strategies.*.enabled 값은 이 API를 구성하지 않습니다.
helm repo add descheduler https://kubernetes-sigs.github.io/descheduler/
helm upgrade --install descheduler descheduler/descheduler \
  --version 0.36.0 --namespace kube-system \
  --values descheduler-values.yaml
DeschedulerPolicy 설정
apiVersion: descheduler/v1alpha2
kind: DeschedulerPolicy
profiles:
- name: default
  pluginConfig:
  - name: DefaultEvictor
    args:
      nodeFit: true
  - name: RemoveDuplicates
    args:
      excludeOwnerKinds: [StatefulSet]
  - name: LowNodeUtilization
    args:
      thresholds:
        cpu: 20
        memory: 20
        pods: 20
      targetThresholds:
        cpu: 50
        memory: 50
        pods: 50
  - name: RemovePodsHavingTooManyRestarts
    args:
      podRestartThreshold: 100
      includingInitContainers: true
  - name: PodLifeTime
    args:
      maxPodLifeTimeSeconds: 86400
      labelSelector:
        matchLabels:
          app.kubernetes.io/lifecycle: ephemeral
  - name: RemovePodsViolatingNodeAffinity
    args:
      nodeAffinityType: [requiredDuringSchedulingIgnoredDuringExecution]
  - name: RemovePodsViolatingTopologySpreadConstraint
    args:
      constraints: [DoNotSchedule]
  plugins:
    balance:
      enabled:
      - RemoveDuplicates
      - LowNodeUtilization
      - RemovePodsViolatingTopologySpreadConstraint
    deschedule:
      enabled:
      - RemovePodsHavingTooManyRestarts
      - PodLifeTime
      - RemovePodsViolatingNodeAffinity
위 정책은 Descheduler 설정 파일이며 kubectl apply용 API 객체가 아닙니다. 그룹 재분배는 Balance, 파드별 결정은 Deschedule 플러그인을 사용합니다. LowNodeUtilization은 보통 실시간 CPU 사용률 대신 리소스 요청량을 평가하며 축출 후 다른 노드 배치를 보장하지 않습니다. 보호 설정을 검토하고 dry-run 검증 후 반복 축출을 활성화하세요.
Descheduler CronJob 설정
apiVersion: batch/v1
kind: CronJob
metadata:
  name: descheduler
  namespace: kube-system
spec:
  schedule: "*/30 * * * *"  # 30분마다 실행
  concurrencyPolicy: Forbid
  jobTemplate:
    spec:
      template:
        spec:
          serviceAccountName: descheduler
          containers:
          - name: descheduler
            image: registry.k8s.io/descheduler/descheduler:v0.36.0
            args:
            - --policy-config-file=/policy-dir/policy.yaml
            - --v=3
            volumeMounts:
            - name: policy-volume
              mountPath: /policy-dir
          restartPolicy: Never
          volumes:
          - name: policy-volume
            configMap:
              name: descheduler-policy
PDB 존중
Descheduler는 기본적으로 PodDisruptionBudget(PDB)을 존중합니다. PDB가 설정된 포드는 PDB 제한 내에서만 축출됩니다.
# PDB 설정 예시
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: web-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: web
---
# Descheduler가 이 PDB를 존중하여
# 허용 가능한 voluntary eviction만 진행 (장애 시 가용성 보장은 아님)
위 독립 CronJob은 Helm 설치와 중복 실행하지 않는 대안입니다. descheduler ServiceAccount·RBAC와 policy.yaml 키를 가진 descheduler-policy ConfigMap이 필요하므로 공식 차트·매니페스트로 선행 리소스를 구성하세요.
주의사항
- 시스템 포드 보호: 기본 critical Pod 보호를 전체 kube-system 제외와 혼동하지 말고 설치 버전의 DefaultEvictor와 선택 조건을 확인하세요.
- DaemonSet 포드: DaemonSet 포드는 축출되지 않습니다.
- 로컬 스토리지: 보호 여부는 DefaultEvictor·차트 값에 따라 달라지며 로컬 데이터 손실을 검토해야 합니다.
- PDB 제한: PDB 제한을 초과하여 포드를 축출하지 않습니다.
📚 심화 학습: 커스텀 스케줄러에 대한 자세한 내용은 다음을 참조하세요:
Amazon EKS에서의 스케줄링 최적화
Amazon EKS에서는 Kubernetes 스케줄링 기능을 활용하여 워크로드를 최적화할 수 있습니다.
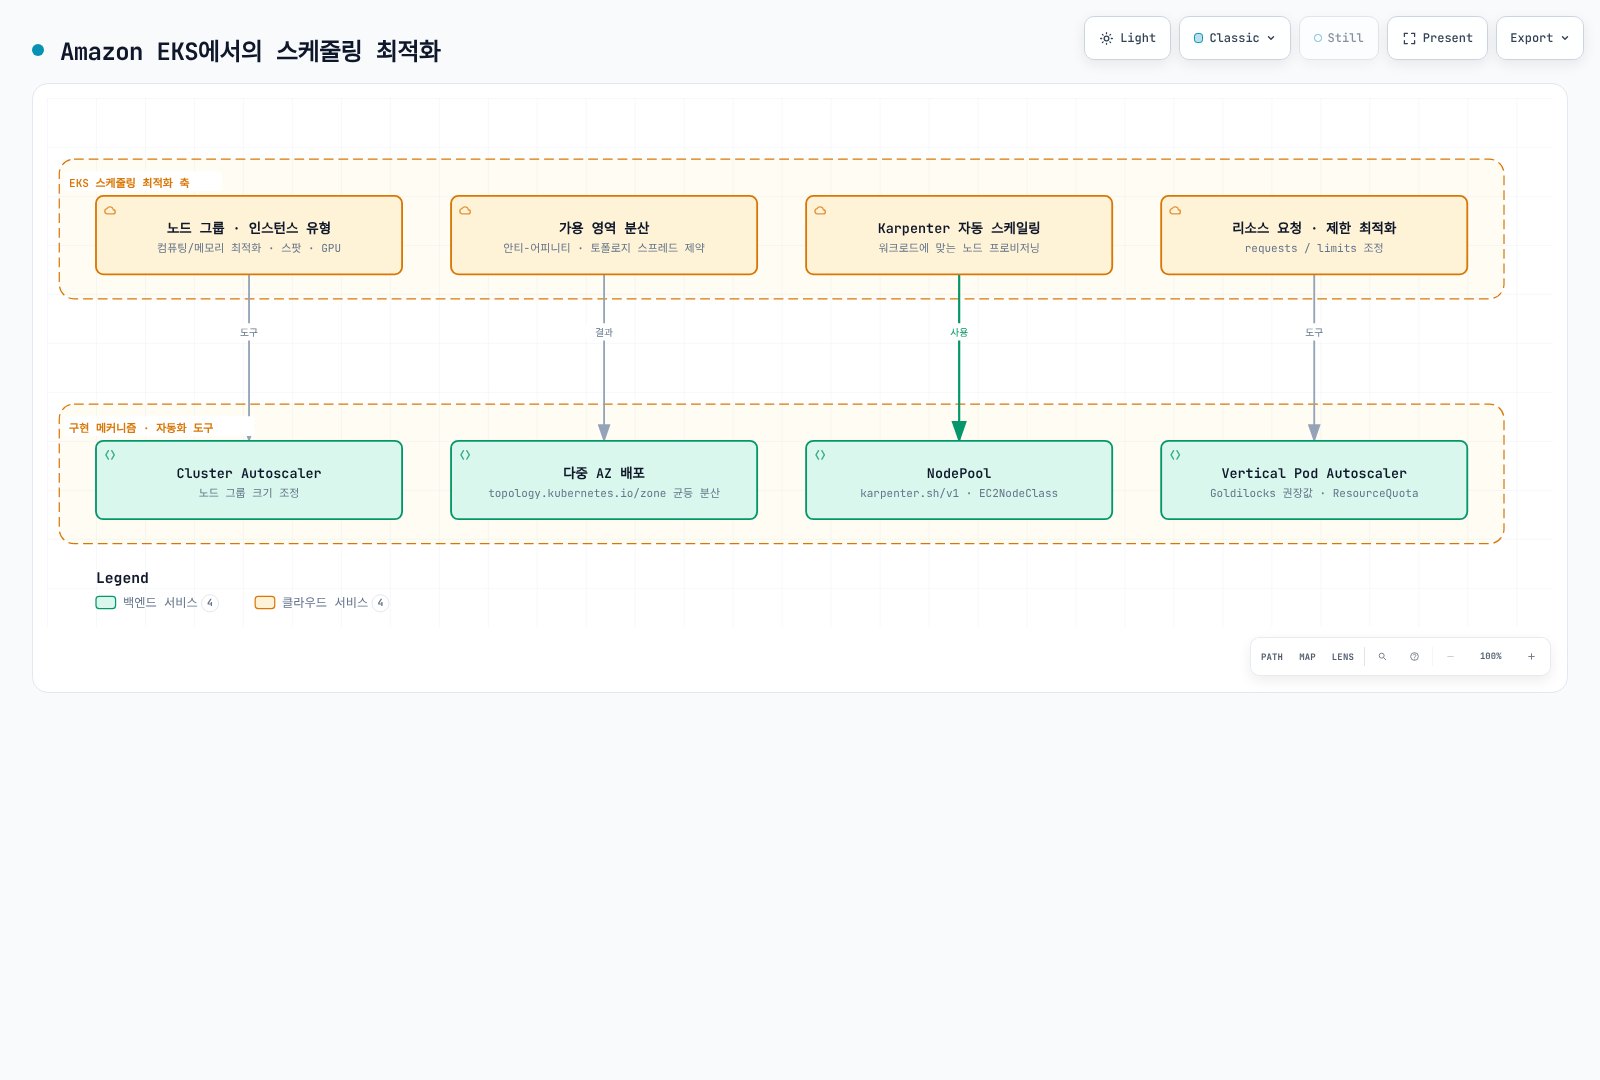
노드 그룹 및 인스턴스 유형
EKS에서는 다양한 노드 그룹과 인스턴스 유형을 활용하여 워크로드에 맞는 리소스를 제공할 수 있습니다:
- 다양한 인스턴스 유형: 컴퓨팅 최적화, 메모리 최적화, 스토리지 최적화 등
- 스팟 인스턴스: 비용 효율적인 워크로드를 위한 스팟 인스턴스
- GPU 인스턴스: AI/ML 워크로드를 위한 GPU 인스턴스
노드 레이블과 테인트를 사용하여 특정 워크로드를 특정 노드 그룹에 배치할 수 있습니다:
기존 클러스터와 리전, 지원 GPU 인스턴스·AMI, IAM 권한에 맞게 검토한 eksctl 구성을 사용하세요:
# gpu-nodegroup.yaml
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-cluster
  region: us-west-2
managedNodeGroups:
- name: gpu-nodes
  instanceType: p3.2xlarge
  desiredCapacity: 1
  privateNetworking: true
  labels:
    workload-type: gpu
  taints:
  - key: gpu
    value: "true"
effect: NoScheduleeksctl create nodegroup --config-file=gpu-nodegroup.yaml가용 영역 분산
EKS에서는 포드 안티-어피니티와 토폴로지 스프레드 제약 조건을 사용하여 워크로드를 여러 가용 영역에 분산시킬 수 있습니다:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: web
      containers:
      - name: web
        image: nginx
위 예시에서 topologySpreadConstraints는 포드를 여러 가용 영역에 균등하게 분산시킵니다.
Karpenter를 사용한 자동 스케일링
Amazon EKS에서는 Karpenter를 사용하여 워크로드에 맞는 노드를 자동으로 프로비저닝할 수 있습니다:
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot", "on-demand"]
        - key: kubernetes.io/arch
          operator: In
          values: ["amd64", "arm64"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default-class
  limits:
    cpu: 1000
    memory: 1000Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default-class
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
    - alias: al2023@latest
  subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
Karpenter는 포드의 리소스 요구 사항에 맞는 최적의 인스턴스 유형을 선택하여 비용을 최적화합니다.
리소스 요청 및 제한 최적화
EKS에서 워크로드의 리소스 요청과 제한을 최적화하는 것이 중요합니다:
- Vertical Pod Autoscaler(VPA): 워크로드의 실제 리소스 사용량을 기반으로 리소스 요청 최적화
- Goldilocks: VPA 권장 사항을 시각화하여 리소스 요청 최적화 지원
- 리소스 쿼터: 네임스페이스별 리소스 사용량 제한
# VPA 예시
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: frontend-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: frontend
  updatePolicy:
    updateMode: "Recreate"
스케줄링 모범 사례
Kubernetes 및 EKS에서 스케줄링을 최적화하기 위한 모범 사례:
적절한 리소스 요청 및 제한 설정:
- 워크로드의 실제 리소스 사용량을 기반으로 리소스 요청 설정
- 중요한 워크로드에 적절한 리소스 제한 설정
- VPA를 사용하여 리소스 요청 자동 최적화
워크로드 분산:
- 포드 안티-어피니티를 사용하여 중요한 워크로드를 여러 노드에 분산
- 토폴로지 스프레드 제약 조건을 사용하여 워크로드를 여러 가용 영역에 분산
- 노드 어피니티를 사용하여 특정 워크로드를 특정 노드에 배치
노드 리소스 최적화:
- 다양한 인스턴스 유형을 사용하여 워크로드에 맞는 리소스 제공
- 스팟 인스턴스를 사용하여 비용 최적화
- Karpenter를 사용하여 워크로드에 맞는 노드 자동 프로비저닝
PDB 설정:
- 중요한 워크로드에 PDB 설정
- 워크로드 특성에 맞는
minAvailable또는maxUnavailable값 선택 - 정기적으로 PDB 작동 테스트
우선순위 및 선점 설정:
- 중요한 워크로드에 높은 우선순위 클래스 설정
- 시스템 컴포넌트에
system-cluster-critical또는system-node-critical우선순위 클래스 사용 - 선점 영향 이해 및 테스트
노드 테인트 및 톨러레이션:
- 특수 워크로드를 위한 전용 노드 설정
- 유지 관리 중인 노드에 테인트 적용
- 적절한 톨러레이션 설정
결론
Kubernetes의 스케줄링, 선점 및 축출 메커니즘은 클러스터 리소스를 효율적으로 관리하고 워크로드의 가용성을 유지하는 데 중요한 역할을 합니다. 이러한 기능을 이해하고 활용함으로써 Amazon EKS 클러스터에서 워크로드를 최적화하고 안정적으로 운영할 수 있습니다.
스케줄링 최적화는 지속적인 과정이며, 워크로드 특성과 클러스터 상태에 따라 지속적으로 조정해야 합니다. 모니터링 도구를 활용하여 클러스터 리소스 사용량을 추적하고, 필요에 따라 스케줄링 정책을 조정하는 것이 중요합니다.
퀴즈
이 장에서 배운 내용을 테스트하려면 스케줄링, 선점 및 축출 퀴즈를 풀어보세요.