Ray on EKS 딥다이브
검토 기준: Ray 2.58.0, KubeRay v1.7.0 마지막 업데이트: 2026년 9월 12일
개요
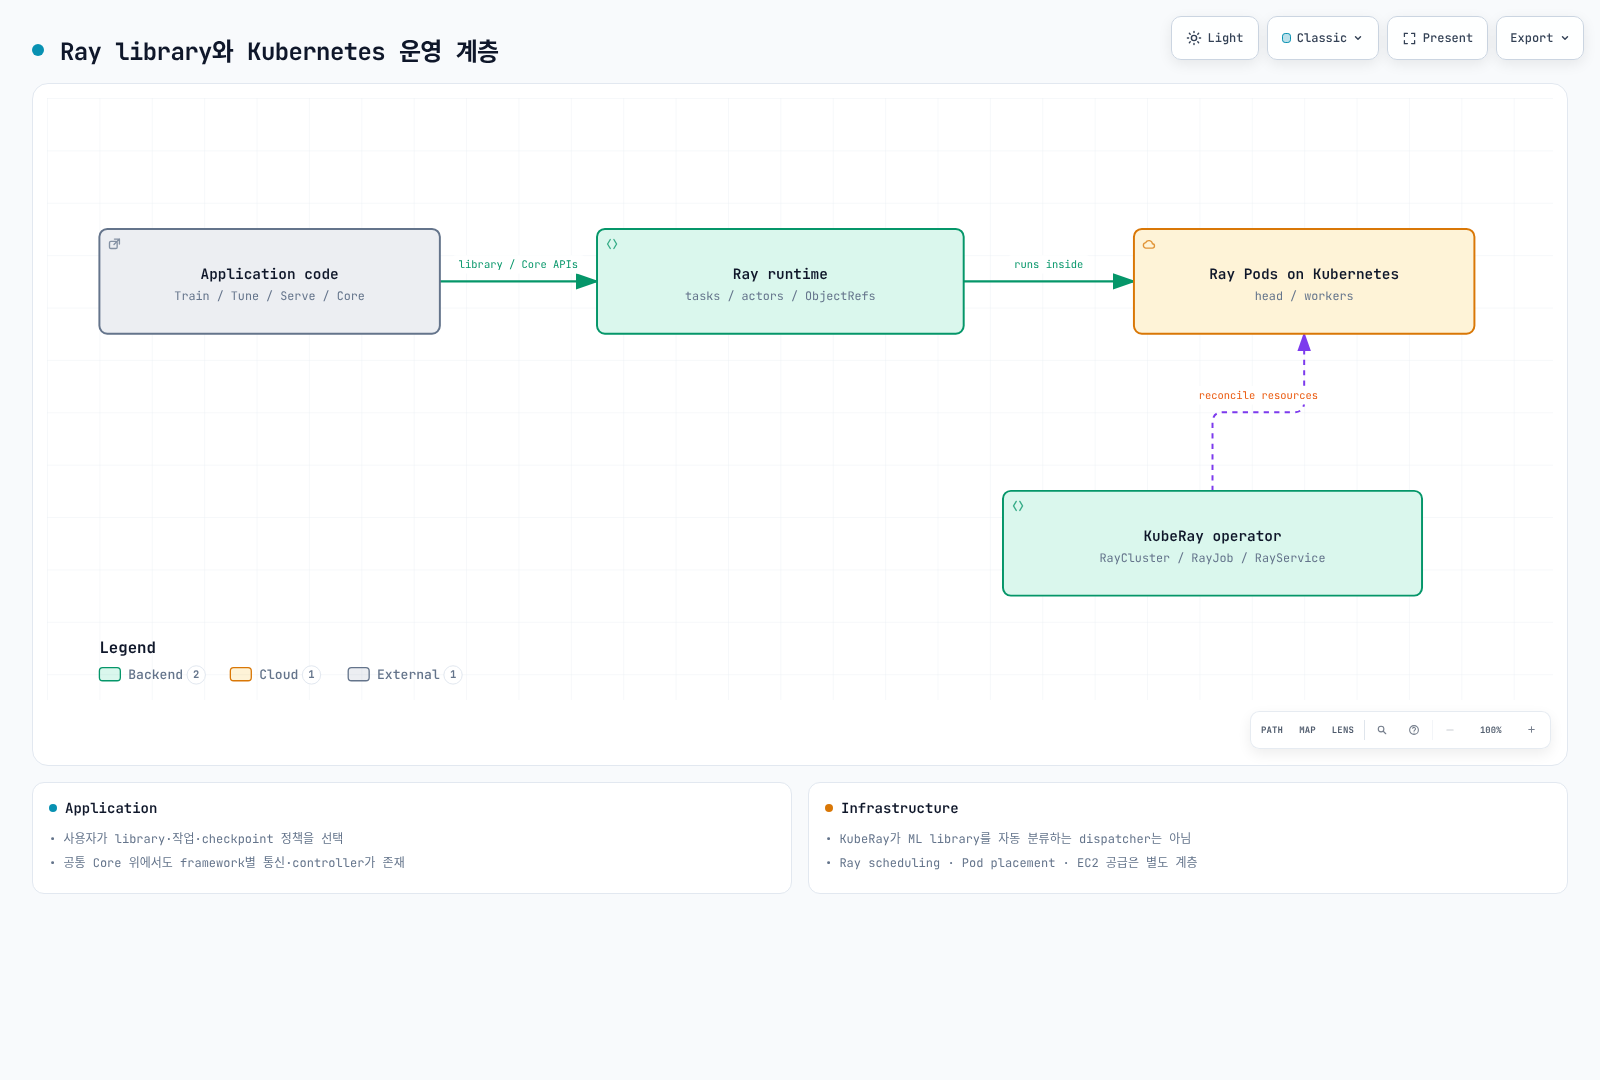
Ray는 task·actor·ObjectRef와 노드별 object store를 기반으로 Python 워크로드를 분산 실행합니다. Train·Tune·Serve는 이 기반을 사용하면서 각자의 학습·탐색·서빙 정책을 추가합니다. 모든 통신이나 장애 복구가 하나의 object-store 경로에서 자동 해결되는 것은 아닙니다.
KubeRay는 RayCluster/RayJob/RayService를 조정하는 Kubernetes operator입니다. 애플리케이션이 어떤 ML library를 사용할지 선택하는 dispatcher가 아니며, Ray 작업 scheduling·Kubernetes Pod placement·EC2 node provisioning도 서로 다른 계층입니다.
컴포넌트 맵
| 개념 | 해결하는 문제 | 심화 가이드 |
|---|---|---|
| Architecture | 나머지 모든 것이 기반으로 삼는 task, actor, 오브젝트 스토어 | Part 1 |
| KubeRay Operator | Ray 클러스터를 네이티브 Kubernetes 리소스(RayCluster/RayJob/RayService)로 운영 | Part 2 |
| Ray Train & Tune | 분산 모델 학습과 하이퍼파라미터 탐색 | Part 3 |
| Ray Serve | 모델 서빙, LLM 서빙 전용 빌딩 블록 포함 | Part 4 |
왜 EKS에서 운영하는가
트레이드오프는 이 문서 사이트의 다른 데이터/ML 섹션과 동일합니다. 이미 EKS를 운영 중인 팀은 Karpenter 기반 노드 풀 오토스케일링, IAM, 관측성 패턴을 Ray 워크로드에도 클러스터의 다른 워크로드와 동일하게 적용할 수 있는 대신, 관리형 대안을 쓰는 것보다 KubeRay 오퍼레이터와 RayCluster/RayJob/RayService 리소스를 직접 운영해야 하는 부담을 지게 됩니다.
이번 foundation 검증은 작은 단일 노드 Ray 실행입니다. GPU 학습, 다중 노드 장애 복구, 실제 EKS 설치나 autoscaling을 실행한 결과가 아닙니다.
현재 제공 중인 문서
- Part 1: Ray Architecture — task, actor, 오브젝트 스토어, head/worker 클러스터 모델
- Part 2: The KubeRay Operator — RayCluster, RayJob, RayService, Karpenter와의 2단계 오토스케일링 패턴
- Part 3: Ray Train and Ray Tune — 분산 학습과 하이퍼파라미터 튜닝
- Part 4: Ray Serve — 모델 서빙, Ray Serve LLM, RayService 기반 프로덕션 배포